
线上 AI 业务服务多次出现容器自动重启,研发人员反复重启实例始终无法根治,排查工作一度卡住。这类故障的第一步不是直接抓堆,而是先判断内存耗尽发生在 Java 层面还是容器层面,只有确认归属后才能选对后续排查路线。本次复盘的场景已确认属于 Java 堆溢出,而常规的堆转储分析在这种场景下并不好用:服务重启后运行时间短,泄漏对象的增量和占比都极小,快照里几乎看不出来。本文还原完整排查路径,重点讲两件事——如何快速区分 Java 堆 OOM 与 Pod 容器 OOM,以及面对微量泄漏时怎样用工两份 live 存活对象快照对比把问题挖出来,并附上一起第三方 SDK 静态引用导致泄漏的真实案例。(据腾讯云开发者社区披露的排查实录)
先分清两类 OOM:日志关键字与退出码是最快判据
线上 Java 容器崩溃通常跳不出两类,两者的表现形式、根本原因和排查方向差异很大,先分类再定位才不会白费工夫。
第一类是 Java 堆 OOM。日志中会出现 java.lang.OutOfMemoryError: Java heap space;业务日志本身就有崩溃报错;容器退出表现正常;JVM 监控上老年代占用呈现单边持续攀升,Full GC 跑完内存也降不下来;只要开启了自动 dump,JVM 会生成 hprof 快照;根本原因通常是代码里的强引用泄漏,或一次性把超大对象载入内存。现场可以检索业务日志匹配 Java heap space 字样。
第二类是 Pod 容器 OOM。业务侧没有任何崩溃报错日志;Pod 属于异常退出,退出码为 13,事件里标注 OOMKilled;JVM 的最大堆远小于 Pod 的内存限制,堆的使用率反而很平稳;不会产生堆文件,进程是被系统直接杀掉的;诱因多在堆外内存、线程栈或第三方原生缓冲区超限。现场做法是查看 Kubernetes 的 Pod 事件列表,检索 OOMKilled 与 exitCode=13。
本次故障的现场,业务日志恰好命中了 Java heap space,于是判定为 JVM 堆内泄漏,容器层超限的嫌疑被排除。
监控曲线佐证泄漏:老年代只涨不落
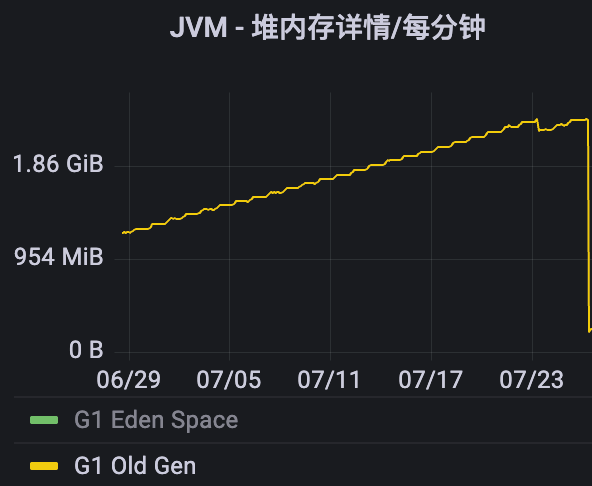
调出最近 30 天的 JVM 老年代监控,泄漏的典型形态一目了然:已用内存单向稳定上行;每次 Full GC 结束后占用没有明显回落;占用随运行时长线性走高;每次重启又会瞬间归零。这正是对象被永久强引用、GC 找不到回收入口、堆内对象只增不减的表现。
常规手段在这里遇到了瓶颈。服务重启后运行时间不长,泄漏累计的总量很有限,如果直接导出完整堆文件交给 MAT 分析,临时对象与长期存活对象难以区分,泄漏类占比太低,常规 dump 分析基本找不到方向。
双份 live 快照对比:不导大堆文件也能抓到增量
方案的核心在于 jmap -histo:live 这个参数:执行时它会主动触发一次 Full GC,只统计当下真正存活、被强引用的对象,顺带把临时创建、可回收的短命对象过滤掉。隔 24 小时各采集一份快照,把两份文件里各类对象的实例数与内存占用增长量做对比,涨幅居前的类就是泄漏嫌疑对象。整个过程不需要导出动辄几十 GB 的堆文件,在线上低峰期执行对业务影响很小。
标准操作分三步:服务重启、流量平稳后采集第一份基线快照;业务正常运行满 24 小时后采集第二份;用文本比对两份结果,挑出实例数量和堆内存同步大幅增长的类作为可疑对象。
本次对比结果非常清晰:java.util.logging.ConsoleHandler 增加 5536 个实例、涨幅 104%;java.io.OutputStreamWriter 增加 5536 个、涨幅 98%;sun.nio.cs.StreamEncoder 增加 5536 个;sun.nio.cs.UTF_8$Encoder 同样增加 5536 个、约 104%;java.nio.HeapByteBuffer 增加 5544 个、98%。新增量合计 5500 多套 IO 链路对象,约吃掉 43MB 堆内存,与监控上观察到的上涨幅度、byte 数组的涨幅都对得上,泄漏矛头指向 ConsoleHandler。
顺着引用链找根因:静态 Logger 累积 Handler
对象的完整引用链如下:ConsoleHandler 指向 ErrorManager,再到 SimpleFormatter,接 OutputStreamWriter,再到 StreamEncoder、UTF-8 编码器、HeapByteBuffer,最后落在 byte[] 字节数组上。整条 IO 对象链被永久强引用,GC 无从回收。
问题出在第三方 SDK 的源码上。它用 private static final 定义了一个 Logger,生命周期与整个 JVM 进程一致;而 HttpClient 的构造函数里,每次实例化都会新建一个 ConsoleHandler 并 addHandler 挂到那个静态 Logger 上,却没有任何移除逻辑。业务侧原始代码则是每次 AI 接口调用都执行一次 new ComponentClient(),方法里没有复用机制。于是链路变成:组件客户端新建、内部初始化 HttpClient、不断创建 Console 处理器挂到静态日志对象上、IO 对象长期驻留堆内,接口调得越多内存涨得越快。
另有一条值得对照的写法也出现在原文分析中:构造函数若能区分条件补充 FileHandler,但与主问题无关。真正致命的是静态 Logger 只进不出。
修复与验证:单例复用稳定内存曲线
由于 SDK 源码无法改动,业务侧的思路是把客户端收敛为单例:用双重检查锁在全局只初始化一次 ComponentClient,业务调用入口统一走同一个实例,从源头堵住新增 Handler 的路径。改动落在业务封装层。调整后不再高频创建客户端,ConsoleHandler 也就没有继续累积的机会。
验证方式分为两步:本地循环压测 AI 接口上千次,采集 histo 快照,ConsoleHandler 实例数保持稳定;上线后连续观测 JVM 老年代 3 天,内存不再单向上行,Full GC 后能够正常回落,越界崩溃不再出现。
给使用第三方 SDK 的开发者的两条经验
经验一,查崩溃先分类:检索 Java heap space 判断是否为堆溢出,检索 OOMKilled、exitCode=13 判断是否为容器杀进程。两类问题的优化手段和排查工具截然不同,混淆方向会消耗大量时间。
经验二,小幅缓慢泄漏可用双 histo 快照对比:适用于泄漏极轻微、短时间 dump 看不出异样、以及来源于静态对象或第三方 SDK 的场景。它的好处是不依赖超大堆文件、低峰执行影响小;核心逻辑是利用 live 快照强制 Full GC 过滤瞬态对象,隔一天看增量,把存在持续增长的对象圈出来。
原文还给出开发层面的告诫:选第三方 SDK 时要摸清核心 Client 类的生命周期,不能直接抄 demo。多数官方示例都是 main 方法跑一次就退出,没人会暴露长期堆积累的问题;若把这套写法搬进 HTTP 接口、定时任务或循环体,每次调用 new 一个 Client,而底层处处挂着静态的 Logger、全局监听器与连接容器,每 new 一次就多加一份且没有释放接口,内存泄漏只是时间问题。
小结:这次排查的价值在于先后顺序——先用日志与退出码切分堆 OOM 与容器 OOM,再用每隔 24 小时一次的 jmap -histo:live 对比锁定增量对象,能把微小泄漏从短命对象中隔离出来。第三方 SDK 每次 new 客户端向静态 Logger 无限挂 Handler 是比较常见的坑,单例化调用入口即可根治,上线后观测 3 天常驻内存已趋于平稳。