2026年9月18日前后,智谱AI(Z.ai)在其API与体验中心上线了GLM-5.3-FlashX。这一条目并非全新的底座模型,而是对先前已开源的GLM-5.3-Flash增设的"高速推理档":底层能力保持一致,把生成速度提升至峰值约200 tokens/s。更值得关注的看点并不在模型本身——该速度依托约10万张国产AI加速器从头搭建的推理栈,端到端吞吐相较同硬件的初始基线提升约3倍,单token成本已经接近英伟达GPU的经济区间。
本文围绕三个问题展开:FlashX的定位是什么、10万张国产卡交出了怎样的成绩单、价格与本地部署应当如何取舍。所引数据出自智谱官方定价页、智谱工程博客以及多方报道,口径为2026年9月。
FlashX不是新底座,而是GLM-5.3-Flash的高速推理档
先划清一条界线:GLM-5.3-FlashX属于GLM-5.3-Flash家族的高速推理档(serving tier),没有经历重新训练。其底层权重仍为8月26日开源的那一套GLM-5.3-Flash——320B总参数、每token仅激活18B的MoE结构,原生支持多模态,上下文为1M,采用MIT协议可商用。FlashX所做的工作,是在同一底座上让推理服务交付得更快、更稳定。
底座的架构设计值得一提:采用混合稀疏注意力与线性注意力(mHC),借助IndexPool把4个缓存索引key压缩为1个。智谱方面表示,相对GLM-5.3,注意力算力下降约3.0倍,KV缓存下降约4.4倍。这些被节省下来的算力,正是FlashX能够把出字速度推高的基础。
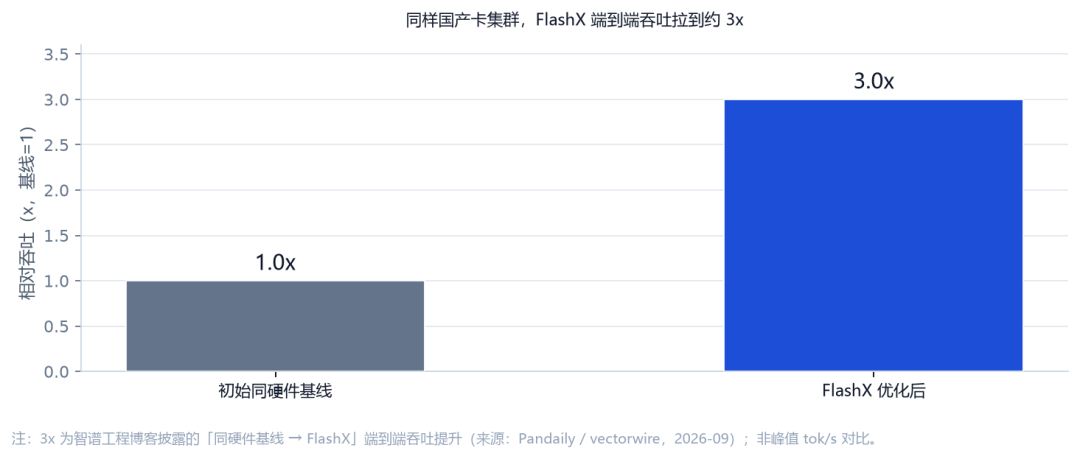
按智谱工程博客2026年9月的说法,在同样的国产卡集群上,FlashX的端到端吞吐约为初始基线的3倍。可以这样记:FlashX等于同一套开源底座加上国产卡上的高速推理栈,模型能力未发生改变,变化的是输出速度与单token成本。
核心参数速览:320B总参数、18B激活、约1M上下文
官方模型卡与博客给出了底座侧信息,智谱官方定价页给出了服务档信息。上线时间为2026年9月18日前后,入口在API与体验中心。产品定位是GLM-5.3-Flash的高速推理档,并非新底座。
底座部分:320B总参数、18B激活的MoE,采用稀疏与线性注意力;上下文长度1,048,576 tokens(约1M);原生多模态,支持文本、图片、视频、文件输入;许可协议为MIT可商用,FlashX本身是托管推理档。
服务档部分:Z.ai宣称峰值约200 tokens/s,该数值尚未经独立验证;同硬件基线约3倍端到端吞吐;价格为输入2元、输出7元每百万tokens。
其中有两点需要特别提示。其一,"峰值200 tokens/s"当前属于Z.ai的宣称值,独立团队还没有给出可复现的基准;在单端点实测中,底座Flash于部分服务商处曾达到约250 tok/s。因此更谨慎的理解是,FlashX的卖点在于能在国产卡集群上稳定交付Flash级速度,而不是单纯比较峰值高低。其二,底座以MIT协议开源,而FlashX是托管档,若要求完全私有化、数据不外流,需要采用开源底座自行部署。
10万张国产卡的答卷:把成本墙向外推
整件事里最值钱的并非模型,而是底座之外的推理基础设施。智谱在约10万张国产AI加速器上从零搭建了一套生产级推理栈,过程中需要应对单芯片显存与带宽受限、底层kernel不完整、并且还要承载多模态长上下文流量等硬性制约。
工程博客披露的手段相当具体:张量并行、ReplaySSM、W8A8量化、INT8/FP8/BF16混合缓存量化、Layer Split,以及Encode–Prefill–Decode disaggregated三段分离架构。据此得出的结果是与同硬件基线相比约3倍的端到端吞吐,单token成本逼近英伟达GPU的经济区间——对于"国产卡能否跑出性价比"这一问题,这构成了关键回应。
其中传播更广的一环是Infra Agent:这是一个由GLM-5.3驱动的智能体,工程师负责设定目标并评审关键改动,智能体则在正确性测试、链路追踪与端到端指标的密集反馈下,提出kernel patch与服务栈修改建议。相当于让模型参与优化运行模型所依赖的系统,是把递归式自我改进从口号带进产线的实例。
需要提醒的是,3倍吞吐与"逼近英伟达成本"这两项目前都源出自智谱自家基准,建议后续补上独立复现;在把200 tok/s当作稳定SLA之前,应先用自身业务流量画像实测一遍首token延迟与长尾表现。
价格分三档:为速度多付约2.5倍,较旗舰低约4倍
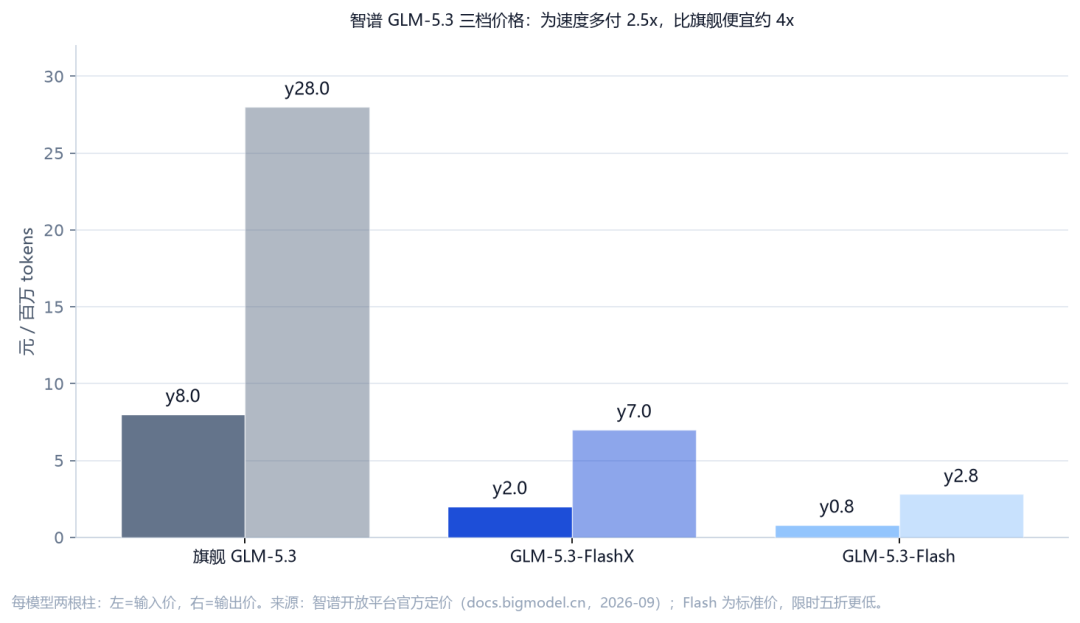
智谱把GLM-5.3家族拆分为三档,价格均取自官方定价页,单位为元每百万tokens。旗舰GLM-5.3为输入8、输出28;FlashX为输入2、输出7;Flash标准价为输入0.8、输出2.8,限时五折时更低。
换算关系比较透明:相比底座Flash,FlashX的输入与输出价格都约为2.5倍,这笔溢价买单购买的是更低的延迟;相比旗舰,又要便宜约4倍。选型思路因此也清晰——高并发Agent、交互式助手、实时生成这类"等得越久越亏"的场景适合上FlashX;离线批处理、海量低成本调用则用Flash更具经济性。调用上兼容OpenAI接口,model字段填"glm-5.3-flashx",base_url为智谱开放平台地址;具体模型名以官方当前文档为准,FlashX属API托管档,需要联网调用。
评测与实际部署:能力接近Opus 4.8档,短板仍需留意
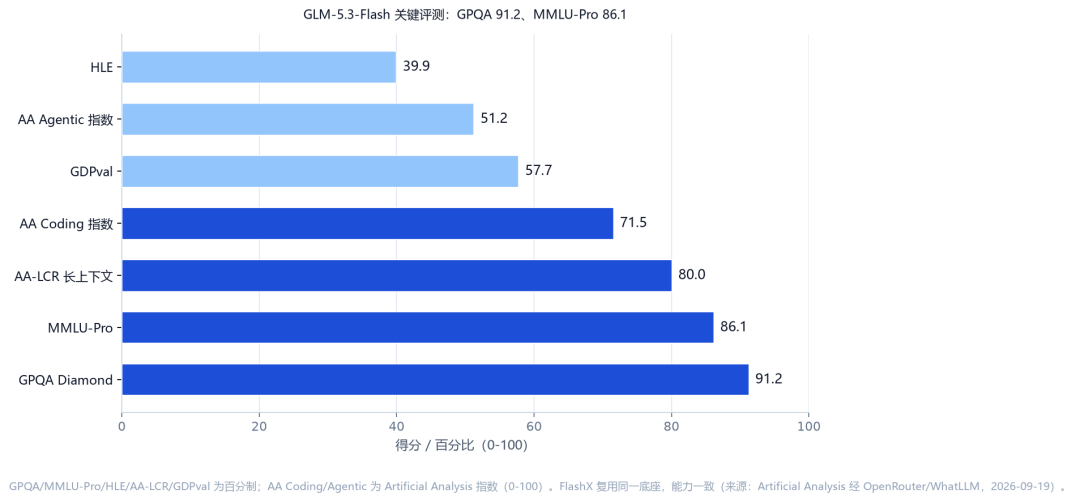
在Artificial Analysis上,底座GLM-5.3-Flash的成绩可用于判断能力水平——FlashX复用同一底座,因此能力一致。GPQA Diamond为91.2%,MMLU-Pro为86.1%,综合处于接近Claude Opus 4.8的一档;编码与智能体指数在开源权重模型中也位居前列(数据经OpenRouter/WhatLLM,日期为2026-09-19)。
把底座装进本地机器同样可行,原因就在于它是MIT开源。官方与社区提供的路径有多条:一是用Ollama执行"ollama run glm5.3-flash"拉取量化版本;二是用vLLM启动OpenAI兼容服务,命令为"vllm serve zai-org/GLM-5.3-Flash"。全量FP8约328 GB,个人机器一般使用INT4量化搭配RTX 4090(24GB)运行。需要强调,这部署的是底座,FlashX的高速档并未放进开源权重,必须通过API获取。
短板也要讲在前面:200 tok/s属于厂商标称,尚未获得独立复现;相关评测多为智谱自有口径,第三方完整复现依然有限;且FlashX为托管档,对数据不出门有强诉求的用户只能靠开源底座自行部署。另外它与Flash"同智不同速",不必期待FlashX在难题上比底座表现得更聪明。
小结:GLM-5.3-FlashX把"国产卡上的高速推理"正式做成一档公开服务,底座开源且能力接近Opus 4.8档,速度档约200 tok/s、成本接近英伟达GPU。为延迟买单可选它,为成本买单仍推荐Flash;投产之前,务必用自己的真实负载复核首token延迟与长尾,切勿把200 tok/s直接视为SLA。