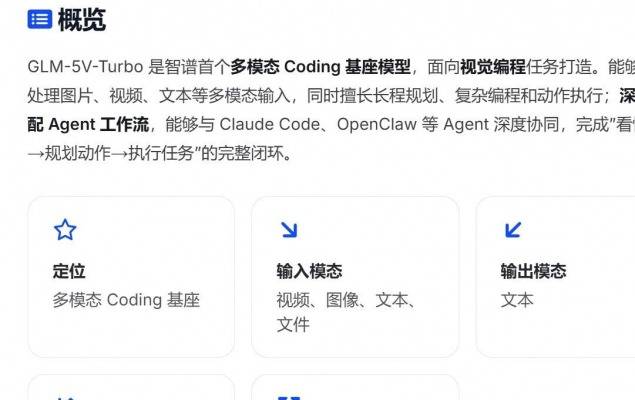
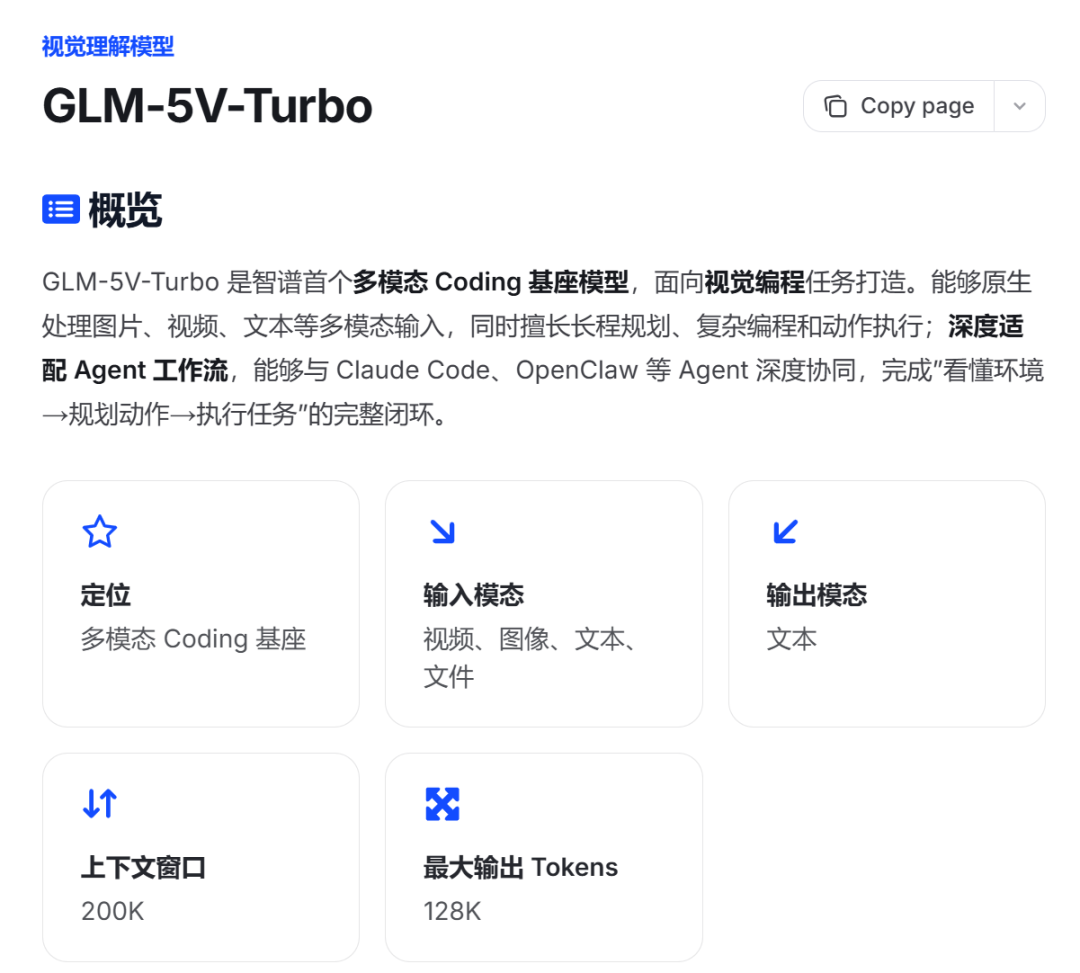
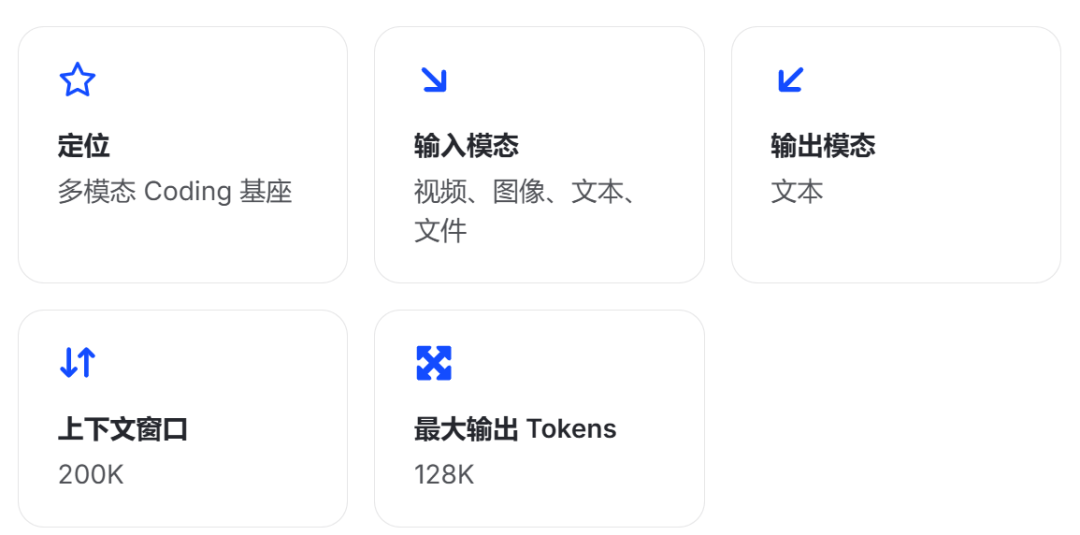
4月2日,智谱对外发布全新模型GLM-5V-Turbo,官方将其定义为智谱首款多模态Coding基座模型。该模型面向视觉编程场景构建,原生具备图像、视频、文本和文件四种输入能力,上下文窗口为200K,最大输出长度128K,并突出与Claude Code、OpenClaw等Agent工作流之间的协同能力。
与以往一些模型更新仅停留在参数表变化不同,GLM-5V-Turbo更值得关注的地方,是智谱开始把视觉输入直接纳入Coding和Agent任务的执行链条。模型不再局限于读取提示词并输出代码,而是尝试理解设计稿、网页、图表与屏幕画面,再据此规划后续操作、调用工具,推动任务向完成方向演进。
带眼睛的Coding模型:从看图问答走向任务执行
放到当前模型谱系中观察,GLM-5V-Turbo更像一个具备视觉感知能力的代码模型。按照官方文档的表述,其能力关键词集中在几个方面:同时兼顾视觉理解与Coding,复杂视觉推理准确度提高,GUI Agent与Coding Agent表现得到强化,多模态工具链得到扩展。它所提供的能力并非零散单点,而是一组面向任务执行的配套配置,涵盖思考模式开关、流式输出、Function Call以及上下文缓存。
过去所说的多模态模型,通常指可以看图、描述画面、完成问答;而代码模型的重点多在补全代码、修复缺陷、解答算法题。GLM-5V-Turbo切向的是介于两者之间、难度更高的区域:视觉理解、编程能力、工具调用与长链路执行叠加。从官方给出的能力框架来看,智谱并不满足于让模型停留在能够识图的对话窗口中,而是朝更完整的Agent执行器方向推进。
规格与协同:200K上下文面向长任务设计
具体规格上,GLM-5V-Turbo对视频、图像、文本和文件均可输入,上下文达到200K,最大输出128K。这一配置已不太像轻量的视觉问答模型,而更接近为长任务准备的底座。在实际使用中,200K上下文的价值较为直接:模型有足够空间同时容纳更长的页面结构、更多轮工具返回结果以及更多任务历史,继而继续执行后续步骤。
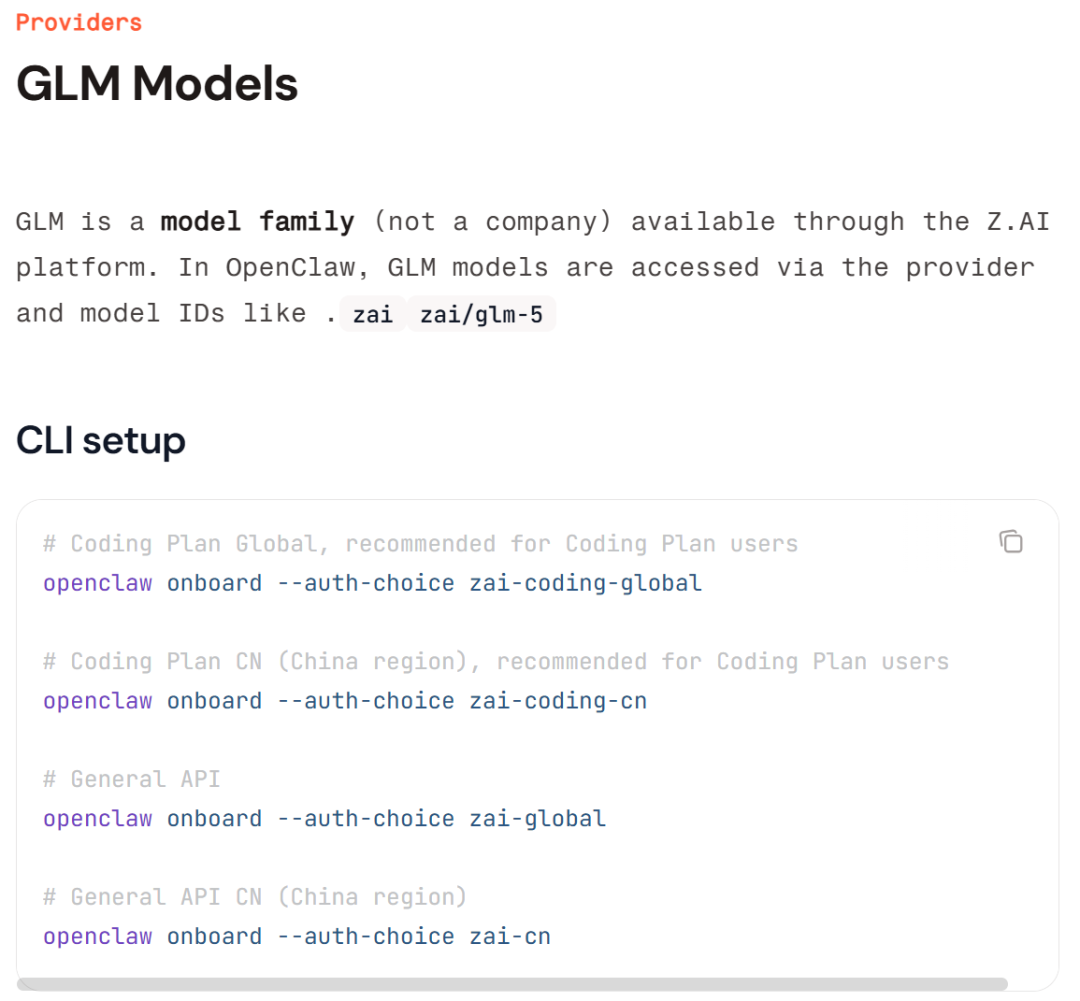
同样重要的是,智谱并未将该模型塑造为只能在自家页面演示的产品。官方文档明确指出,GLM-5V-Turbo能够与Claude Code、OpenClaw等Agent深度协同;在OpenClaw的文档中,也已列出glm-5v-turbo这一可用模型版本。这一动作比简单宣称“支持Agent”更为具体,说明智谱的目标是让模型进入开发者已经在使用的工作流,而非单独搭建演示环境。
强项任务:视觉编程、GUI Agent与纯文本Coding三线并进
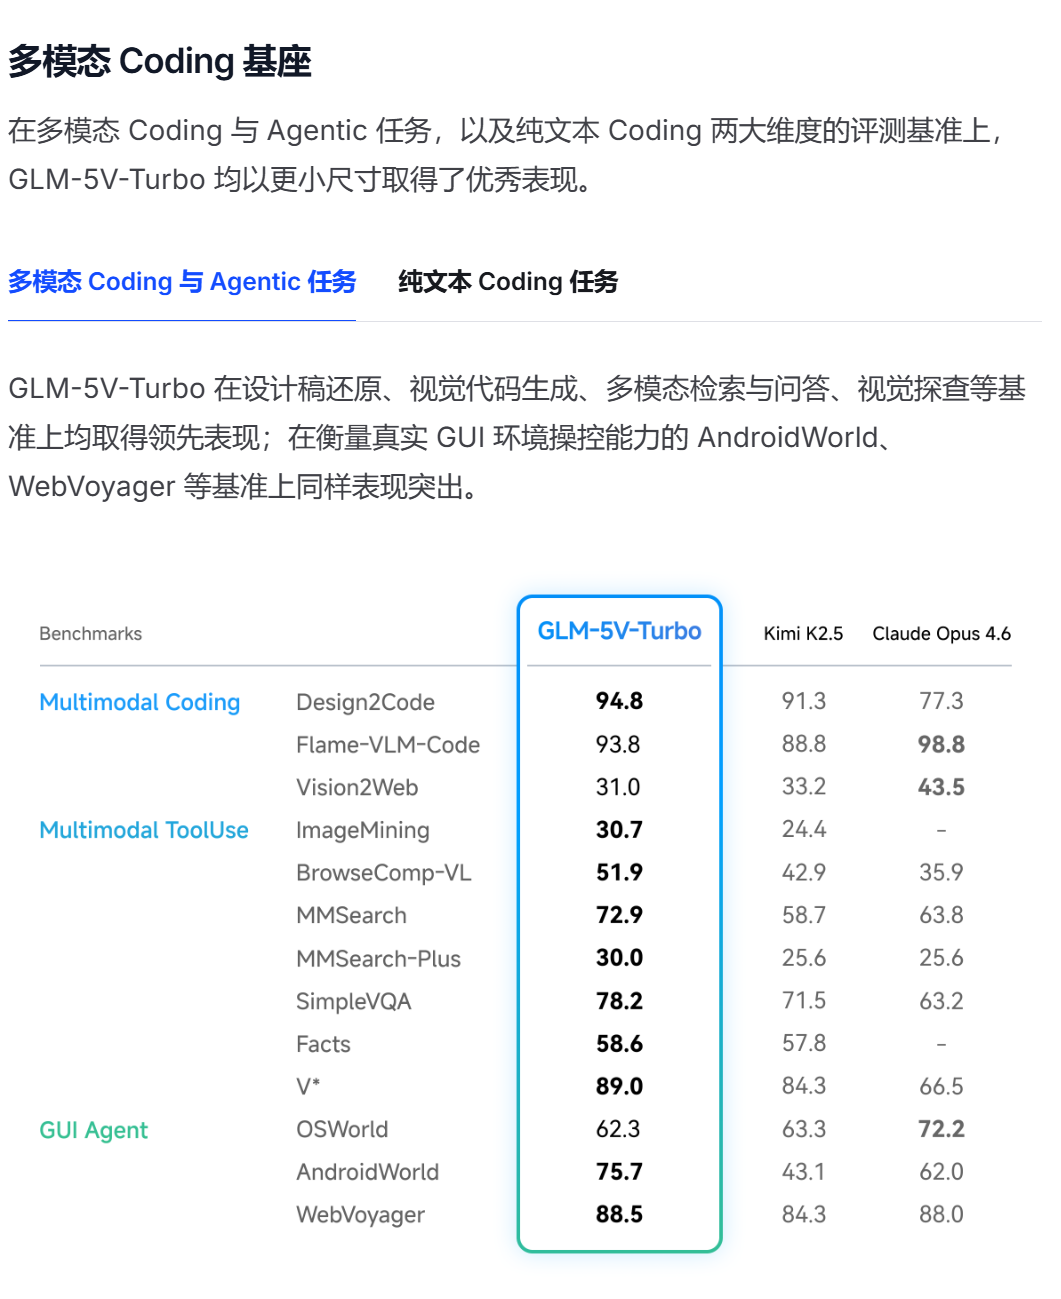
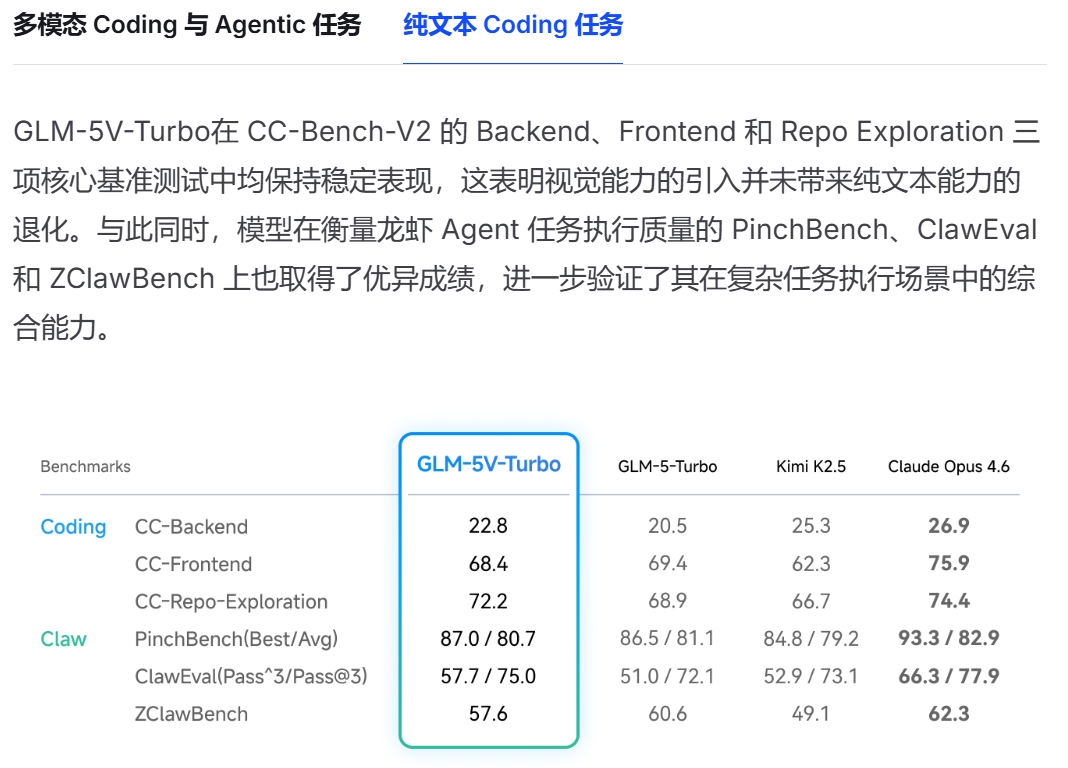
从官方公开的benchmark口径看,GLM-5V-Turbo的强项集中在三类任务上。第一类是视觉编程,在设计稿还原、视觉代码生成、多模态检索与问答、视觉探查等多模态Coding基准中取得领先表现。第二类是GUI Agent,在AndroidWorld、WebVoyager等衡量真实图形界面操控能力的基准上表现突出。第三类是纯文本Coding的稳定性,官方特别强调,在CC-Bench-V2的Backend、Frontend和Repo Exploration三项核心基准上,该模型保持稳定,视觉能力的加入并未拖累纯文本编程与推理能力。
开发者的普遍顾虑并不是模型能否看懂图,而是叠加视觉能力之后原有的代码能力是否会变弱。智谱单独将纯文本Coding的稳定性列出说明,正是对这一担忧的直接回应。
技术路径:四层升级与Agentic数据体系
官方将GLM-5V-Turbo的升级拆解为四层:原生多模态融合、30余类任务协同强化学习、Agentic数据与任务构造、多模态工具链扩展。具体而言,模型融合了新一代CogViT视觉编码器与更利于推理的MTP结构;训练覆盖STEM、grounding、video、GUI Agent、coding Agent等30多类任务;同时新增画框、截图、读网页(含图片识别)等多模态工具。
更值得关注的是后两层。许多模型在结构与训练描述上表现理想,但进入Agent场景后往往会暴露任务数据难构建、动作正确性难验证的老问题。智谱在官方文档中表示,其构建了一套多层级、可控、可验证的数据体系,并在预训练阶段就注入Agentic元能力。其目标并非让模型描述图片,而是让模型依据视觉环境决定下一步动作,官方demo也展示了GUI自主探索复刻、看图表读文档并输出分析等场景。
可用入口与计费方式
从使用入口看,GLM-5V-Turbo已通过智谱开放平台提供体验中心和API接入,官方快速开始页面也将其列入可选模型。另据媒体报道,该模型目前也可在Z.ai和AutoClaw上体验。对开发者而言,这一阶段的关键在于模型是否已能真正用于测试与工作流接入,GLM-5V-Turbo至少已迈出这一步。价格方面,官方文档确认采用token计费,并将价格信息指向开放平台的pricing页面。
小结
小结:综合官方定位、benchmark重点与公开demo,GLM-5V-Turbo把设计稿、网页、文档、图表等视觉输入接入了任务执行链,并转化为代码、动作与结果,视觉编程由此具备了更清晰的产品形态。视觉编程与GUI Agent仍处于快速变化阶段,真正的分水岭在于谁能更稳定地把任务执行到底,而GLM-5V-Turbo已把这场竞争向前推进了一步。