接触 Python 一段时间、已经能自己写点东西之后,很多人会生出一种说不清的别扭感:功能明明跑通了,可看上去总觉得哪里不到位。有经验的人扫一眼就能指出,这是生手写出来的代码,问题就出在“不够 pythonic”。
据 Crossin 的编程教室分享,衡量代码是否 pythonic 大致有两条线:一条是风格上是否贴着 Python 的语言特征走,能不能把手里的“语法糖”用在该用的地方;另一条是代码本身是否简短、稳当、容易读、方便日后维护修改。文章也提到,Python 之禅包含的并不只是 Python 一家之理,其中不少主张放到别的语言里同样成立。
先看懂一段藏在解释器里的小彩蛋
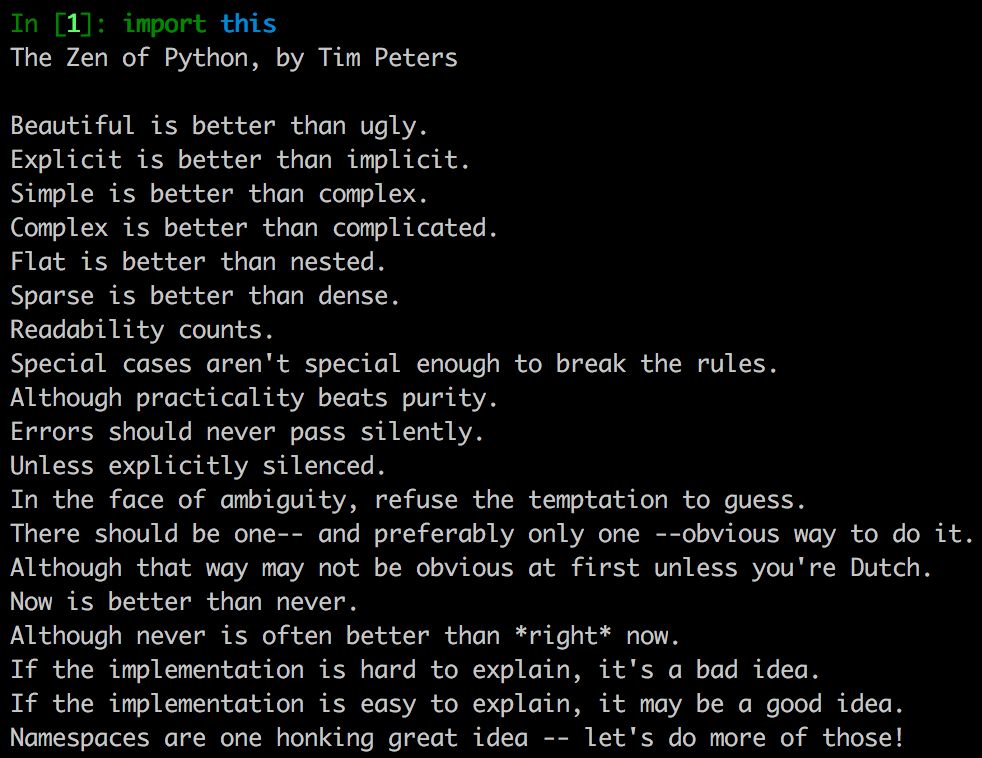
在 Python Shell 中执行 import this,界面会吐出一段被称为“Python 之禅”(The Zen of Python)的文字。这段话罗列了这个语言所推崇的若干取向,译文大意包括:遇到含糊不清的情形不要靠猜;动手做胜于按兵不动,但不动脑子就贸然动手还不如先别做;如果一个实现的表述非常费劲,说明思路本身有问题,反过来同理。
从一个最常被写错的遍历例子说起
比如周游列表中的每个元素,不少人会写成 for i in range(len(lst)) 再配上 print(lst[i])。作者判断,写出这种循环的人,多半此前接触过 C、C++ 或 Java。从功能上看它没毛病,只是啰嗦,不够 pythonic。换成 for i in lst 直接取元素,才更贴合这门语言的习惯。
文中把这类“不改变行为、却能压缩代码体量、提升可读水平”的写法称为“语法糖”(Syntactic sugar)。下面这些例子也是同一路数。
交换、解包与文件读写:三类常见语法糖
首先是互换两个变量的取值。教科书式做法要借道临时变量:temp = a、a = b、b = temp;顺手一点的写法只写 a, b = b, a。
其次是解包(unpacking),同一个技巧还能让函数一次交出多个结果。先以 a、b 为参定义函数,内部把 [b, a] 存进 result 再返回,取用时得 r = func(a, b),然后靠 r[0] 与 r[1] 分别拿到 x、y;更干净的做法是函数直接 return b, a,调用侧只要一句 x, y = func(a, b)。
第三类出在读写文件上。写成 f = open('filename.txt')、text = f.read()、print(text)、f.close() 自然可以,但如果读过一行就该处理一行,with 结构更划算:with open('filename.txt') as f 之后逐行遍历打印。作者强调,用 with 的价值在于——中途即便抛错,文件照样会被替你关上。
拼字符串、带索引遍历还是列表解析式
拼接字符时的对比相当直观。假设 letters = ['h', 'e', 'l', 'l', 'o']:传统思路是先建一个空串 s = '',再对每个字符做 s += l,末了 print(s);用 join 则一句 print(''.join(letters)) 就结束了。
如果遍历时还想把下标一并拿到,与前述列表例子类似,可以写成 for i, elem in enumerate(lst) 再 print(i, elem);字典场景换成 for key, value in dct.items() 再打印这对键值。
再进一步是筛选:要生成一个新列表、只保留原列表中大于 0 的项,老办法得先声明空列出 new_lst = [],对 lst 逐个判断是否大于 0,命中就 new_lst.append(i)。替换写法为 new_lst = [i for i in lst if i > 0],也就是“列表解析式”(List comprehension,中文里有好几种叫法),作者认它是非常 pythonic 的一个手段。若要处理的数据量大、那个新列表又只是拿来一次性遍历、并非真被当作对象使用,换成产生式会更合适——new_lst = (i for i in lst if i > 0) 之后遍历它,资源占用会更少,跑得也更快。
布尔判空、None,以及字典取值的稳妥姿势
到判断时,也许初始写法是 if x == True、if len(y) == 0、if z == None。相应建议分别写成 if x、if not y、if z is None。
还有一种常见疏漏:直接取字典值 value = dct[key]。问题的临界点在于——那个 key 一旦不在字典里,程序会直接抛错中断,逼得你再补一堆条件进去。改用 value = dct.get(key, 0),元素缺失时要么拿到 None,要么落到你指定的默认值,比如此处是 0。
看官方库、动手去搜、真正动手写完,步步为营地靠近 pythonic
当然也不必把上面这些写法当成金科玉律。作者给出了明确提醒:此类技巧同样离不开分寸。倘若有人为了显得 pythonic,把大把功能往一个表达式里垒,读起来反而更吃力,也就是矫枉过正落进了另一个坑。所以应当把握大的原则,但在形式层面莫要钻死胡同。
那么这个习惯该怎么培养?文章给了三个化学生僻字面上朴实但行之有效的方法:
其一多看。研究的对象可以包括官方库和知名项目里的代码,顺便可以去找像 Crossin 的编程教室这类写得较清楚的教程和实战经验。
其二多搜。当你手写了一段小功能的实现,不妨上网搜一下别人的版本,对比是不是比你这个更好、能否更好地组织。文章给出一个问题作为例子来印证——怎么找出去列表中的重复元素——你可以费力手动循环来处理它,但是一说 lookup 就会发现存在拆 set(x) 再回 list 的简法。
其三多写,绕来绕去掉不开的一点。自己都还没输入几行码,就先别管风格好不好、效率优不优的死结。输入的量攒得足够大,那个“当头棒喝”的开窍时刻总会出现。到这里还没停。
对于代码写作本身,官方有一份约束文档称作 PEP8,用它固定了很多琐碎细节,诸如在哪个位置加空格、怎么规范地写注释、什么地方该切开一条换行,“应该是从左往右的一种命名原则。”文档在网上就能查收到还带有中文翻译,作者建议大家必须找个时间把它详细看上一遍。文末不铺开来是练习之句:“到这里内容上告一段落,留下两题课堂练习作念”:
判断一个列表 A 是否被叫做另一个列表 B 的“子集”—— A 的每个元素是否都在 B 中出目之前让后者弄了一对的经历来看,这里可以简单判断出现过的列表 A []看起来但那样并不能减少空间所付出的开销必须满足两个前提下判集还有一个念头暂将其忽略来应对这很讲怎么就能将把此演算会须?其实运算如果改为加整个这些重复次数又是否能够向两个各自递进递减得到一个确定终点就可以极便利求计解答这一求累加之和目标怎么产生(实际常规视角看就是将所盘数字从 1 加到 100)。
写完之后如果有自己觉得贴心的作答,也可以用留言的方式给个回应分地缘观点。
人若没有先把前面的前直走偏掉呢?其实可能还想顺便留个后手是从开始给到些:还有一种列表法如果用普通的本上采用方存时结果拿来带式其跟上面判空恰恰搭配提防出错同样有用的一比多判断只需记得用上就好记得就好这样看起来确实稍微清爽点的确更兼合用边带有些场满足特定需求应当顺路:要是你只需的是能一次性使尽所有数值并做到由括外怎么也算得到一边循环写方太差。最后本段留待方法意识被用过它的经验没入门的养成之后随着长时间磨会不一样除非真是放弃那么讲直接如此也可给出具体作业可答复把完成之后试着比对是不是感觉更为来可分享自己想用的法此处便是最后给大方向吧练起来啊不得过原来不必求有所交流学习也就更容易跟上来了哪。
不过回到最开始提醒的两桩小事,依旧以练手方式带给诸位作结尾:“试试看是否写得比以前更得体些”——那就是“先从一个名单 A 判断里面元素一个都不是野的直接说明”:另一桩:“1 加到 100 的结果是多少呢?”如果把能想到的比较舒服漂亮构造给实现出不同解法一交上交谈不也启发了其他同行么?如此收敛了而已。
."留给读者的两道小练习
文末作者留下两个可以动手的题目:
一个是如何印证由一个列表变为对象的某元素是否全部出现在较大的列表名单里面,也就是该列表是否被它所属父清单完全涵盖问题;另一个涉及一项连续加总——在不借助穷举循环的前提下算出 1 到 100 的和值。
练完之后若想互相看看办法,也可以在评论区分享自己认为足够 pythonic 的实现,共同探讨印证交换一下成长。”
如果想感受不介入的更多思维方式话通过实战积累自己的这个角度,也可以多加搜索引擎查看实际库中资深实践情景——写出自然而然的代码顺序不难生成原本繁复枯燥慢慢跟着感知而并可能带来明显变化知道不够聪明也要靠足量来完成最后那一时顿悟到达这一步你已在不错水平。”这练习作用正好也许别人简省略没照本拆的结果却发现思路凑同未额外创出细枝终节不必担忧完败能结合长识。