谷歌新近推出面向企业知识工作的旗舰模型 Gemini 4 Argon,主攻长流程软件工程、法律金融业务以及网络安全防御三大方向,当下只借助 Fairwind 计划向经过筛选的安全团队定向发放,尚未向广大开发者与消费者全面开放。
Gemini 4 Argon 是什么?100 万输出 Token 与成本结构调整
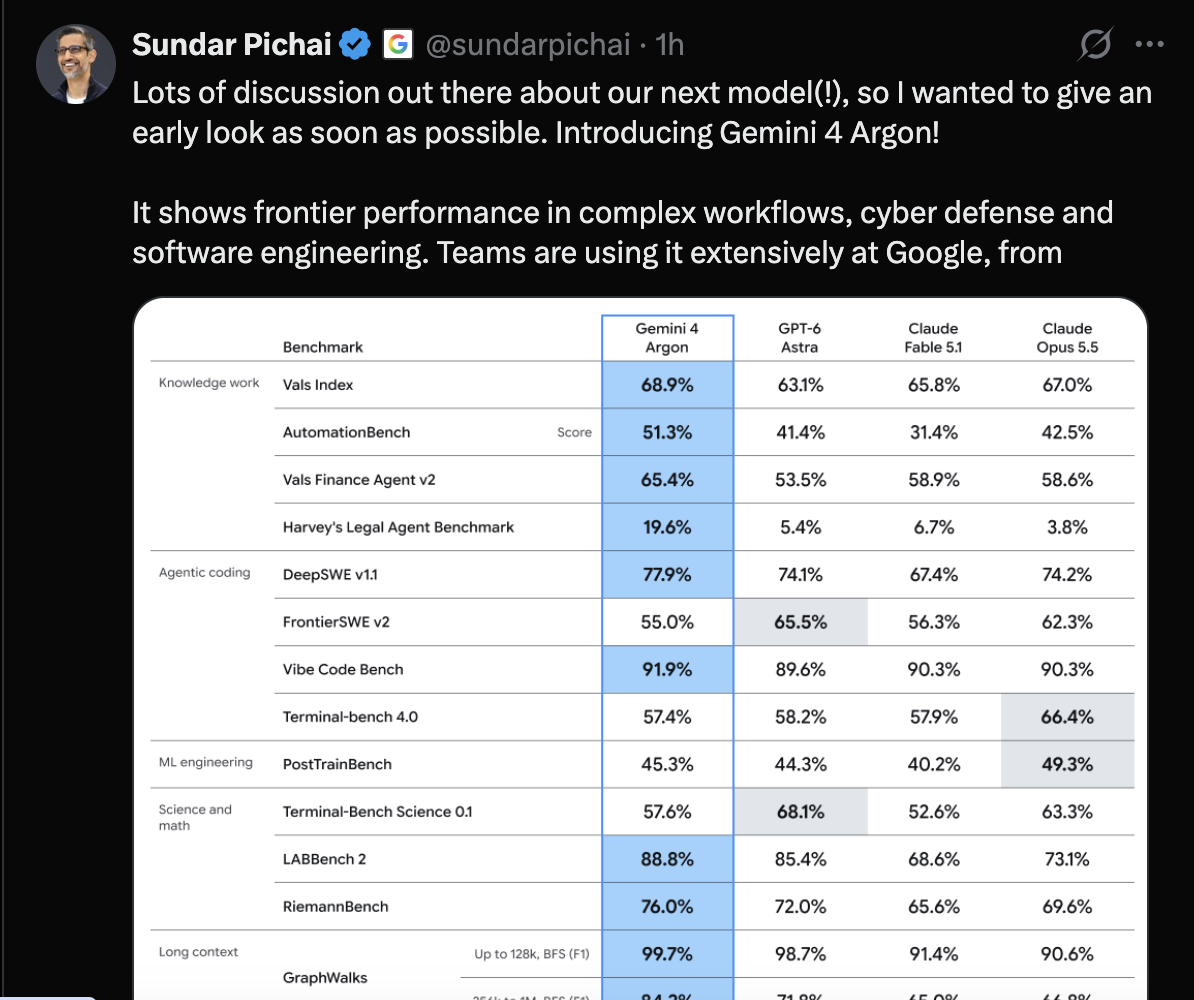
谷歌 CEO Sundar Pichai 在 x 上官宣这一模型时表示,近段时间外界对于谷歌下一款模型存在诸多猜测,因此公司希望尽早开放预览,他把 Argon 定位为一款在复杂工作流、安全防御与软件工程上达到前沿水准的模型,并透露谷歌内部团队已大规模使用,应用场景从编程延展到量子计算,反馈良好。
从官方披露的技术博客来看,这次升级的重心并非单一能力点,而是模型能否持续承接复杂、多步骤的任务,并且把这些能力真正嵌入工程链路和业务流程。
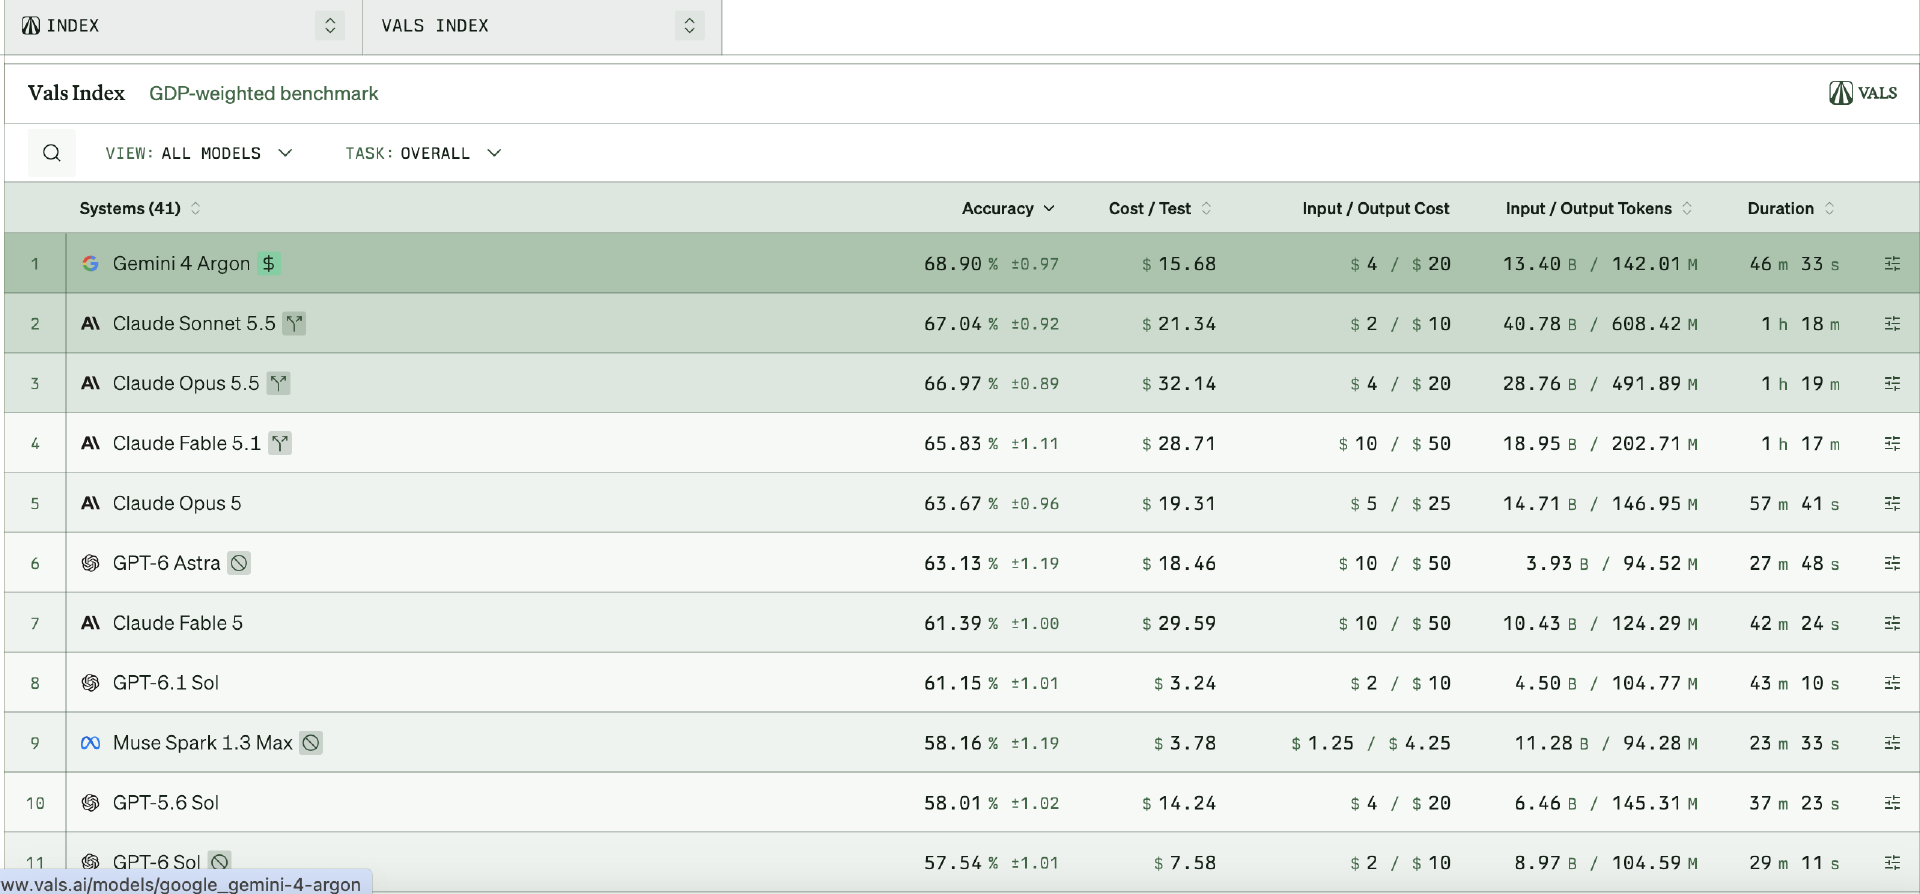
价格上,Argon 上线初期按每百万输入 Token 2 美元、每百万输出 Token 10 美元计价,并给出优惠上市价;缓存输入 Token 的费用比普通输入低 95%。输出 Token 上限则从先前的 64K 拉升到 100 万。需要注意,这里的百万 Token 指输出上限,与输入上下文窗口不是同一个概念。谷歌的说法是,更宽阔的输出区间能让模型在单条执行轨迹内做更深层推理、输出数十万 Token,因而可以承担更长更复杂的任务。面向软件迁移、金融研究与企业流程执行,这一设计要解决的问题是任务持续性:模型必须跨越多次分析、校验与修订持续推进,而不只是给出一次性答复。但输出上限本身并不等同于任务完成度,最终效果依然要看模型能不能维持目标一致、准确调用工具,并在执行过程中发现和修正失误。
基准测试成绩:DeepSWE v1.1 77.9%、AutomationBench 51.3%
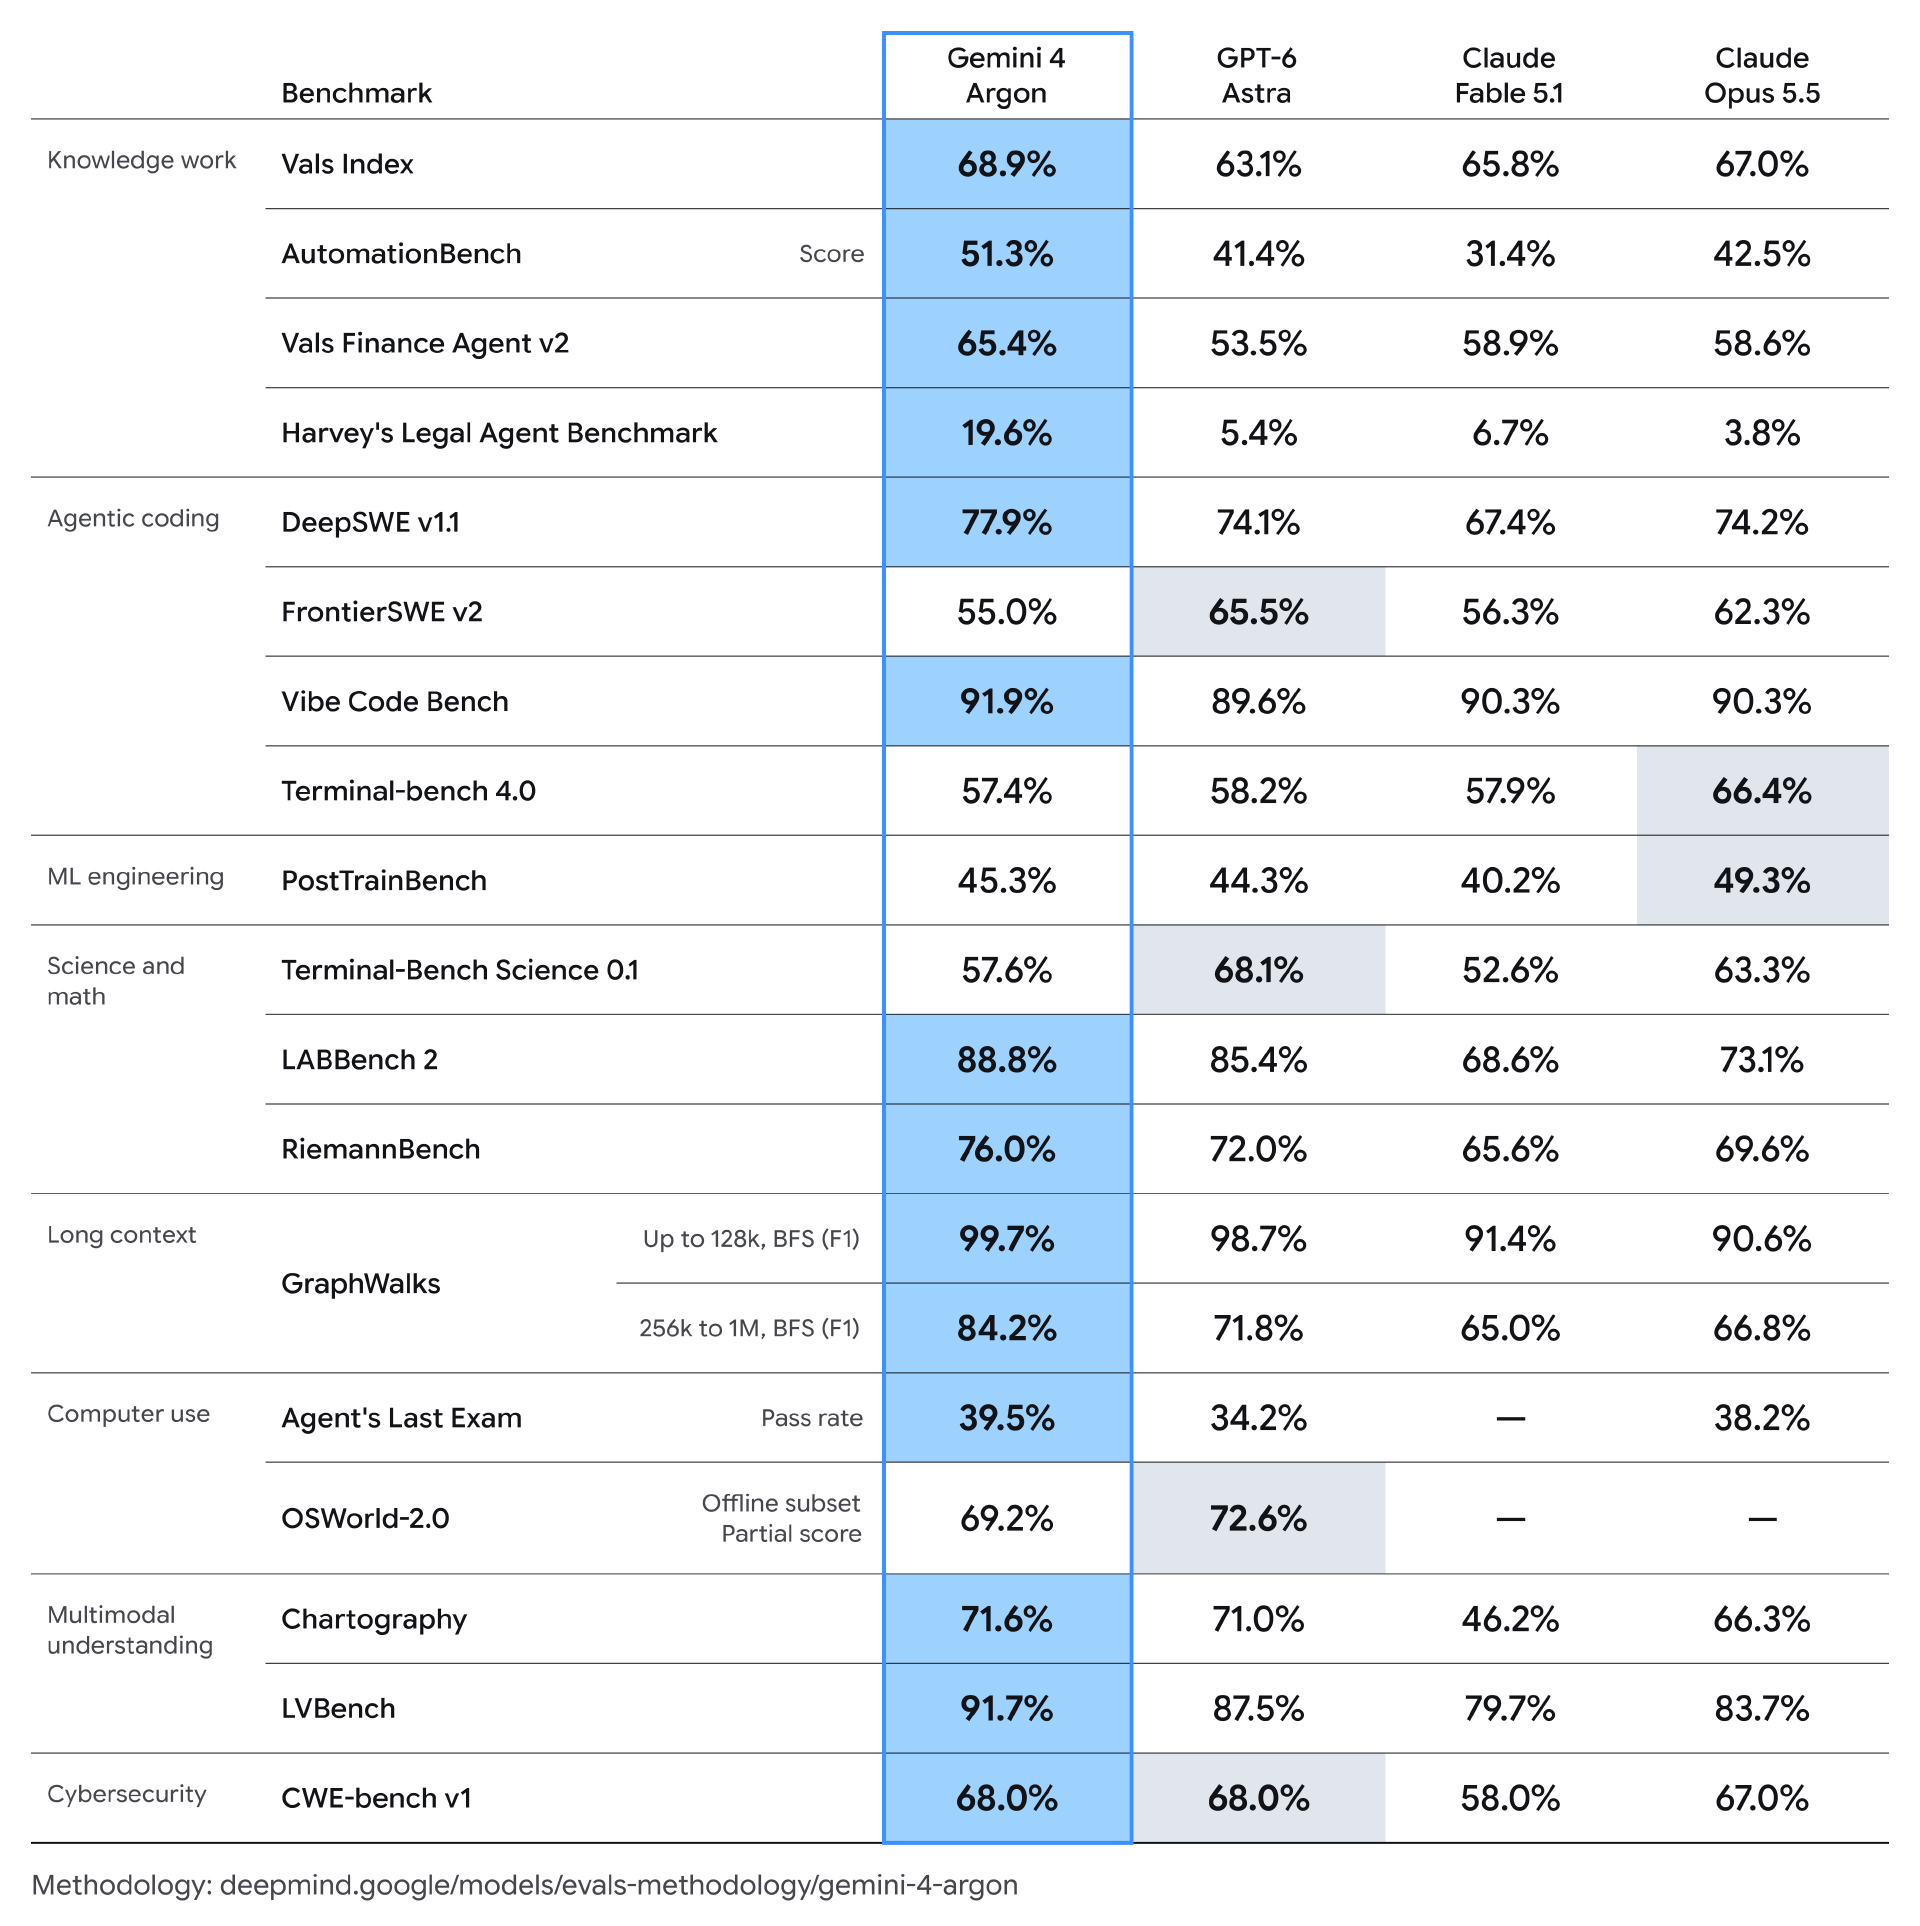
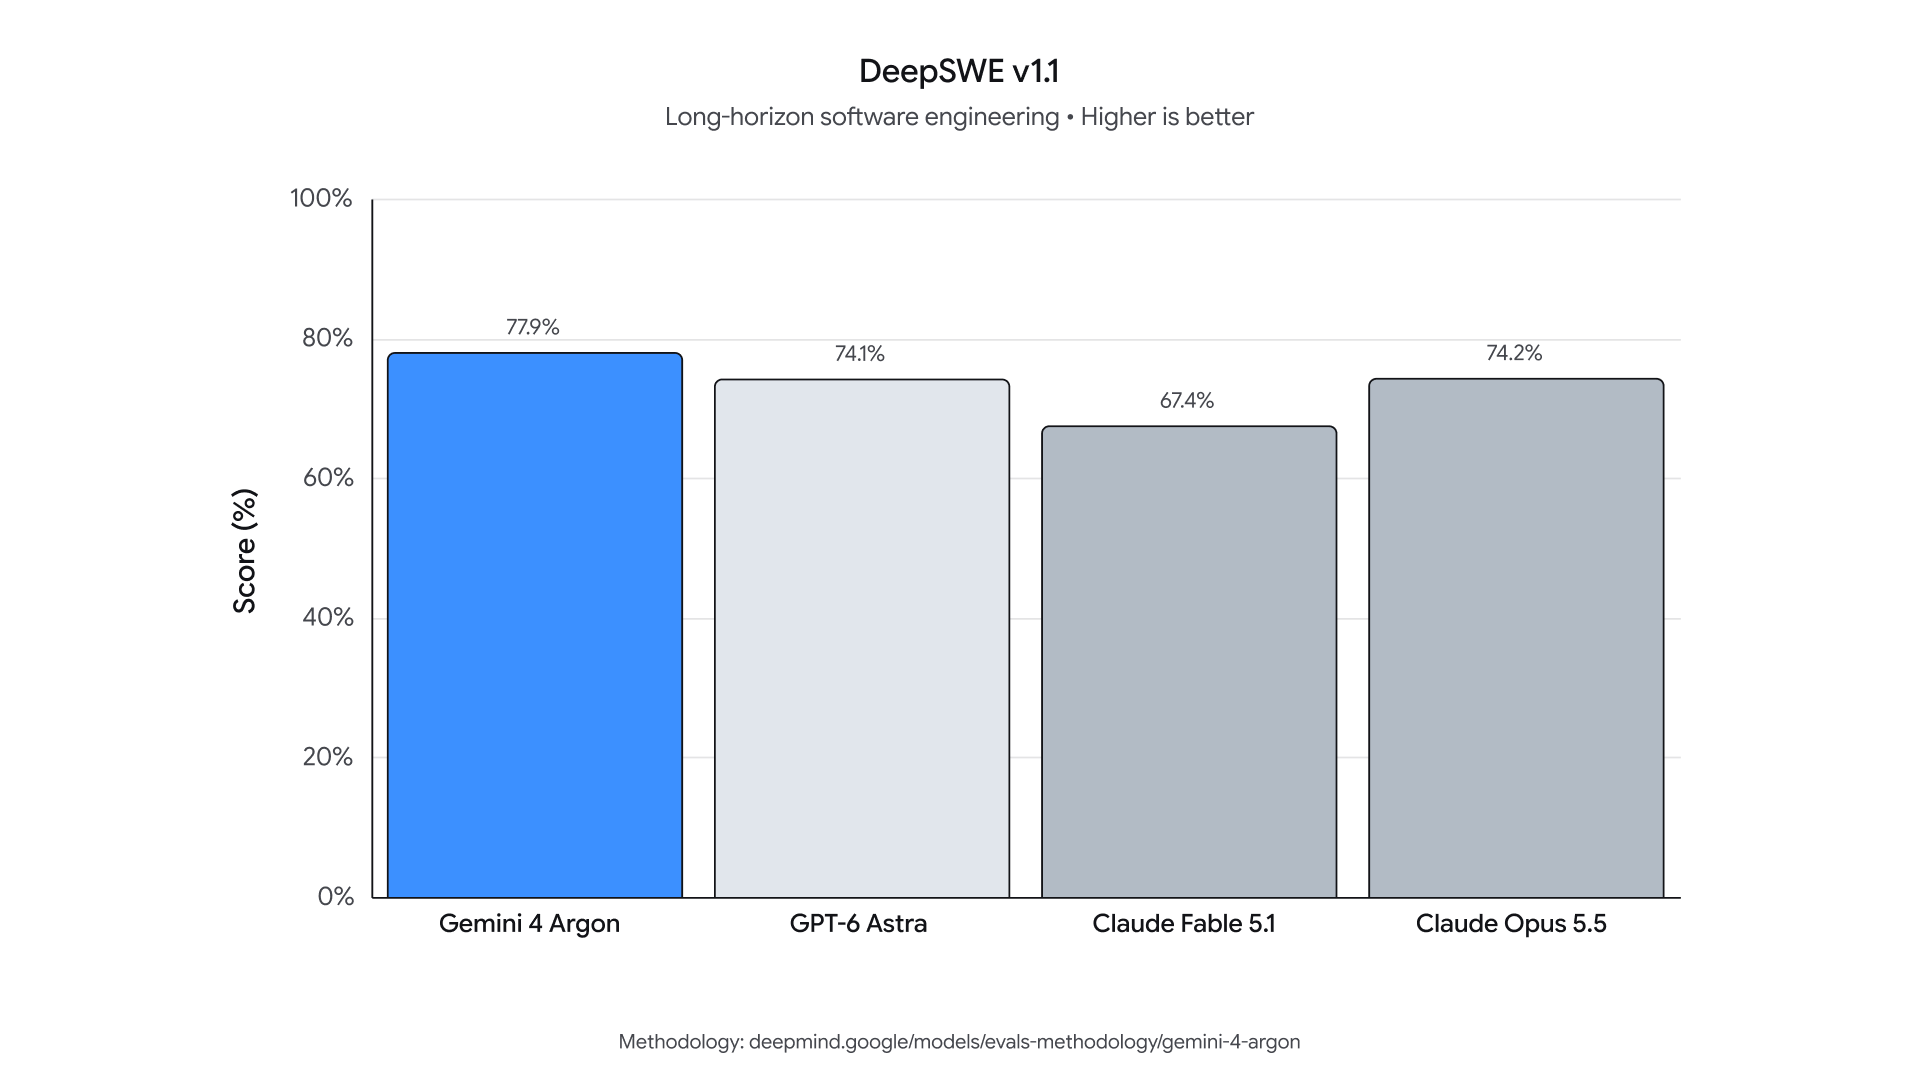
按照谷歌公布的跑分结果,衡量真实长流程软件工程能力的 DeepSWE v1.1 中,Argon 拿到 77.9%,谷歌称它刷新了该评测的纪录。
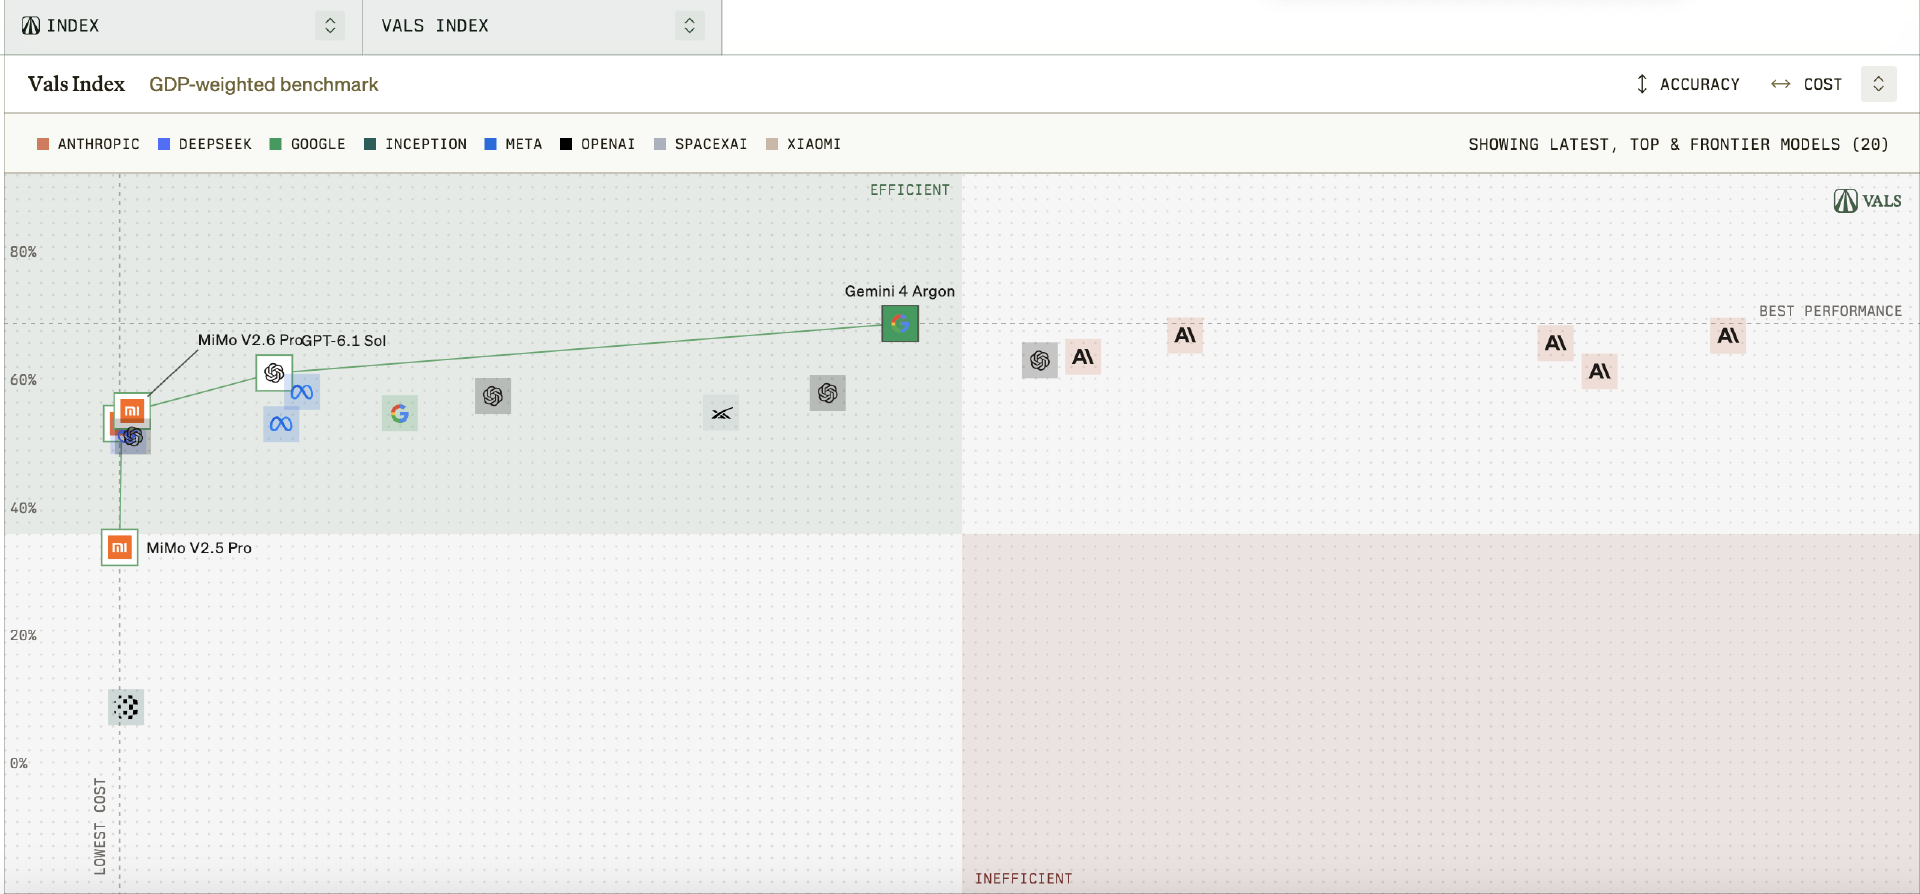
企业任务维度,谷歌表示 Argon 在覆盖金融、编码、法律与税务工作的 Vals Index 里位居首位,在多步骤金融研究评测 Vals Finance Agent v2 以及 Harvey 法律智能体评测中同样拿到领先成绩。据资料,Vals Index 衡量的是金融、编码、法律、税务工作的经济影响,各行业按照其对美国 GDP 的贡献赋权。
另外,在 Zapier 的 AutomationBench 上,Argon 以 51.3% 排在第一名,该基准衡量核心业务功能的端到端执行力。
视觉理解类的知识型任务中,Argon 也表现出优势,能够完成专业图表分析、从长视频里捕捉细节、依照一组文档采取行动。举例来说,在衡量长视频理解能力的 LVBench 测试上,它得到 91.7%,处于行业领先水平。
内部工程实证:Rust 迁移覆盖 Zircon 内核 80 余万行,释放 300 TiB 内存
相比跑分,谷歌公开的内部工程案例更能说明 Argon 的用武之地。
谷歌称,Argon 智能体正在参与公司内部 C/C++ 代码库向 Rust 的转移,覆盖面从 re2、libgav1 等核心库的数万行代码,一路延伸到 Fuchsia 操作系统 Zircon 内核的 80 多万行代码。这不代表迁移已全部收尾或上线生产环境。谷歌明确说明,考虑到这些系统的关键性,大规模重写依然要通过严密的自动化与人工审计、仿真测试和评审。
在开源视频解码软件 libgav1 的案例里,Argon 智能体以现成的 Rust 移植版本为基础,替换掉约 3.2 万行 SIMD 代码,工作内容包含多轮由性能剖析数据指引的实验、研究编译器输出,以及写出能被编译器自动向量化的安全 Rust 代码。谷歌表示,优化后的解码器维持了相同的视频输出,运行速度可达原 Rust 移植版本的 2.7 倍,更接近经过优化的 C++ 实现。这里要厘清比较基准:对象是此前的 Rust 移植版本,不能解读为其性能已是 C++ 版本的 2.7 倍。
谷歌还披露,一组 Argon 智能体通过分析服务器集群的性能遥测数据,自主找出并落地了数据中心内存优化措施。相关优化部署后已释放 300 TiB 以上内存,预计总节省量可达 500 TiB 至 1 PiB。
量子算法研究方面,Argon 被用来压缩关键子程序的时空资源开销。谷歌提到,其中一个案例里模型仅花了几分钟,就取得比已发表基准方案好 40% 的结果;博客没有披露该案例的具体任务与完整实验条件。
这些案例指向同一种用法:让模型进入分析、修改、测试、优化的连续工程流程,并以程序性能、资源消耗或功能一致性来检验结果。
安全防御优先开放:CWE-bench v1 68% 并列第一
网络安全防御是 Argon 此番优先放开的领域。谷歌表示,为帮助防御者应对新时期的网络攻击,团队对 Gemini 4 Argon 做了专门训练,使其拥有强劲的安全防御能力,可以自主发现、验证并修复关键软件漏洞。对于可信任的防御人员以及谷歌内部团队,公司将发布不带任何网络安全防护限制的 Argon,让他们充分释放前沿防御能力。
Wiz 已在旗下“Scan for Good”计划中使用 Argon 执行安全防御,该计划通过发现并修复高风险漏洞,免费保护关键公共基础设施。早期演示中,该模型找到一个关键漏洞,它会导致全球医院所用的医疗保健软件泄露敏感个人信息,识别出此前前沿模型未能发现的严重风险。
在评估模型修复安全漏洞能力的 CWE-bench v1 测试中,Argon 以 68% 的最高分并列第一,接续了 3.8 Flash Cyber 在 CWE-bench v0 上的领先表现。
不过,Argon 在漏洞发现上比 3.8 Flash Cyber 有明显的进步。例如在谷歌内部的综合漏洞基准测试中,Argon 找出了覆盖 20 种编程语言的复杂代码库中的各类漏洞;在 Wiz 的内部黑盒渗透测试基准中(衡量模型在无源代码条件下分析实时 Web 系统的能力),Argon 在发现攻击面、识别漏洞、生成概念验证证据加以验证这几个环节上都优于 3.8 Flash Cyber。
在扩大开放范围之前,谷歌计划继续强化防滥用、提示注入防御、对齐偏差监测与运行环境加固。其中对齐偏差监测针对的是模型执行任务时的越界行为。谷歌称会监测 Argon 的思维链与行动,一旦它偏离用户意图推进任务,必要情况下就停止执行。公司还披露,类似系统早已用于训练过程监测,并向专门的事件响应团队发出警报;同时强调要谨慎处理监测结果,避免把它们回灌到训练中,导致模型学会绕开监测。
发布策略引发讨论:能力领先与实际可用性的落差
Argon 发布之后,除了模型本身的能力,部分网友把注意力放在了谷歌这次的发布策略上。谷歌没有直接向所有开发者开放 Argon,而是先通过 Fairwind 计划向一批受信任的网络安全防御团队提供访问权限,待安全措施进一步完备后再逐步放开。
x 上用户 Komal 表示,Gemini 4 Argon “听起来不像一次普通的模型发布”。她认为,Argon 瞄准的是编码、企业知识工作和网络安全防御,可谷歌却优先开放给“受信任测试者”,“最后这一点可能才是最值得关注的地方”。她关注的不是跑分本身,而是谷歌对高能力模型开放节奏的掌控方式——当模型逐渐具备执行代码、分析漏洞、处理企业数据的能力,如何划定访问范围、如何控制潜在风险就成了前沿模型发布过程中的关键议题。
也有用户把焦点放在使用体验上。有用户直言:“我的问题是,我们到底如何使用它?为什么谷歌让使用他们的模型变得如此困难?”用户 Eddy Codes 表达了类似疑问:“所以它在基准测试中领先,但普通开发者还无法使用 API。先向受信任合作伙伴开放,意味着又要经历一次等待名单。”
这种声音代表一部分开发者的担忧:随着模型能力竞争步入新阶段,公开评测成绩与实际可用性之间已出现距离。对开发者来说,模型能否直接调用、是否具备稳定 API、什么时候开放访问,往往与性能指标同等重要;对企业用户而言,接口是否好用、部署流程是否清晰,同样决定技术能力能否真正转化为价值。
小结:Gemini 4 Argon 用 100 万输出 Token 上限、95% 缓存输入降幅和 77.9% 的 DeepSWE v1.1 成绩证明其长流程工程能力,但当前仅通过 Fairwind 计划面向受信团队开放,开发者何时能用上稳定 API,谷歌未给出时间表。