同样一个从零开始的全栈项目,国产旗舰模型与小模型之间的费用差距被拉到了什么程度?2025年9月30日,雷峰网进行了一次成本实测:Qwen3.8-Flash完成任务的支出为6.26元,GLM-5.3-Flash为7.72元;一旦换用旗舰级GLM-5.3,费用直接攀升至80.49元,达到Flash版本的10至13倍。同一时间段内,国产厂商集中推出了一批Flash小模型,MiniMax更宣布从10月1日起将新模型纳入订阅体系,一周内不限量免费使用。价格虽低,但节省与堪用是两个独立命题,有必要逐项拆解。
实测方法与时间账:同一任务的两轮对照
雷峰网的测试条件并不复杂:借助Claude Code,在相同任务与相同环境下,让两款Flash模型各自从零构建两轮「网页版个人工作台」。该应用覆盖任务管理、日程安排、笔记、Dashboard与全局搜索,包含前后端、数据持久化及测试环节,最终以官方公布单价乘以token消耗量核算成本。
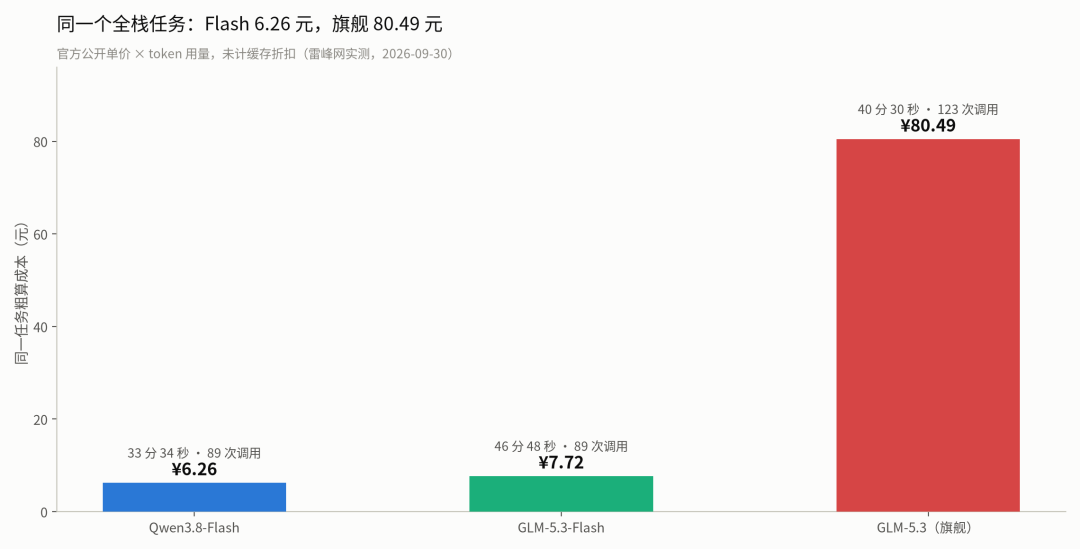
两轮测试后,Qwen3.8-Flash用时33分34秒,模型调用89次,工具调用127次,粗算支出6.26元;GLM-5.3-Flash用时46分48秒,模型调用同为89次,工具调用207次,粗算支出7.72元。作为对照,旗舰GLM-5.3用了40分30秒,模型调用123次,粗算支出80.49元。该核算口径按输入token对应输入价、输出token对应输出价计算,尚未计入缓存命中折扣。换言之,这是不考虑缓存优化的账单,在上下文重复度较高的场景中,实际支出还会进一步降低。
交付质量对比:两家都跑通,优势各有侧重
从可运行结果来看,两款Flash模型均产出了能跑起来的全栈应用。GLM-5.3-Flash的强项在于工程完整度,登录、增删改查、统计、测试等模块齐备;Qwen3.8-Flash则在个人工作流设计上表现更细,智能排序、逾期提醒、Markdown笔记的处理更到位,但编程环节稍弱,出现文本溢出的小缺陷。两家均未实现将笔记自动转化为行动项。
九月集中更新:13个Flash模型与旗舰的真实账单
2025年8月26日,智谱与阿里同日发布Flash版本产品GLM-5.3-Flash和Qwen3.8-Flash。此后,9月10日推出DeepSeek V4.1-Flash,9月21日推出小米MiMo V2.6-Flash,9月27日推出MiniMax M3.1-Flash-Preview。据晚点LatePost在10月1日季报中的统计,三季度各家合计发布了13个Flash模型。
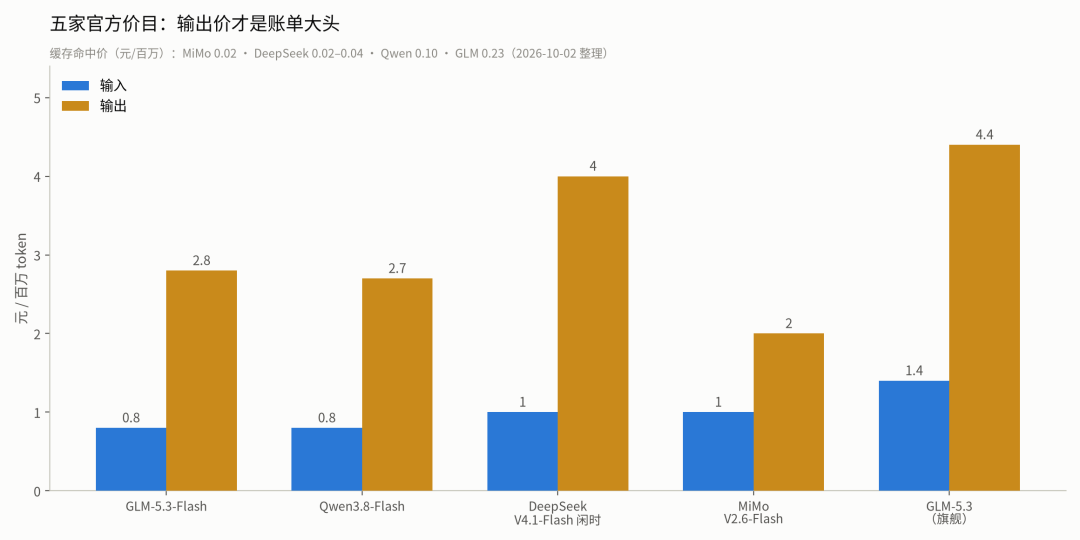
旗舰模型的定价表面并不悬殊:GLM-5.3官方标价为1.4元与4.4元,仅比自家Flash贵一倍多。但真实任务中,输出token占据主要成本,最终账单会放大到十几倍。前述80.49元的高出部分,本质上是为复杂工程一次做对的概率买单,而非每一句回答都更聪明。
MiniMax订阅制打法:不限量一周与速度优势
MiniMax选择了不同路线:M3.1-Flash-Preview不按token单价计费,而是打包进订阅套餐,Plus为22美元、Max为55美元、Ultra为132美元每月。官方公告显示,10月1日至7日,所有订阅用户可在MiniMax Code中不限量调用该模型,新订与升级享首月五折。据品玩对五个项目的实测,它能稳定跑出100+ tokens/秒,速度约为MiMo和GLM的Flash版本的两倍。不过其代价是Artificial Analysis榜单尚未收录该模型,缺少跑分对照依据。
另两套口径:AA榜单与厂商宣传价的差异
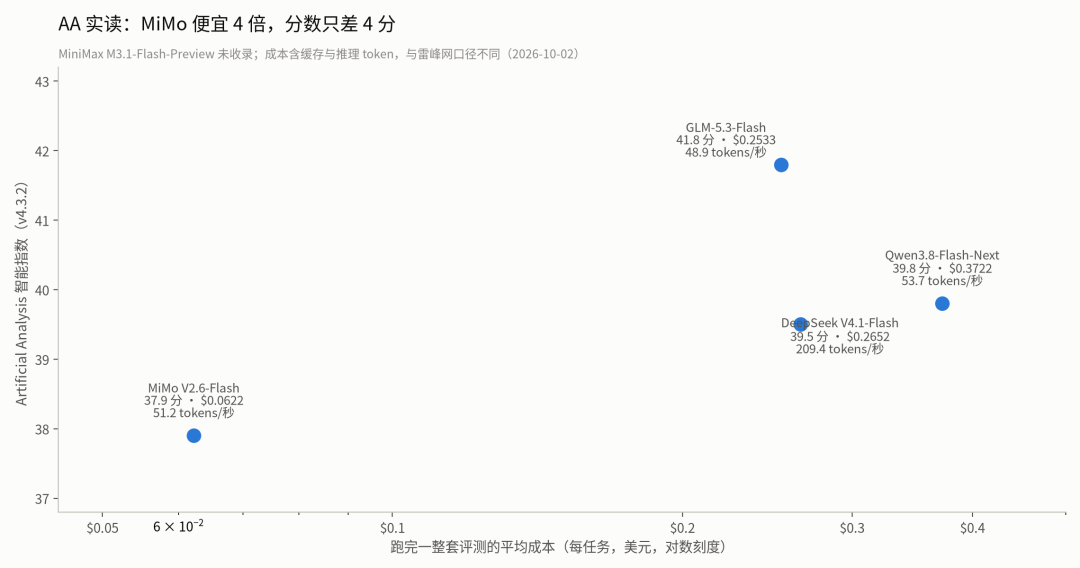
在已经进入Artificial Analysis榜单的几家中,小米定价最低。MiMo V2.6-Flash的每任务成本为0.0622美元,不足GLM-5.3-Flash的四分之一,约为Qwen3.8-Flash-Next的六分之一,但智能指数为37.9分,低于后者2至4分。DeepSeek V4.1-Flash为39.5分,每任务0.2652美元,输出速度达209.4 tokens/秒,是几家里最快的。GLM-5.3-Flash以41.8分居首,每任务成本0.2533美元。
需要留意,AA的每任务成本与雷峰网按单价乘用量的口径不同。AA将缓存读写与推理token一并计算,且采用它自己的题目设置;厂商宣传的折扣价则是第三套口径。三套数据并列观察,只能得出一个判断:是否划算取决于实际负载类型,尤其是输出价格与缓存折扣两个变量。输出token才是总账单的大头,缓存命中还能再削减一部分支出。据文中信息,MiMo的0.02元缓存价为全场最低,适合重复上下文较多的场景;DeepSeek的闲时价格为高峰时段的一半,错峰批处理可节省一半费用。
价格与能力边界:哪些活该用Flash,哪些值得上旗舰
围绕60余个汉字之外的细节仍要回到场景选择。做个人工具、脚本和轻量前后端,Flash版本在当前阶段已足够覆盖,Qwen与GLM的实测结果均达到可交付标准。若目标是控制成本,应优先关注输出定价与缓存折扣两项指标。对于复杂工程,前述80.49元并非无谓支出,旗舰版本一次做对的比例确实更高;但对大多数使用场景而言,这一差距尚不足以支撑12倍的价格差。建议先用免费周尝试MiniMax,再用自身真实任务核算账单,比对任何榜单都更贴近实际。免费周截止日期为10月7日。
小结:本轮 Flash 小模型的密集更新,把同一任务的账单差异放大到了10倍以上,Qwen3.8-Flash 以6.26元完成交付、GLM-5.3-Flash 以7.72元紧随其后。厂商定价、雷峰网实测、Artificial Analysis 榜单属于三套不同口径,选型时应以自己的真实任务衡量输出价与缓存折扣。