现代AI数据中心全速运转时,硅晶圆上密集轰响的是以万亿次计的浮点运算。大语言模型在GPU内部到底执行着什么任务?关键在于矩阵乘法(GEMM)。以DeepSeek披露的数据为参照,从把矩阵乘法的耗时减少10%出发,就能在同一块芯片上换取成倍的token产出,并显著降低推理开销。面对注意力机制、数千亿参数的专家路由等环节,剥去数学外衣后,超过90%的算力开销都指向同一类运算——GEMM。
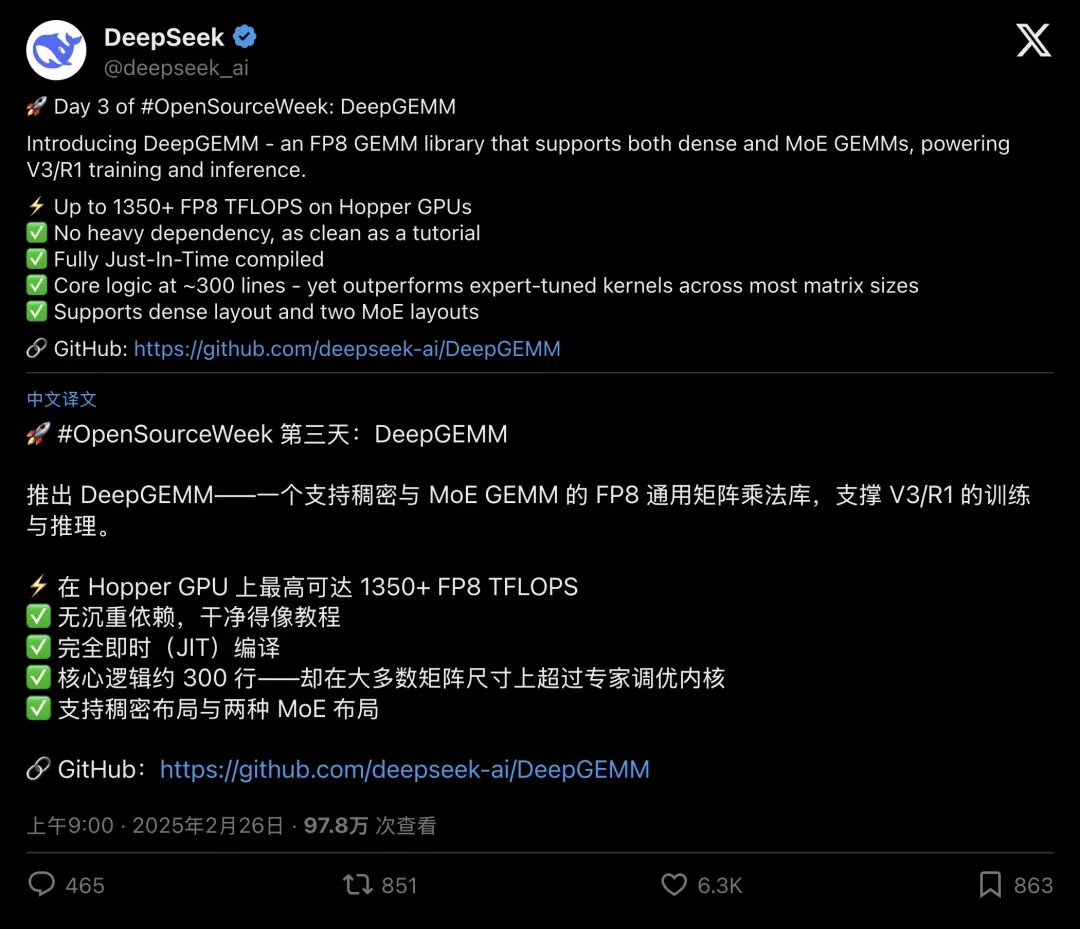
GEMM的输入一侧是成千上万个词元的激活值,另一侧则是规模庞大的模型权重,两组数字相乘、按行按列累加。它被视作大模型的“呼吸”。DeepSeek-V3与R1在2025年初引发全球关注,硅谷一方面惊讶其低成本,一方面试图拆解其训练方法。答案的一部分出现在DeepSeek“开源周”第三天:驱动V3与R1运行的核心机械被完整开源,名字是DeepGEMM。
FP8与细粒度缩放:精度红线上的技术前提
要理解DeepGEMM解决的问题,需要先回到数值精度这一层。传统AI训练常以16位浮点数(BF16或FP16)为主,每个数字占两个字节,精度平稳,却对显存与带宽形成沉重负担;类比来说,像是用重型卡车运砖,稳定性足够但道路容易拥堵。如果换用FP8,每个数字只占1个字节,数据体积直接减半,理论计算吞吐可翻倍,总线带宽压力也同步下降。
代价也十分明确:FP8可表达的数值区间极窄,数值稍大就溢出为无穷大(NaN),稍小则坍缩成零——本质上是在精度刀尖上跳舞。为驾驭FP8,DeepSeek在V3报告中提出严格的细粒度缩放策略:激活值按切片缩放,权重按矩阵块缩放,中间累加仍需保留更高精度。难题在于,此前的底层算子库中没有可直接套用的实现。
当时主流选择是英伟达官方的CUTLASS。它功能强大,但结构像一座巴别塔,内部有大量嵌套的C++高级模板以及难以梳理的元编程代码。一旦进入真实的大模型推理场景,比如每次只有少量token输入的“瘦长矩阵”,或MoE架构下动态分发到不同专家的“变长碎块”,通用库的臃肿就会造成硬件空转,算力利用率从理论峰值下坠。DeepSeek的路径是去掉多余抽象,直接触及硬件寄存器,让张量核尽可能保持持续运转。
约300行JIT核心:实测1350+ TFLOPS,PR推进到1550
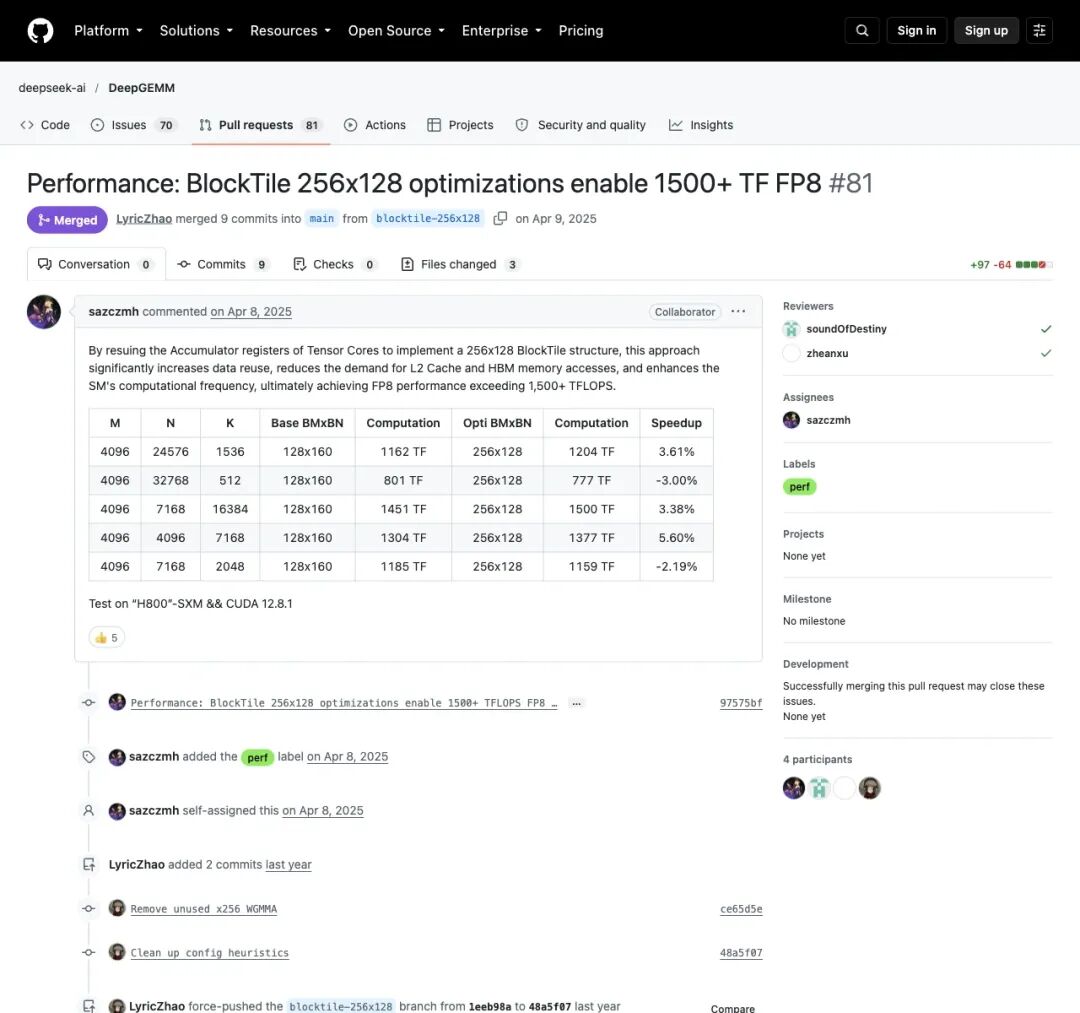
DeepSeek交付的方案让CUDA算子领域的工程师侧目。它跳过冗长编译流程,也摆脱复杂的模板依赖,形成一个极其干净的JIT(即时编译)库,核心计算逻辑约300行上下。代码可读性接近教材,但载入英伟达Hopper架构的H800后即展现很强冲击力:首发测试中,DeepGEMM在H800上取得1350+ FP8 TFLOPS峰值;之后通过PR与版本迭代,官方继续将该纪录推高至最高1550 TFLOPS。
放到真实服务的动态形状下,差距更直观。M=64是生成推理里常见的薄片尺寸,在这一场景下,DeepGEMM相对英伟达经过专门优化的CUTLASS内核达到2.7倍加速;进入中等尺寸区间,也普遍保持1.1倍至1.7倍领先。
两种底层思路由此形成对比:常规内核像一把大而全的瑞士军刀,约九成代码在应对模板参数,遇到动态形状会频繁停顿;DeepGEMM则类似按真实尺寸量身定制的手术刀,约300行核心逻辑只对齐真实负载,硬件单元得以满载运转。这种选择意味着它放弃了针对所有可能形状编写通用代码的想法,专门面向大模型的真实生命期。它原生支持连续布局与掩码布局下的MoE分组矩阵乘法:专家网络路由出现变长需求,就沿M轴动态分组;跨GPU通信容易出现卡顿,就让掩码布局与底层通信库衔接。每一行指令都对准硬件实际的运行节奏。
swapAB与Mega MoE:Blackwell世代下的微架构优化
进入英伟达Blackwell(SM100)世代后,算力密度再度翻倍,芯片底层的物性限制也更为特殊。技术社区在拆解过程中挖掘出一处关键技巧:swapAB。
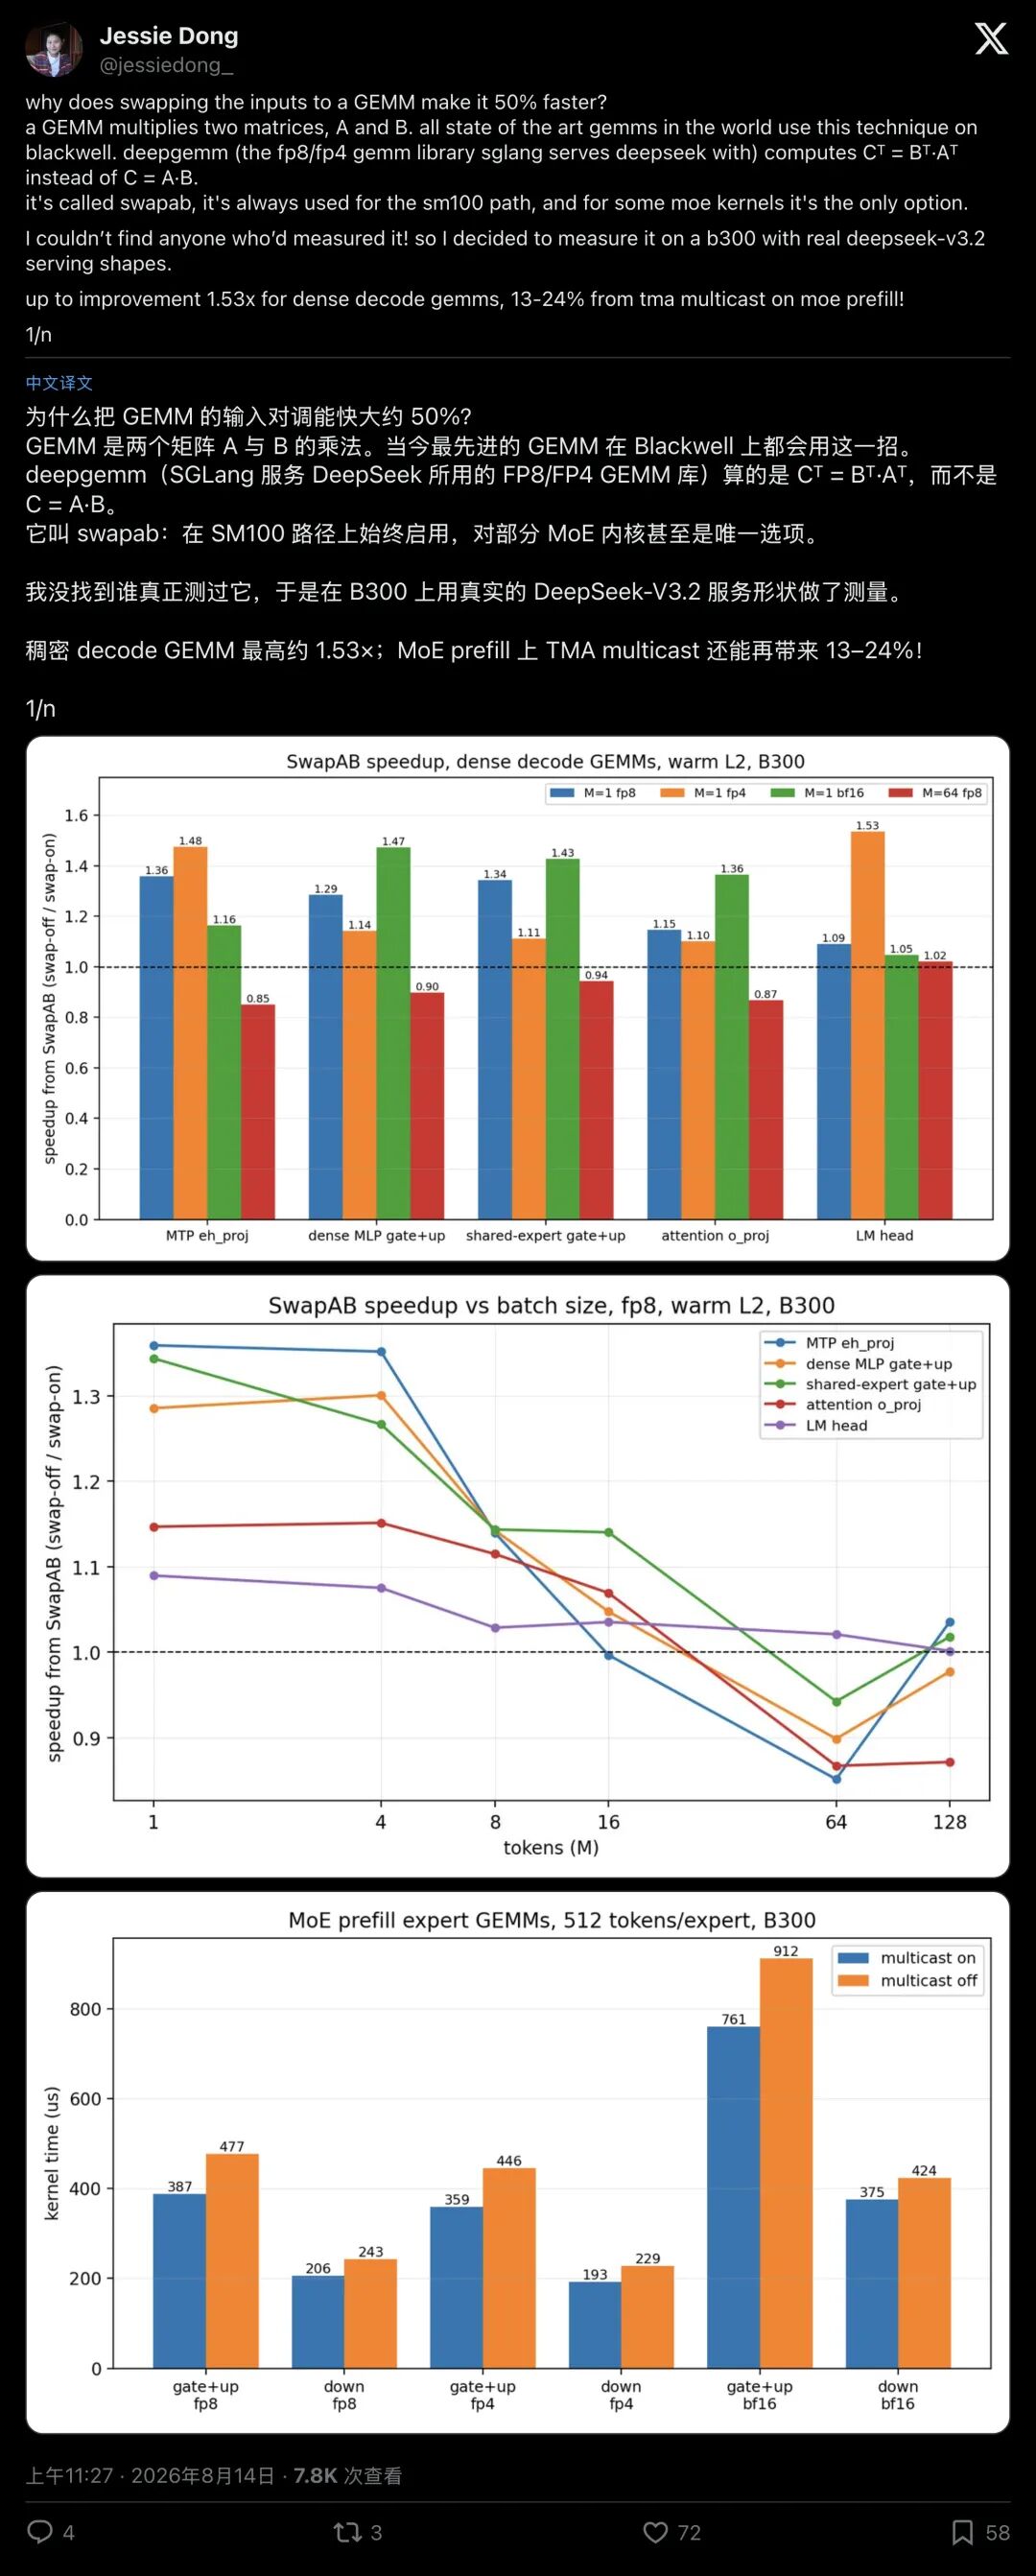
从数学上看,矩阵乘法是C = A×B。但在Blackwell张量核中,执行单元属于非对称排布,处理行方向(M轴)与列方向(N轴)时,在灵活性和指令吞吐方面存在细微差别。大模型处于单字生成的Decode阶段时,输入token极少,矩阵A的形态如同一根细长筷子,M很小。按常规方式送入计算单元,硬件管线容易因为“喂不饱”而出现大量气泡,计算通路只能等待。
由此出现的处理方式是转置:如果A×B跑不满,就将等式转换成C^T = B^T×A^T。初中数学即可证明两式在结果上等价;而在芯片内部,这一次转置将原本卡在M轴的瘦长形状转移到N轴,那里恰好是硬件更擅长吞吐的方向。实测显示,在B300显卡上运行真实服务尺寸时,仅这一处微架构层面的调整,就让密集矩阵推理速度提升1.53倍。
Mega MoE进一步把上述思路推向集成化:原本分散的“网络通信”、“两层矩阵乘法”与“SwiGLU激活函数”被融进一个单独的巨型内核,NVLink跨卡传输与张量核计算由此全部重叠起来。数据从网络总线冒出的同时,计算单元已在并行吞吐,芯片层面几乎没有毫秒级闲置。
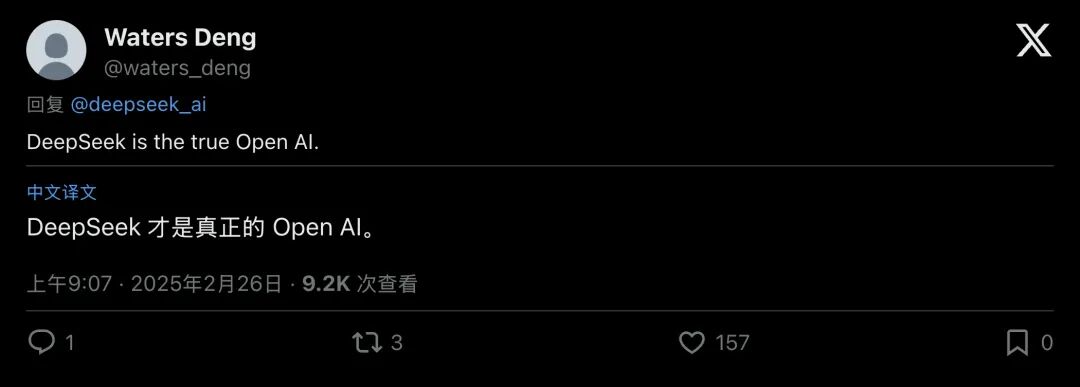
“True Open AI”的争论:为什么整套流水线被公开
在DeepSeek开源推文的评论区里,一条高赞留言被反复提及:“DeepSeek is the true Open AI.”
在相当长的时期里,“开源大模型”通常只是发布权重文件,再配一份带商业宣传色彩的说明。真正涉及核心壁垒的部分——让数万张卡不宕机、把矩阵乘法压榨到相近极限、再把每百万token成本降到几毛钱——不少厂商选择不对外展开。DeepSeek如今选择把整条生产流水线拆开呈现:从FlashMLA的注意力解码加速,到DeepEP的专家并行通信,再到深度挖掘GPU硬件性能的DeepGEMM。它们间存在咬合关系,构成一套精密链条,指向的核心判断是:大模型的竞争不是单纯依赖千亿美元采购芯片,更在于理解每一行汇编与晶体管能在什么条件下接近物理极限,用量化与工程做到尽可能逼真。
小结:DeepGEMM不是又一个大模型推理框架,而是面向FP8 GEMM与MoE真实负载的底层算子库。其在H800上是1350+ TFLOPS至最高1550 TFLOPS,在M=64等动态场景相对CUTLASS内核达2.7倍加速,并在B300上借助swapAB实现1.53倍提速。当“算力不够”成为行业共性瓶颈时,其价值在于:优化空间未必非要来自更昂贵的硬件,对现有硬件理解到多少也决定了获得多少可利用的效率空间。