据 InfoQ 报道,Akka 公布了一项围绕规格驱动 AI 辅助软件移植的实证研究。研究以 65 个开源项目为样本,考察规格说明的结构与上下文、模型与工作量设定、自动化验证、token 开销以及运行时性能。首轮实验持续 99.3 小时,共消耗 94.1 亿个 token。Akka 披露的数据显示,65 个受测项目中,有 57 个在代码行数或运行性能方面出现改善。
两阶段实验设计:先做 10% 功能,再挑 10 项全量落地
整个测试被拆成两步推进。第一步中,Akka 逐一分析这 65 个项目,为它们建立规格说明,每个项目最多完成 10% 的功能。随后参照系统特性与可量化结果,从候选中筛出 10 个进行完整的移植实现。整个交付管控流程依次为需求发现、规格定义、移植、基准测试与优化。在需求发现环节,团队需判断代码、模型、模式及运行时行为;实现、测试与审查工作由 Claude 结合 Akka Specify 完成;最后借助统一的基准测试运行器比对测试结果、代码规模与延迟表现。
结构化规格改善首版代码,跨组件上下文缺失成主要瓶颈
研究结论之一是指明规格的写法很关键:把声明、证据和类型化行为组织进规格之后,首次实现的完成度明显更好。反过来,上下文文件中未能覆盖跨组件决策所需的信息,被认为是当前最主要的瓶颈。Akka 列出后续可继续探索的方向,包括接口枚举、测试数据导入、溯源追踪、差异测试与对抗性测试。原文同时提到了 GitHub Spec Kit——它与 Akka 的思路类似,将编码代理的工作流按规格说明、规划、任务、实现和收敛几个环节加以结构化。
Sonnet 单项目 61 分钟,Opus 耗时翻倍但 token 省四成
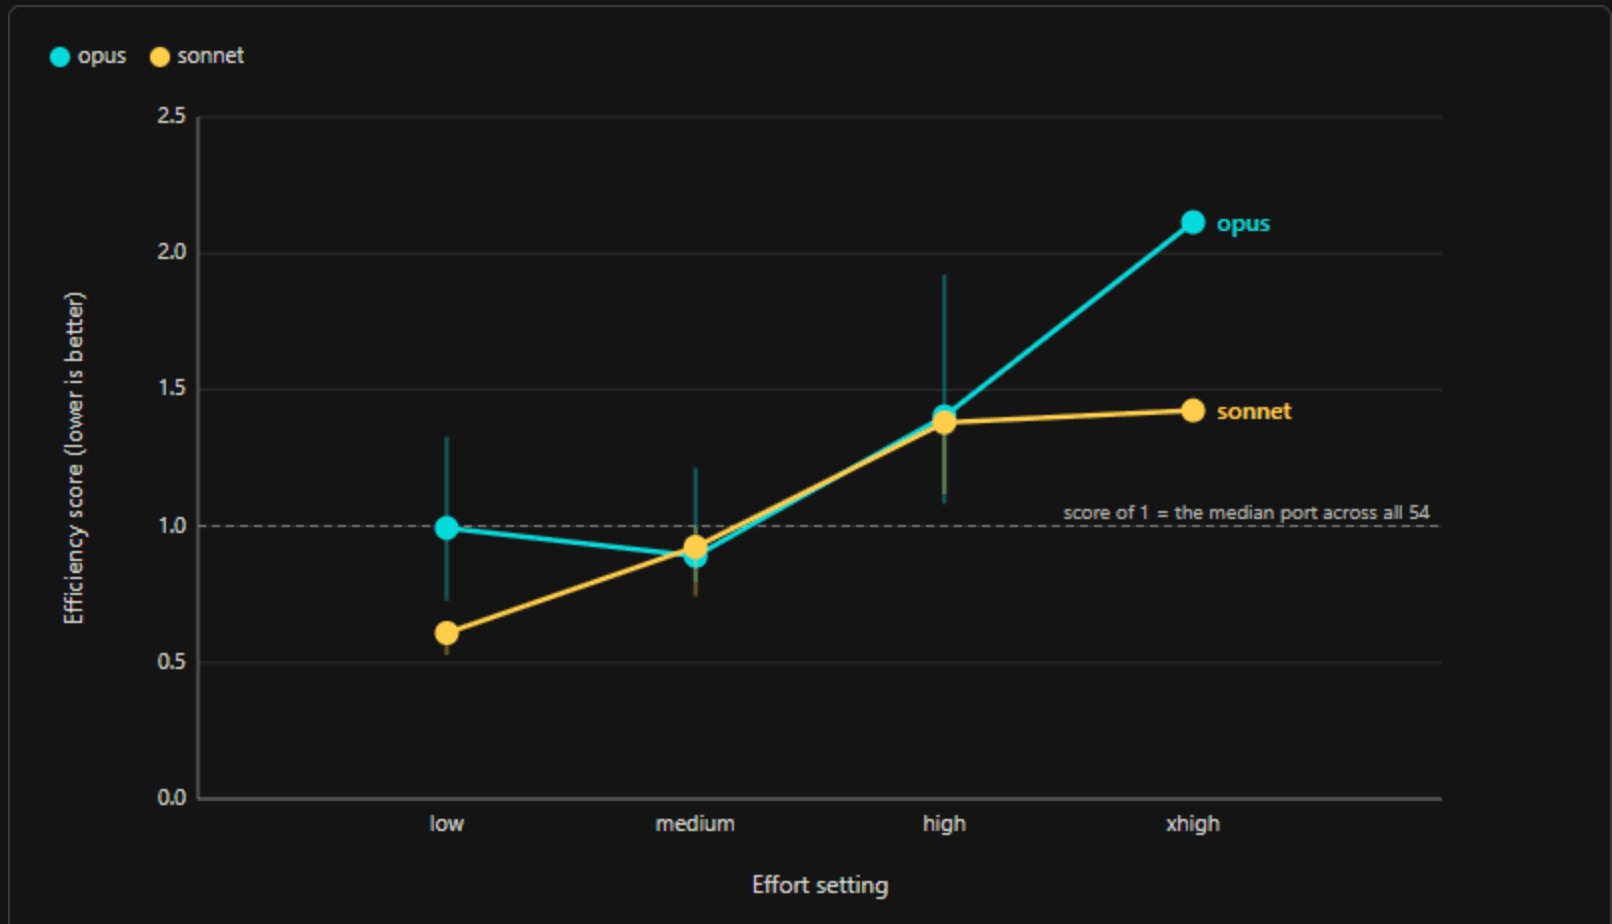
成本维度上,Akka 实测得到一组对照:Sonnet 完成单个项目平均用时 61 分钟,Opus 则要 120 分钟;不过后者消耗的 token 比前者少约 40%。另一个发现是,把工作量设置调高虽然会增加开销,却没有换来持续的效率增长,也就是说投入更多不等于收获更多。
验证依赖原始测试与人工审查,Dify 提速 143333 倍、Metaflow 慢约 100 倍
验证环节以各项目自带的单元测试与集成测试为基准,叠加人工审查序列化、安全性、错误处理、个人身份信息(PII)、幂等性以及架构边界等方面。伴随移植故障暴露出新情况,Akka 补充了防护手段,并指出退出条件的增加同样推高了成本。性能变化并不一致:应用、框架与库普遍跑得更快,基础设施与工具类项目则出现性能中位数下降。Akka 报告提到,Dify 的性能提升达 143333 倍,但所用的对照负载并不相同;Netflix Metaflow 的运行速度反而慢了约 100 倍。
工程师讨论:小模型严守规范,大模型偏向即兴调整
成果公开后在 LinkedIn 上引来工程师议论。Aaditya 在 Akka 首席执行官 Tyler Jewell 的博文下表示,小体量模型的表现与其在现代化改造中观察到的现象一致:小模型会老老实实按规范执行,大模型更容易按自己的判断临时发挥。他还追问,代码行数的减少主要来自死代码的清理,还是目标语言本身的差别。Avahi 市场部负责人 Rick Bryce 也加入讨论,认为各种限制条件同样可能左右最终结果。这些反馈把问题推向更深一层:移植效率的落差究竟由模型能力造成,还是规格约束所致,抑或两者叠加使然。Akka 对「更便宜的模型反而更精准」这一现象的评价是——值得进一步追问。
小结:这项覆盖 65 个开源项目的实证研究表明,把声明、证据与类型化行为写进结构化的规格说明,确实能提升 AI 首次生成代码的可用度,并推动多数项目在代码规模或性能上获得改善。但成本账并不简单:Opus 省下四成 token,却要多付一倍时间;缺失跨组件决策信息的上下文,成为效率的天花板。对所有考虑用 AI 做软件迁移的团队而言,「规格先行」是出发点,而非终点。