据云原生计算基金会(CNCF)近期公告,多集群、多云方向的 Kubernetes 编排项目 Karmada 已进入毕业阶段,也就是拿下了该基金会成熟度体系中的最高一档。这一档位只授予那些已被大范围采用、能够在生产环境中稳定运行的工程。相关决定是在上海举行的 KubeCon + CloudNativeCon + OpenInfra Summit + PyTorch Conference China 2026 大会上敲定的,时间点与项目 v1.19 版本发布重合。新版本强化了面向 AI 训练任务的跨集群多组件调度能力,同时把按优先级调度这一特性推进到 Beta 阶段,并且已设为默认可用。
在实际部署中,混合云、区域级故障切换、规避单一厂商绑定等诉求,往往都指向同一个做法:让同一个应用跑在多套 Kubernetes 集群上。以往实现这一点,要么自行编写自动化流程,要么依赖已经归档的 KubeFed。后者要求团队额外掌握一套联邦资源 API(federated-resources API),使用灵活度也受到限制。与此同时,GPU 算力被切分到不同地域与不同云厂商,做分布式 AI 训练和推理的团队因此遇到一个现实瓶颈——没有哪一套集群能单独提供足够多的加速卡,负载不得不在多套系统间拆解、分配与搬迁。
v1.19 带来什么:优先级调度转为 Beta 并默认启用
本次随毕业一同亮相的 v1.19,核心变化集中在调度层面。基于优先级的调度能力从实验阶段上升到 Beta,并默认打开,无需额外开启开关;对 AI 训练这类需要把多个组件协同铺开到不同集群的场景,调度器有了更强的编排手段。这也是该项目在分布式训练加速卡资源分散问题上的直接回应。
沿用标准 Kubernetes API,不改动现有清单与控制器
Karmada 这个名字来自 Kubernetes Armada 的缩写。它的设计取向并非另起炉灶替换 Kubernetes API,而是叠加在标准 API 之上,因此已有的清单文件、控制器和周边工具拿到 Karmada 控制面上照样能跑,无需修改。该控制面包含三部分:Karmada API Server、Karmada Controller Manager 与 Karmada Scheduler,状态数据存放在独立的 etcd 实例中。
放置策略通过两个自定义 API 来描述。其一是 PropagationPolicy,它把一条策略与一组工作负载对应起来(1:n),并规定调度与分布方面的约束,涵盖集群亲和性、多集群拆分与再均衡,以及跨区域、跨可用区、跨集群、跨服务商的多维高可用。其二是 OverridePolicy,运维人员可以据此改写与具体集群相关的配置,比如按地域替换镜像前缀、按云厂商替换 StorageClass,而底层资源模板不必做任何改动。
四个控制器如何把工作负载推送到成员集群
在整个机制内部,负责传播的是四个控制器。Cluster Controller 管理已注册成员集群的生命周期;Policy Controller 监听 PropagationPolicy 对象,把匹配到的资源绑定成 ResourceBinding;Binding Controller 再把每一个 ResourceBinding 转化为面向各集群的 Work 对象;Execution Controller 则监听这些 Work,并把生成的清单下发至每个成员集群自有的 API Server。
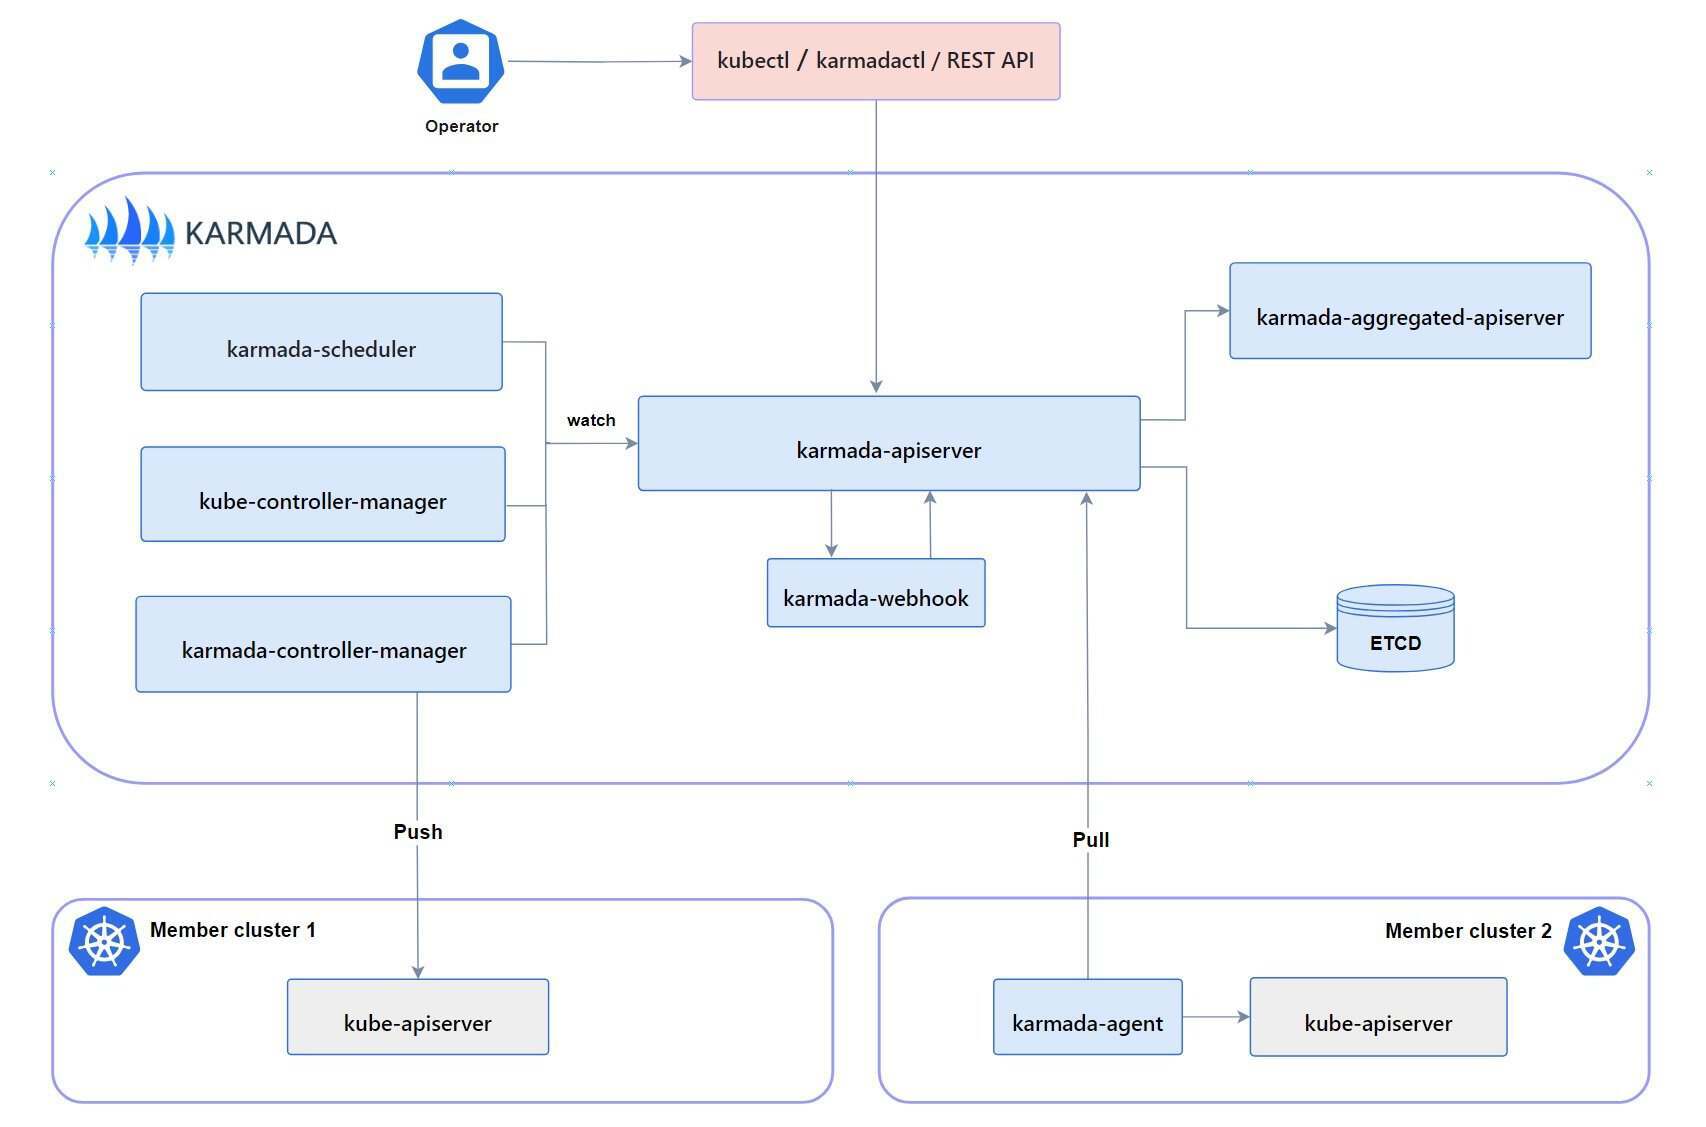
在可观测与部署方面,Karmada 会从控制面组件导出 Prometheus 指标,同时提供用于安装的 Helm chart,因此可以直接融入现有的 CNCF 可观测性与部署工具链,不必再维护一套独立设施。
贡献者超 1214 名、星标超 5600,生产采用者覆盖多家企业
回顾项目历程:2021 年 9 月 Karmada 进入 CNCF Sandbox,2023 年 12 月升入 Incubating 阶段。此后社区持续扩张,目前已有来自 292 家组织的 1214 名以上贡献者,GitHub 星标数量突破 5600。已在其生产环境中使用的名单包括 Bloomberg、Wellhub、Alibaba Cloud、Huawei、Trip.com、Bilibili、iFLYTEK、JDCloud、Kuaishou、RedNote、SenseTime、Vivo、WPS 与 ZTO,用途涉及混合云算力、跨区域韧性、面向 AI 负载的 GPU/CPU 调度以及全集群范围的配置分发。为达到毕业标准,该项目通过了第三方安全审计,成立了正式指导委员会,采纳 CNCF 行为准则,并持续持有 CII 最佳实践徽章。
该项目 TOC 赞助商 Chad Beaudin 表示,组织规模一旦超出单套 Kubernetes 集群的承载范围,就需要一种不增加复杂度的统一管理方式,Karmada 的做法是扩展团队已熟悉的 Kubernetes API,让它跨集群、跨云生效,从而化解这一难题。
Trip.com 高级开发专家 Yue Honghui 表示,Karmada 在该公司多集群基础设施中已是关键组成,并在生产环境体现了明显价值:无需改动现有 Kubernetes 资源定义,就能把多套集群当作统一资源池运营,支撑跨集群弹性与故障转移,加快新集群投产速度,并在对应用影响极小的情况下完成大规模工作负载搬迁。
与 OCM、Cluster API 及 GitOps 工具的分工
在被废弃的 KubeFed(Federation v2)之后,接手其定位的 CNCF 项目有两个:Karmada 与 Open Cluster Management(OCM)。OCM 仍处于 Sandbox 阶段,走的是中心辐射式、基于代理的路线,重心在集群清单与附加组件 API 上,支撑 Red Hat Advanced Cluster Management,偏重治理与策略分发。Karmada 侧重工作负载放置与动态调度,并带有服务于跨集群资源查询和多集群服务发现的缓存层。更大的生态里还有聚焦集群生命周期而非工作负载放置的 Cluster API,以及 Argo CD 的 ApplicationSets、Rancher Fleet 这类 GitOps 工具;微软的 KubeFleet 同样在此列,它是 Azure Kubernetes Fleet Manager 的基础。
小结:Karmada 完成 CNCF 毕业并同步推出 v1.19,标志着多集群 Kubernetes 编排进入生产级成熟阶段;优先级调度转为 Beta 并默认开启,直接面向加速卡分散条件下的分布式 AI 训练调度需求,与仍处 Sandbox 的 OCM 形成不同的技术取向。