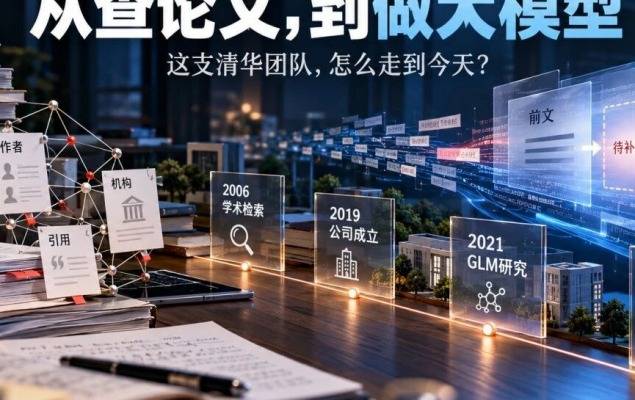
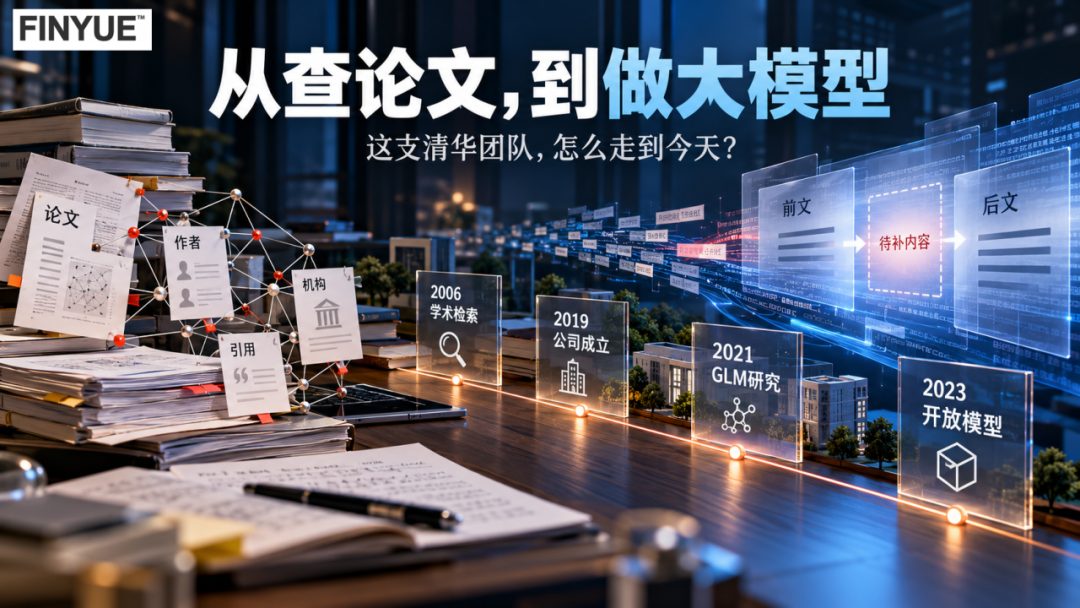
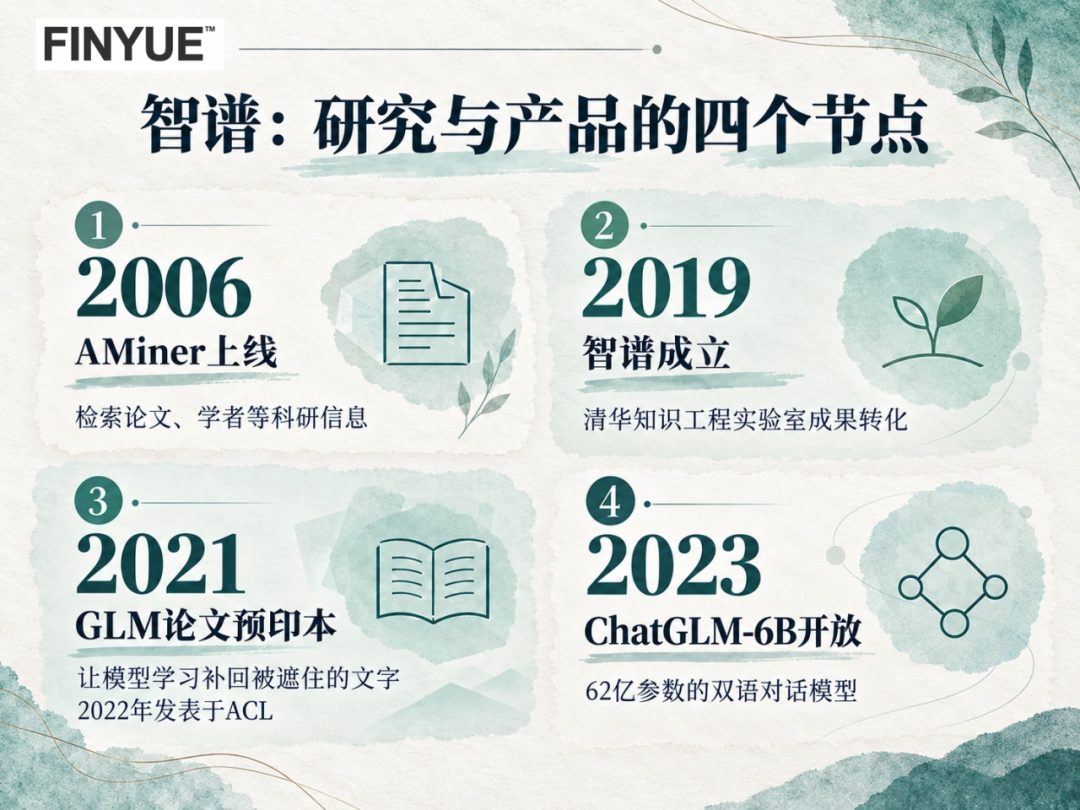
智谱与GLM的研究起点并不在模型本身,而要从清华一项学术信息平台工作说起。2006年,清华大学一支团队着手研发学术信息平台AMiner,相关研究与后续创业,最终通向智谱的建立和GLM大模型的研发。
AMiner先在论文与人之间建立连接
AMiner把论文题名、作者和发表信息彼此串联:读者锁定一篇论文之后,既可确认作者身份与发表出处,也能顺作者线索继续追踪相关成果。论文与论文同样存在关联——一份研究可能引用先前的成果,日后又被别的研究引用,这些引用记录都被纳入平台的学术信息网络。由此,从单篇论文出发,读者能够持续发现与之关联的研究。
论文规模膨胀后,准确判定作者归属变成一项关键能力。研究者需要避免把同名但不同人的论文混为一谈,也要防止同一作者因更换工作单位而导致既有成果被割裂。这类任务被业内称为作者姓名消歧。
作者所在的高校或研究机构可作为身份判断的线索,但机构信息可能随职业变动而改变,单凭此项难以定论。研究团队还会把论文合作者、发表记录等多种信息结合使用,从而判断哪些成果应归属同一人。这也是唐杰团队在学术网络和知识关联方向上的重点课题之一。
2019年:清华成果落成一家公司
唐杰长期从事数据挖掘、知识图谱与人工智能研究,同时也是AMiner的重要研究者。2019年,清华大学计算机系知识工程实验室的相关技术成果构成智谱的创业基石,团队以独立公司的组织形式开启研发与经营活动。
公司成立之后,科研成果还须转化为可长期使用的产品与服务。团队除了研究算法,还要持续训练模型、调度算力资源、部署并维护服务。模型研发因此不再是一次性的研究课题,而成为需要长期资源投入的事业。
2026年1月的《中国企业家》采访梳理了智谱三位核心人物各自承担的职责。唐杰以首席科学家身份延续人工智能与知识工程方向的研究,与团队早年清华时期的长期科研一脉相承;张鹏作为首席执行官,主导模型研发、产品开发与工程服务。模型能回答问题是基础,但要支撑大量用户持续访问,还必须统筹算力资源、响应速度与服务的平稳运行。一位早期投资人回忆,当年曾与张鹏讨论在每秒数万次查询量下如何设计响应延迟,这既是当时的工程目标,也说明了模型从实验室走向线上服务需要跨越哪些障碍。
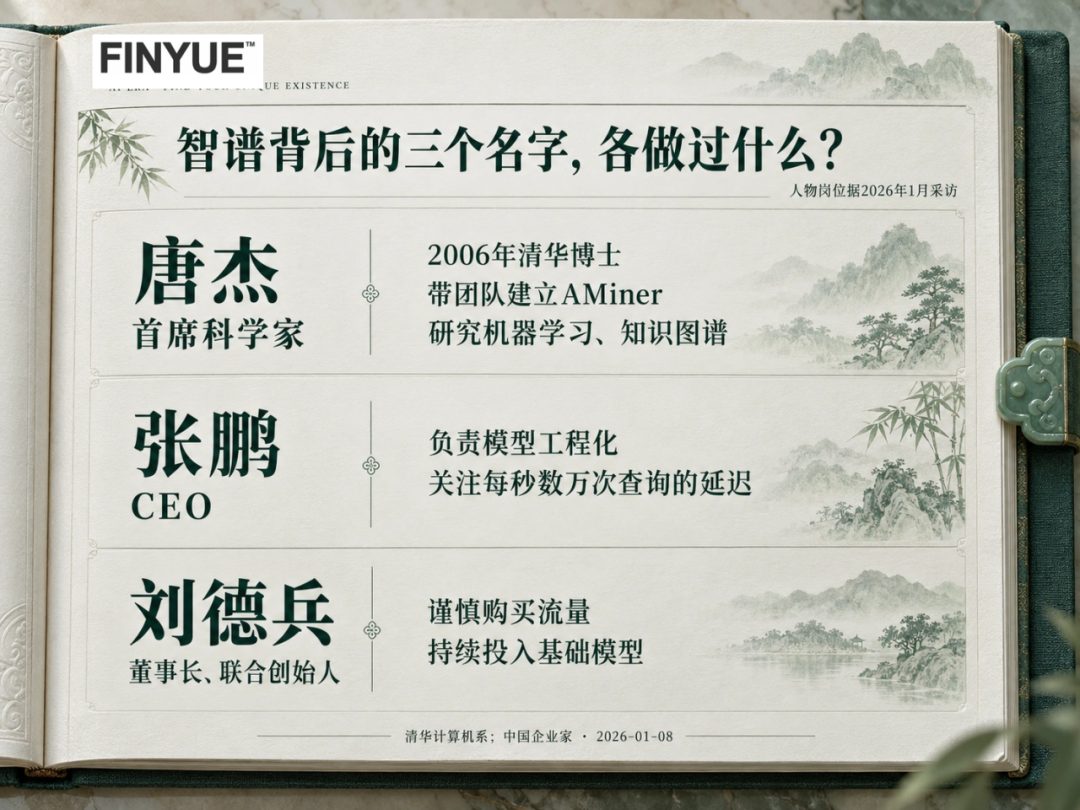
智谱联合创始人、董事长刘德兵参与公司战略和经营决策。他在采访中提到,2024年前后,智谱倾向于把资金持续投入到基础模型的迭代上,而非大规模采买广告流量。原因是基础模型的成果能够同时支撑个人应用、开发者调用以及企业级服务,这些业务虽然面向不同人群,但都依赖于模型能力的不断进展。
GLM的起点:用空白填充同时练会理解与生成
GLM为General Language Model的缩写,中文一般称作通用语言模型。2021年,清华团队对外公布该研究的预印本,正式论文于2022年刊发于计算语言学协会年会ACL。此研究的初衷,是让同一套训练方式兼顾文字理解和文字生成两类任务。
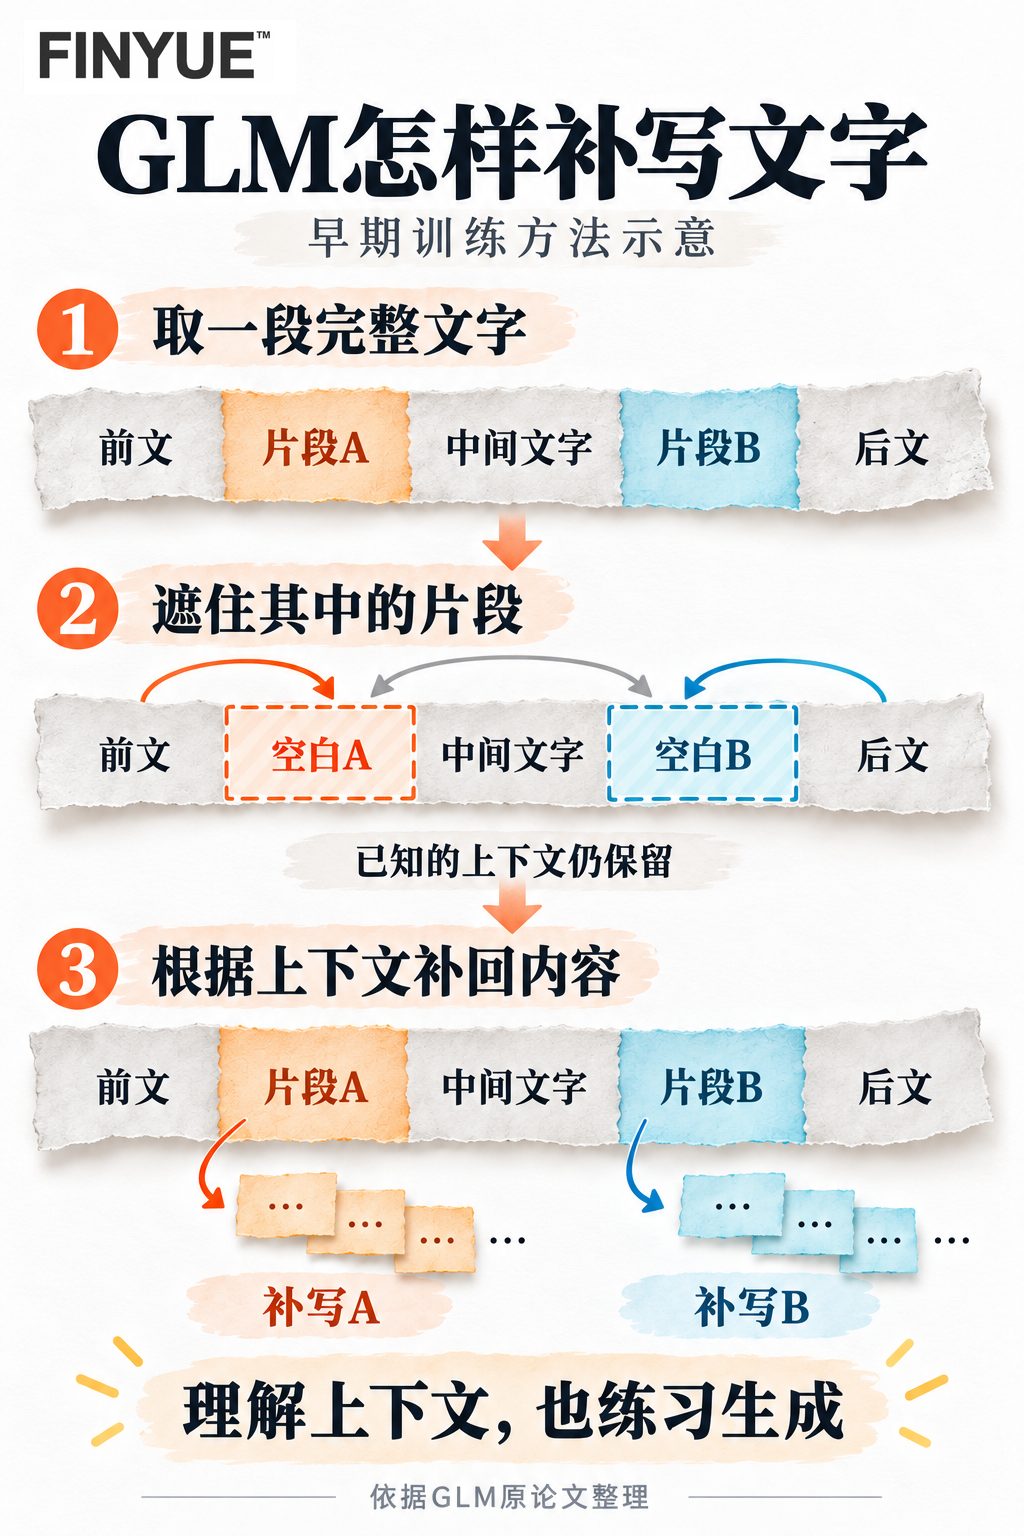
在训练方法上,GLM采用自回归空白填充:先保留原文的大部分内容,再把其中一处或多处连续的文字片段遮蔽,形成待补写的空白。模型根据保留的前文、空白之间的文字以及后文,逐段生成缺失内容,使补出的文字与上下文自然衔接。
沿着这条技术路线,智谱与清华团队在2023年开放了ChatGLM-6B。该语言模型参数量约62亿,能够完成中英文对话,让更多开发者得以接触GLM系列研究。开发者可按许可取得ChatGLM-6B训练好的模型权重,在算力条件符合的设备上运行,并将其用于科学研究或自建软件项目。公开模型权重意味着开发者可以在既有成果的基础上继续推进工作。
2025年7月28日发布的GLM-4.5,把推理、编程与工具调用定义为主要能力,其定位已不止于文字问答,还能围绕具体任务书写代码、调用外部工具。2026年2月12日发布的GLM-5,进一步指向大型软件工程以及需要连续执行多步操作的任务。
智能化能力从最初的理解与生成,逐步向编程等更复杂的工作延伸。从学术信息网络到语言模型,研究对象与待解问题都发生变化;AMiner和GLM并非同一项技术的简单升级,但串联起来,可以看到一段延续多年的研究进程。新模型露面的日子较容易被外界记住,而更漫长的积累,常常隐藏在此前那些不被注意的年份里。
据原文引用,可查证的依据包括智谱《关于智谱与发展历程》、清华大学计算机系唐杰介绍、2026年1月8日闫俊文《对话智谱董事长刘德兵:中国OpenAI的生死竞速》、Du等2022年ACL论文,以及清华大学与智谱2023年发布的ChatGLM-6B资料、Z.ai在2025年7月28日和2026年2月12日分别公布的GLM-4.5与GLM-5信息。
小结:GLM的底层方法源自清华从AMiner时代积累的学术网络与知识关联研究,转向语言模型后又以自回归空白填充避开单一的理解或生成路线;从ChatGLM-6B约62亿参数开源,到GLM-4.5强化推理、编程与工具调用,再到GLM-5面向大型软件工程,使国内开发者在开源模型权重、后续编程与智能体能力上都有了新技术选项。