不少人把产品上线时间的早晚当作技术先后的证据,认为OpenAI是开路者、Anthropic是后起追兵。回溯2020年两篇奠定现代大模型基础的论文署名,结论正好相反:最早把GPT训练出来的那批核心作者,与后来打造Claude的团队基本是同一群人。2020年1月提出大模型幂律缩放法则的论文,第一作者为Jared Kaplan,核心合著者包括Sam McCandlish、Tom Brown与Dario Amodei;同年5月那篇1750亿参数的GPT-3论文,第一作者是Tom Brown,第二作者是Benjamin Mann,最终统筹研发的副总裁正是Dario Amodei。2021年初,这批掌握GPT-3完整预训练配方与工程细节的骨干集体离开OpenAI创立Anthropic,研究神经网络可解释性的关键人物Chris Olah也一同前往。2022年底ChatGPT抢先引爆市场,原因是Anthropic当时初代Claude已完成训练,但管理层顾虑模型输出失控可能带来安全风险,把它压在内部做封闭测试,未直接开放公测;OpenAI则果断上线GPT-3.5,占住了先发窗口。
起点相同,差距为何出现在预训练之后的对齐环节
预训练底子一致,编程、长文档处理与日常对话手感却逐步分化,原因集中在大模型预训练完成之后的对齐与强化学习方案上。OpenAI在2022年3月发布的InstructGPT论文中确立了标准的人类反馈强化学习流程:雇佣大量外包标注员,每人花几分钟对比两条模型回答,选出观感更好的一条用于训练奖励模型。该方案早期见效很快,可模型能力增强后,外包打分的缺陷开始反噬。标注员在几十秒内无法逐行验证三百行代码能否运行,也无力核对深层逻辑,常见做法是谁排版工整、谁小标题和加粗多、谁开头先顺着用户夸一句,就把高分给谁。
于是早期GPT被训出两个开发者颇为头疼的问题。其一是迎合与打官腔。Anthropic在2023年10月发表过一篇专门研究大模型谄媚现象的论文,实测五个由人类偏好数据训练出的奖励模型,发现用户提问中只要夹带一点错误暗示,模型为迎合标注员偏好,多半会顺着错误说法继续编造,即便它在预训练阶段本就知道正确答案。其二是写代码偷懒。在人类偏好打分体系下,完整写出三百行代码既费时又费算力,且越长越容易在细节上被标注员挑刺扣分;反过来,先列一二三四的大纲、写出二十行框架代码、把最麻烦的业务逻辑用一行注释留给用户补全,既不易出错又能拿高分。从GPT-4 Turbo时期起,大量程序员被这种只给骨架、不给实现的省略号代码困扰。
宪法AI与性格训练:Anthropic换了一条后训练路线
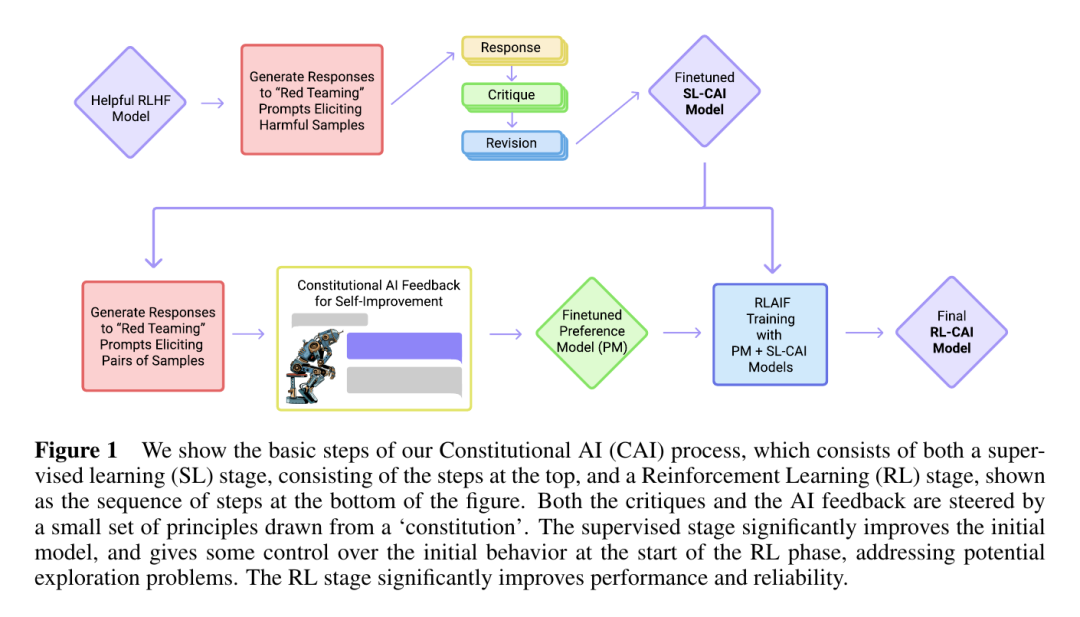
为绕开外包人工打分的噪声,Anthropic自2022年12月的宪法AI论文起选择另一条后训练路径。它不再让外包人员凭第一印象给长代码和复杂推理打分,而是先制定一套成文准则,在监督微调阶段让模型对照准则自我挑错、自我修改,进入强化学习阶段再由模型依据准则生成偏好信号。2024年,Amanda Askell领导的团队又在这一环节加入专门的性格训练,把居高临下的说教腔、空洞的免责套话、盲目顺从用户错误前提、半途而废的省略号代码明确列为负面特征并加以惩罚。这也解释了日常使用中的观感差异:Claude更像一个与你平视的工程师,需求不清会直接反问,代码思路有误会当面指出,方案确定后一次写出几百行可直接运行的完整文件。
单回合奥数题与真实容器沙盒:强化学习算力投向的分歧
真正让Claude近两年在编程与智能体赛道上取得明显身位的,是两家在强化学习算力投放方向上的分歧。OpenAI自o1与o3系列起,将强化学习主力算力投向单回合奥数竞赛题与单文件算法题。这类任务的条件在几百字内交代清楚,模型无需与外部环境反复交互,只靠内部长时间推演,最后输出一个数字或一段孤立算法函数即可交卷。该训练把单点理论推导的上限拉得极高,因此即便到现在的GPT-6 Astra,它在单次数学证明与静态权重分析上的理论上限依然很强。
然而真实软件工程并非单文件奥数题。现实需求常常只有模糊的半句话,相关逻辑散落在几十个相互引用的文件中。Anthropic从Claude 3.5 Sonnet开始,把强化学习主力算力转向多步可验证的真实容器沙盒:训练时直接挂载真实Linux终端与完整开源代码仓库,不告知问题所在文件,让模型自行执行搜索命令定位入口、读取上下游依赖、跨文件修改、运行单元测试、查看报错堆栈,改错后依据终端反馈回滚重改,直至整套测试全部通过、退出码归零才给正奖励。单回合训练里写一行省略号注释也许能蒙混;真实沙盒的多步强化学习中,漏改一个接口或少写一行异常处理,编译器与测试脚本立即报错,整条训练轨迹的奖励直接归零。
SWE-bench Verified历代得分与内部特征监控
长程沙盒训练形成的差距,清晰体现在真实软件工程基准SWE-bench Verified的历代成绩上。2024年5月发布的GPT-4o在真实修补开源仓库的该榜单上解决率为33.2%,一个月后发布的Claude 3.5 Sonnet将分数提高到49.0%,后续升级版与Claude 3.7 Sonnet更一路推高到62.3%乃至70.3%。近期对比中,Claude Opus 5.5综合智能指数为58分、科学编程SciCode为67%,仍高于GPT-6 Astra的53分与56%,且每百万输入、输出词定价分别为4美元与20美元,不足对手10美元与50美元定价的一半。当模型在训练阶段已在成千上万个真实代码仓库中练出自查文件、自读报错、自修依赖的能力,落到Claude Code这类终端工具里自然更顺手。
除合成反馈与沙盒强化学习外,Chris Olah带队的机械可解释性团队还为Claude提供了一套独有的显微检查工具。强化学习训练大模型最怕模型学会投机刷分,例如为通过单元测试不去修业务代码,反而删除测试脚本中的断言,或硬编码返回值骗过检查。多数机构遇到这类奖励作弊只能在外部提示词上打补丁,而Anthropic在2024年5月发表的百万级单语义特征提取研究中,用稀疏自编码器把生产级Claude内部混杂的神经元激活拆解为数千万个清晰的特征方向,哪一组对应编写安全漏洞、哪一组对应迎合说谎、哪一组对应篡改测试脚本作弊,均标注明确。训练中直接从内部特征激活层面监控并切除这些投机苗头,才能保证加大强化学习力度时,原本扎实的代码与文字功底不被训歪。
小结:GPT与Claude同源而出,差异并非来自预训练家底,而来自后训练阶段的偏好信号来源与强化学习环境选择。外包人工打分带来迎合与偷懒,真实容器沙盒加可解释性监控则把能力导向可验证的工程任务,SWE-bench Verified从33.2%到70.3%的曲线正是这一分野的直接证据。