刚记住一个模型,下一代又来了。GPT、Gemini、Claude,再加上国产模型,名字越来越长,会员也越来越难选。这篇先把版本和开放状态核清,再告诉你:写作、做研究、写代码,各该怎么选。
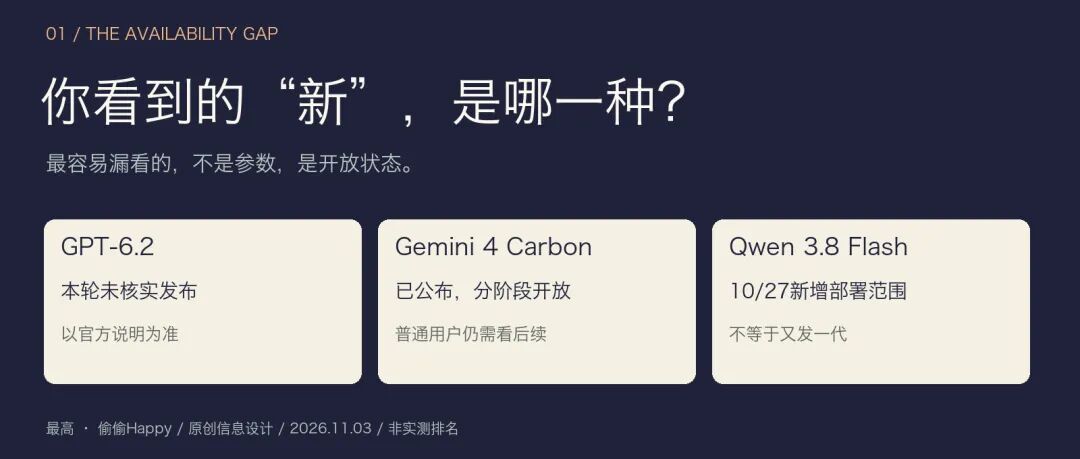
先回答标题提出的疑问:截至2026年11月3日本次核对,OpenAI官方文档里并没有查到GPT-6.2已经发布或可以使用的说明。[1] 目前该指南列出的型号只有四个——GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra和GPT-6 Luna。所以本文不会为一个尚未核实的名称编造参数。
公布了不等于能用:Gemini 4 Carbon为什么要分阶段放量
这一轮最容易被误读的是Gemini。Google已经对外宣布Gemini 4 Carbon,但公告中写明的是分批推进:第一步面向部分网络安全防御人员,第二步扩至可信合作伙伴,普通开发者、企业客户与消费者则要等后续安排。[2]
也就是说,即便看到Carbon的亮眼成绩,也不代表今天打开Gemini就能在列表里选到它,更不能把Argon上的使用感受直接算作Carbon的表现。模型对外公布、账号获得权限、具体产品完成接入,这是三件彼此独立的事。
本文谈的是近期这一波更新的当下状态,而非“某一天同时上线了六个模型”。具体能不能用,还得看自己账号所在地区、所用产品与套餐级别。
GPT四个型号各管什么:别只看小数点后的差别
据OpenAI当前指南的分工,Astra被放在高难度推理、代码以及专业任务的位置;Sol的优点在于复杂工作中兼顾成本与速度;Terra侧重读图、操纵电脑和自然写作;Luna则对应目标相对集中的大批量处理。[1]
怎么理解这种划分?写一段活动介绍,与翻阅大量材料后再核对预算,本就不该占用同一类资源——前一种场景看重表达顺畅和响应快,后一种更依赖证据、计算过程和长任务的稳定性。
我的建议是:平日用一个各方面均衡的型号,真遇到卡壳的难题再切换升级。不要因为“6.1在数字上比6多了0.1”,就断定它在任何工作上都胜过Astra,名字里的版本号和实际定位不能互相替代。��后GPT-6.2若有官方发布,值得重新比一轮;眼下先看那些已经核实、自己也拿得到的选项。
Gemini盯住长任务,也要看清开放边界
Carbon的公告把重心放在持续的软件工程、复杂推理与网络安全工作,并说明它以Argon为基础演进而来。[2] 对读者真正有用的信号是:模型间的较量正越来越深入到“接到任务之后,能连续推进多久”。
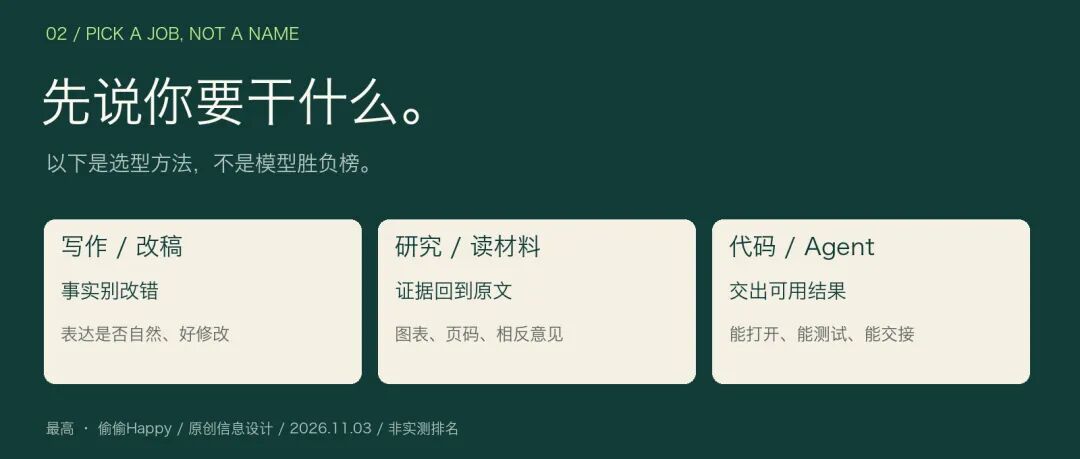
不过这不等于人人都要等Carbon。如果你平时主要整理访谈、读报告、比对图表,不妨先用手上已有权限的Gemini型号,检验它能不能定位原文出处、准确区分图表里的各个项目、在材料互相矛盾时点出分歧。
这是一种选型思路,并非本文做过的横向实测。能装进更多材料,也不代表每个细节都会读对;与其让它自称“理解完整”,不如要求它附上来源页码,这样更实用。
Claude除了旗舰,中小型号值得认真试
Claude的官方更新记录里,有9月22日的Opus 5.5、9月28日的Sonnet 5.5,以及10月7日的Haiku 5.5。官方将Sonnet定位为更快、更省钱的补充,把Haiku对准调用频繁、对成本敏感的任务。[3]
对内容创作者而言,真该问的是:改过十遍之后,它是否还记得哪些事实不能动?对开发者来说,则是:改动能不能通过测试,失败时能不能交代清楚原因?
操作上可以先以Sonnet这类均衡型号承担主线工作,把旗舰留给棘手问题;而标签提取、格式整理这类小活儿,值得试试更小号的模型。这种分工是编辑层面的建议,不是已经证实某型号必赢的排行榜。
此外,Claude Duet在更新记录中属于主动式Agent应用的研究预览,不应被误当成为又一个基础模型。[3]
Kimi的看点:能造出可用文件
Kimi在10月23日的官方公告里推出K3.1 Pro,写明它具备百万Token上下文,并改进编码、3D创作、金融研究等Agent能力;同篇还介绍了Highspeed版本。[4]
这里别把“百万Token”直接理解成“保证读完一本书”。它说的是容量上限,结果可靠与否仍要以任务输出为准。做研究时,可以让它先把材料里的证据列出来,再下判断;做页面或3D内容时,则要求它交付能打开、能修改的文件。
公告称其为开放权重型号。本文既没有下载权重包做核验,也没有进行本地部署测试。开放权重并不自动意味着普通电脑跑得动,更不等于部署、显存与维护没有成本。
MiniMax便宜占优,少返工更要紧
MiniMax在10月19日推出M3.1 Flash,主打Agent、编程与电脑操作,官方给出的API价格为每百万Token输入0.15美元、输出0.60美元。[5]
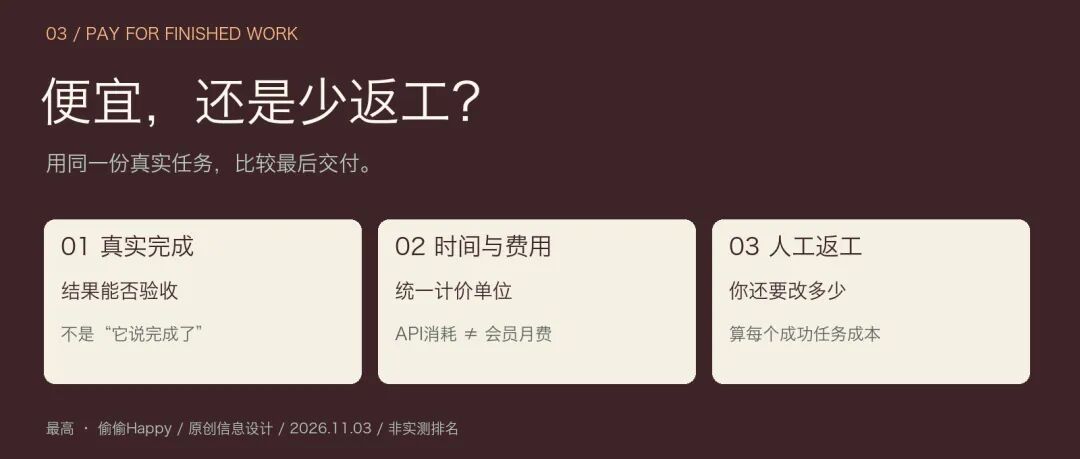
这组价格适合让开发者把它纳入候选名单,却不能直接与聊天会员的月费相比:API按实际调用量计费,会员还附带产品功能、使用次数和其他限制,两者计费单位根本不是一回事。
如果要批量整理商品资料、抽取文件字段或执行重复性工作,可以先用一小批真实任务试它,记录有效完成数量、等待时长与返工次数。便宜型号若总要重做,未必更省钱;贵一些的型号一次做完,也不能据此断定它在所有任务上都划算。
千问的更新是扩区,不是又发一代
QwenCloud在10月27日的记录写明:Qwen3.8-Flash新增德国法兰克福及中国香港部署范围,支持视觉理解、工具调用、结构化输出等能力,并列出原生百万Token上下文。[6]
这提醒我们,更新日志里的“新”有时指的是部署和接入方面的变化,而不是一个全新模型。对真正做产品的人,这类变动同样有价值:服务在哪些地方可用、接口怎么接、能否稳定嵌入现有程序,往往比型号名称更直接地影响决策。
如果只是聊天写作,不必为每个地区更新重新选会员;如果在做应用,则应再核对可用范围、价格和数据处理要求。把自己的需求摆在发布节奏之前,才不容易被带着跑。
该给谁付费:先做一轮自己的小测试
我的建议是准备三份自己真会用的任务:一篇需要改写的稿子,一份带图表的材料,一个需要实际执行并验收的小任务。给每一家提供相同材料、目标和完成标准。
写稿检验事实有没有改错、修改起来顺不顺手;做研究检验引用能否回到原文、有没有漏掉相反证据;执行环节检验文件能否打开、测试能否通过。不要只比谁的第一段回答更漂亮。
最终只记三个结果:有没有做完、耗掉多少时间和钱、你返工了多少。留一个日常主力,再备一个能应付其他难题的候选,比一口气买一排会员更容易判断价值。
这一轮更新真正值得讨论的,早已超出“谁答得最聪明”。GPT在细分工作角色,Gemini把目标推向更长的工程任务,Claude补齐不同规模的选择,国产模型则在争取研究、创作和执行三类工作。
对普通用户来说,最值得升级的时刻,是旧工具确实卡住了手上的具体工作,而新工具能用真实结果解决它。版本号能制造期待,结果才值得续费。
来源(2026年11月3日核对)
[1] OpenAI:Using GPT-6,https://developers.openai.com/api/docs/guides/latest-model
[2] Google:Introducing Gemini 4 Carbon,https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
[3] Claude官方更新记录,https://support.claude.com/en/articles/12138966-release-notes
[4] Kimi K3.1 Pro官方发布公告(10月23日),https://forum.moonshot.ai/t/kimi-k3-1-pro-has-launched-start-exploring-now/629
[5] MiniMax M3.1 Flash官方公告(10月19日),https://www.minimax.io/blog/minimax-m31f
[6] QwenCloud模型更新记录,https://docs.qwencloud.com/changelog/models
小结:截至2026年11月3日,GPT-6.2尚无OpenAI官方发布记录,Gemini 4 Carbon仍处分批开放阶段,各家真正能用的版本与权限并不一致。选型应以自建小测试的完成率、耗时与返工量为准,而不是被版本号推着付费。