一位长期使用Claude Code与Codex的开发者,近日分享了对GLM 5.3、KIMI K3和MiniMax M3三款智能体的实测体验,聚焦软件项目开发与学习辅导两类场景。其结论是:多智能体协同完成开发任务时,完成质量排序为Codex > K3(Kimi) >= GLM 5.3 > M3(minimax)。
使用轨迹:从ChatGPT、Claude Code到国产智能体
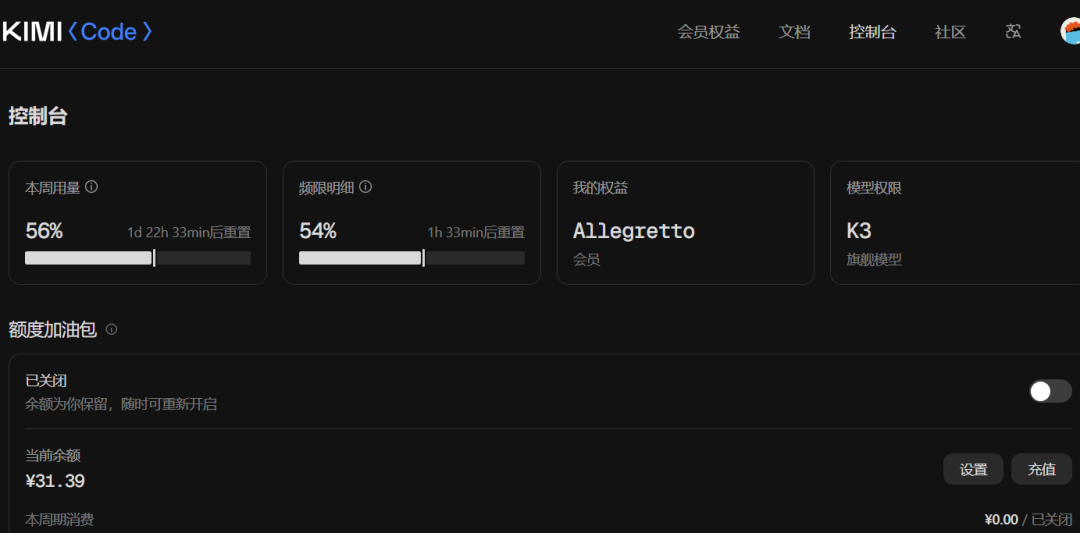
该开发者最初以ChatGPT配合VS Code和JetBrains全家桶起步,随后转向Claude Code并作为主力工具。由于Claude Code封号问题愈发常见,Codex接棒成为主要选择。半年前OpenClaw走红时,为保证随时可调用大模型,他订阅了MiniMax年会员,用于生成方案、表格等办公任务。此后Kimi K3发布,经测试他又开通K3的Allegretto会员,投入项目开发。此前使用Codex常遇到token不足的问题,他的过渡方案是先让K3输出方案或代码,再交Codex评审,验证下来效果理想。GLM方面,因Coding Plan长期难以抢到,只能小规模试用,直到近期才购买Pro会员。
开发架构:GLM的Zcode做入口,多智能体分工协作
项目开发占其智能体使用场景的90%。当前采用的架构是:以GLM的Zcode图形界面作为开发入口,通过无头命令行方式调度K3、Codex与mcode(minimax)协同作业,GLM承担调度者与裁决者角色。以撰写项目需求文档为例,他会先提出功能改进的初步设想,交给GLM牵头组织其它智能体讨论并汇总为最终文档。讨论过程中,各智能体会提出大量需求意见,其中部分意见可能波及项目原有功能。综合实际使用体验,他给出了前文所述的任务质量排序,并预告后续将逐一举例说明。