决定一款AI模型能否真正走进生产环节的关键,并非某一次作答显得多机灵,而是它能不能以企业负担得起的开销,把繁琐工作稳定地完成到底。
9月20日,阶跃星辰对外推出新一代旗舰基座模型Step 5 Preview,主要瞄准AI编程、软件工程以及专业知识类工作场景。按照官方透露的信息,该模型走的是稀疏MoE路线,整体参数规模达600B,但单个Token仅调动27B参数参与计算,同时具备100万Token的上下文窗口与视觉输入能力,完整权重定于10月15日放出。
证券时报旗下人民财讯对本次发布进行了报道;第三方评测机构Artificial Analysis当前页面数据表明,Step 5 Preview在其综合智能指数上拿到44分。不过相较具体排位,发布方将宣传重心落在了智能水平与任务成本之间的取舍上,这一点更值得琢磨。
600B总参数为何每次只启用27B
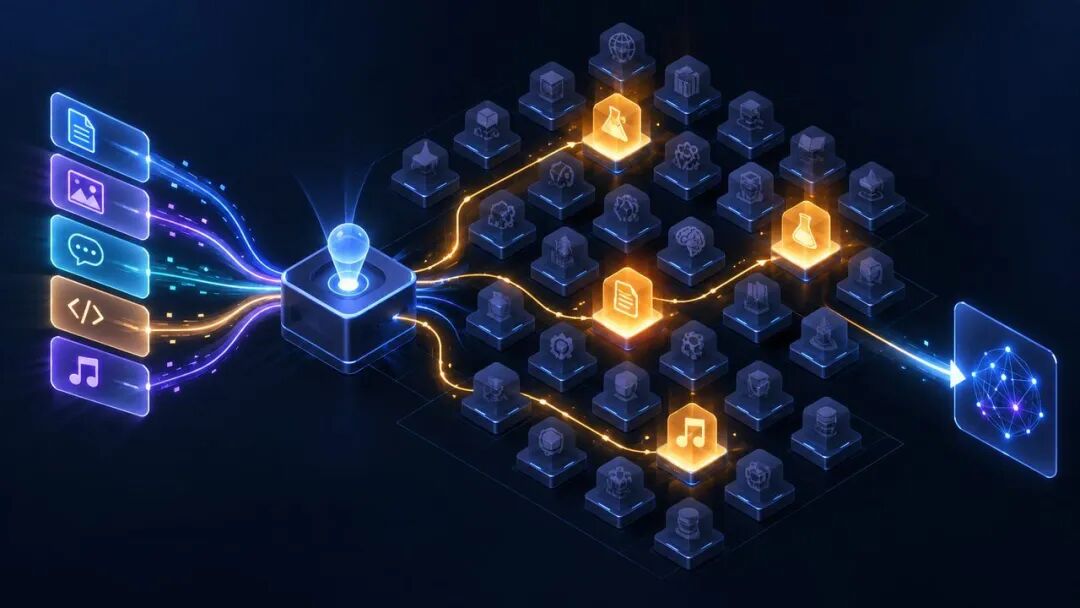
可以把MoE想象成一支拥有众多专家的队伍。遇到不同任务时,路由机制并不会令全部专家一起开工,而是筛选出最匹配的少数几个投入运算。如此一来,模型既保住了大规模参数所承载的知识储备,又不必在每次推理时都为全员计算买单。
然而激活参数偏少,并不意味着必然又快又省钱。实际开销还与生成长度、推理轮次、工具调用次数、缓存命中比例以及任务是否要反复重试挂钩。Artificial Analysis的数据显示,该模型在现行测试中的输出定价在同档次里偏低,可它的回答也显得比较啰嗦。因此企业真正该盘算的是完成一项达标任务总共花费多少,而非只盯着每百万Token的标价。
竞争焦点转向模型能持续工作多久
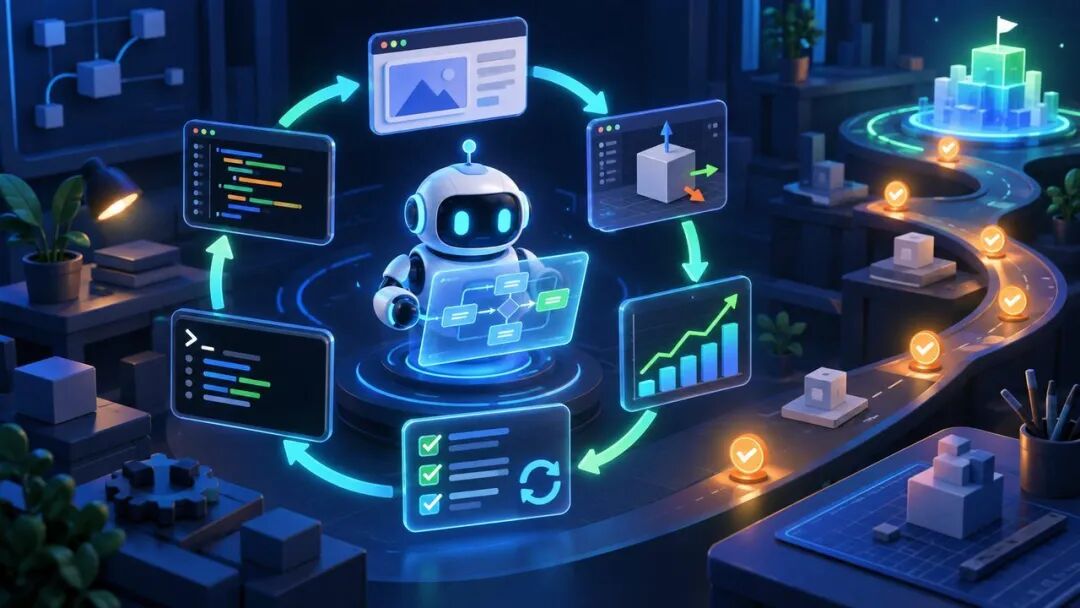
早先的大模型演示往往是一问一答的形式。步入智能体阶段之后,模型得自行拆解步骤、调用工具、运行代码、读取结果、察觉差错并接着修正。任务时长从几分钟延伸到几小时乃至更久,模型的短板也随之换了位置。
阶跃星辰公开了一项长达24小时的GPU内核优化实验:模型不断写代码、跑测试、比对吞吐量,并留下表现更优的方案。官方还展示了长程游戏任务与大规模资料搜集的案例。这些案例眼下大多出自发布方之手,无法顶替独立复现,但它们准确捕捉到了一个走向:模型正由回答问题转向推进任务。
智能—成本前沿为何比跑分更关键
所谓帕累托前沿,通俗来说就是能力相当时开销更小,或者开销相当时能力更强。模型厂商开始把这条曲线挂在嘴边,反映出市场正在走向成熟。用户不会再单单纠结谁最强,而会考虑自己的任务交给谁最合算。
这同时说明单一综合得分的说服力有边界。同样拿到44分的模型,在编程能力、专业知识、速度、首Token时延和输出长度上可能大相径庭。在选购模型前,应当拿自身的真实业务做一轮小范围测试,并记下成功率、人工回改耗时、Token总消耗以及工具调用成本。
10月15日开放权重之后该看什么
倘若开放权重如期兑现,开发者就获得了在本地或私有环境里部署、微调与审查模型的机会。但开放权重并不等同于完全开源:训练数据的来源、训练代码是否公开、许可协议的限制、推理所需的资源以及量化后的实际效果,都会左右它上手到底有多轻松。
后续有三点值得盯紧:其一,公开权重和当下API版本能否对得上;其二,百万上下文在真实长文档任务里的有效利用率如何;其三,长程智能体案例能否被外部团队重现。唯有这些问题有了答案,发布会上展示的本事才算真正落为生态价值。
小结:Step 5 Preview把卖点押在智能与成本的平衡上,意味着大模型的比拼不再只是谁更聪明,谁能让真实任务以更低总开销稳定交付才是关键。权重正式开放后的版本一致性、长上下文有效利用率与外部复现结果,将决定这场转向能否兑现。