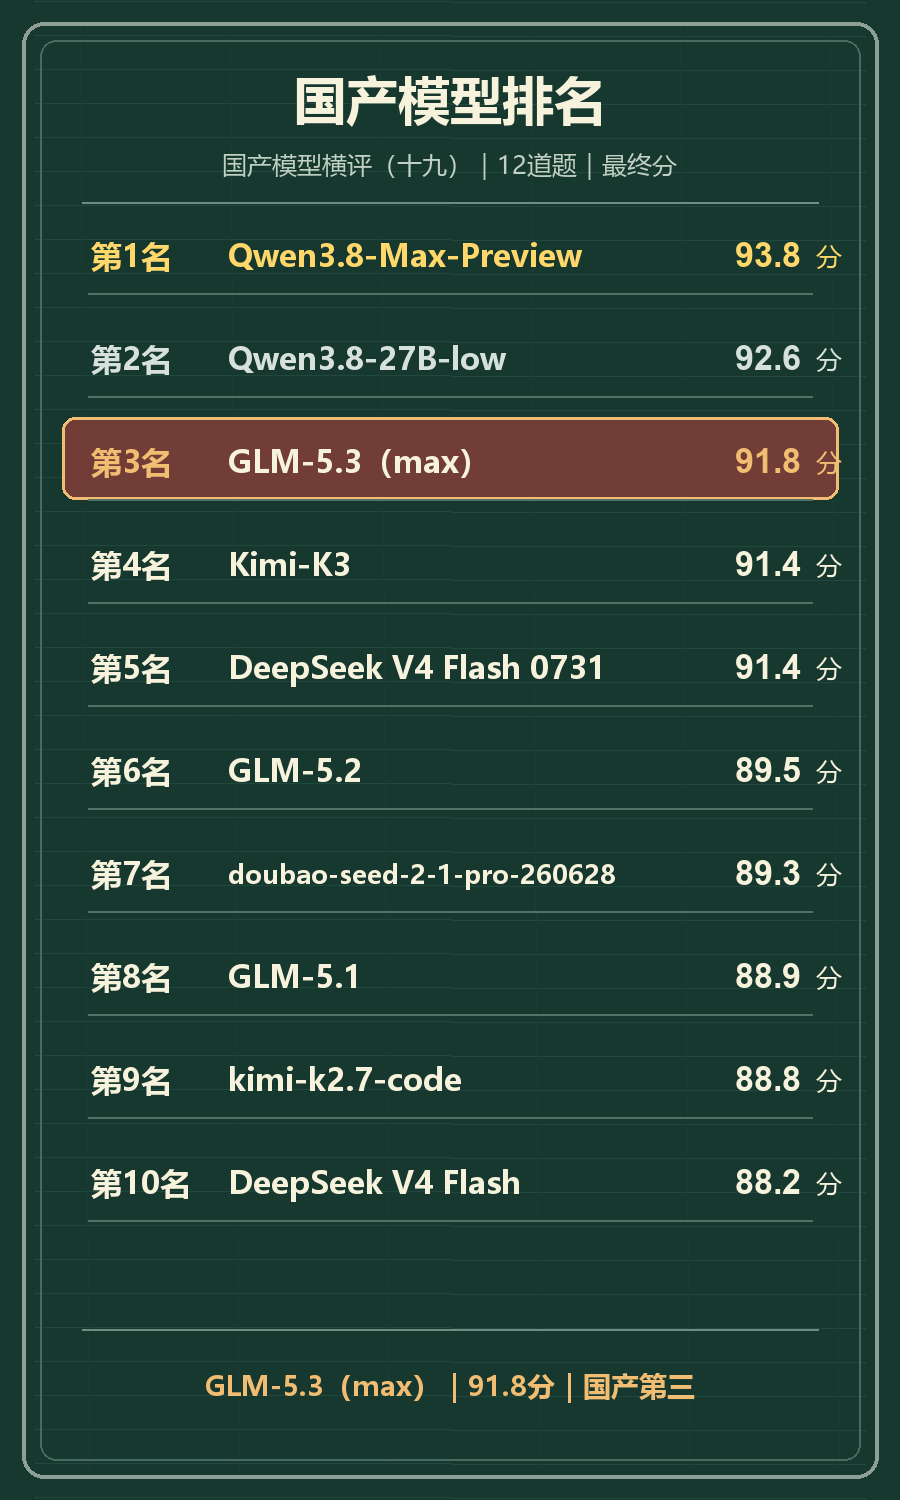
2026年8月29日完成的这一轮横评对象是GLM-5.3(max)。按v2.0评分口径计算,该模型取得1101/1200分的成绩,展示分折算为91.8分,在当时的国产模型榜单中排名第3。
评测口径迎新版:题库拆成三档,打分模型同步更换
据作者说明,近期更新节奏放缓有两个原因:一是事务繁忙,手上积压了不少已测试但尚未发布的模型;二是部分模型得分明显偏高,让作者开始反思原有题目是否已经偏旧。作者提到,aa此前也持续在修改题目,因此自己也投入到新题目的设计中,出题之后还需跑验证,比对模型得分与token消耗情况。目前v1版本的题目已大致完成,v2版本尚待验证。
后续的模型测评会并行维护三套题目:基础版即当前使用的这一套,原则是尽量跟随新模型保持更新;v1版本在基础版之上改良,题量与题型维持12题不变,但难度上调;v2版本则大幅拉高难度并扩充题量,共设24道题。v1与v2的榜单会一并纳入国外模型参与对比。由于这两个版本测试开销较大,不会覆盖全部模型,只挑选热度较高的模型进行评测。此外,打分模型也已更新,现阶段使用的是gpt-6-astra-max。
排名卡位第三:与前后位次分差不到1分
GLM-5.3(max)最终以91.8分落在国产模型第3的位置。排在它前面的是Qwen3.8-Max-Preview的93.8分与Qwen3.8-27B-low的92.6分;紧随其后的Kimi-K3与DeepSeek V4 Flash 0731同为91.4分。文中给出的分差计算方式为GLM-5.3(max)减去GLM-5.2。
各题型的得分分布如下:语言表达能力97分,空间推理能力99分,常识判断能力97分,数学计算能力97分,逻辑推理能力98分,macOS系统界面92分,3D户型图62分,Trello看板74分,Java REST API 98分,C++库存服务99分,会议室预订系统89分,团队知识库99分。
逐题得分明细:这些题交出了怎样的答卷
第1题语言表达拿到97分。10个句子均严格以「苹果」二字收尾,场景与句式也比较丰富,只有第5句词序稍显生硬,因此未能满分。
第2题空间推理得99分。模型正确处理了门洞法向与三维搬运路径的关联,并清晰指出5米只是在门框平面内的约束,竹竿可以顺着门洞法向穿出。解释较为完整,仅有少量限定条件还能表述得更严谨。
第3题常识判断为97分。模型把握住「车必须到店」这一关键点,决定开车去洗车。结论无误,但理由存在少量重复,对50米冷启动损耗的描述也略显武断。
第4题数学计算得97分。模型给出了(6-5)×4!×1=24,且未变动数字原有顺序。推导过程里出现了两次失败尝试,带来一些多余噪音。
第5题逻辑推理为98分。模型推得密码698,并对318 / 379 / 863 / 421这四组条件逐一回验。整体逻辑站得住,只是其中一条假设分支走得稍绕。
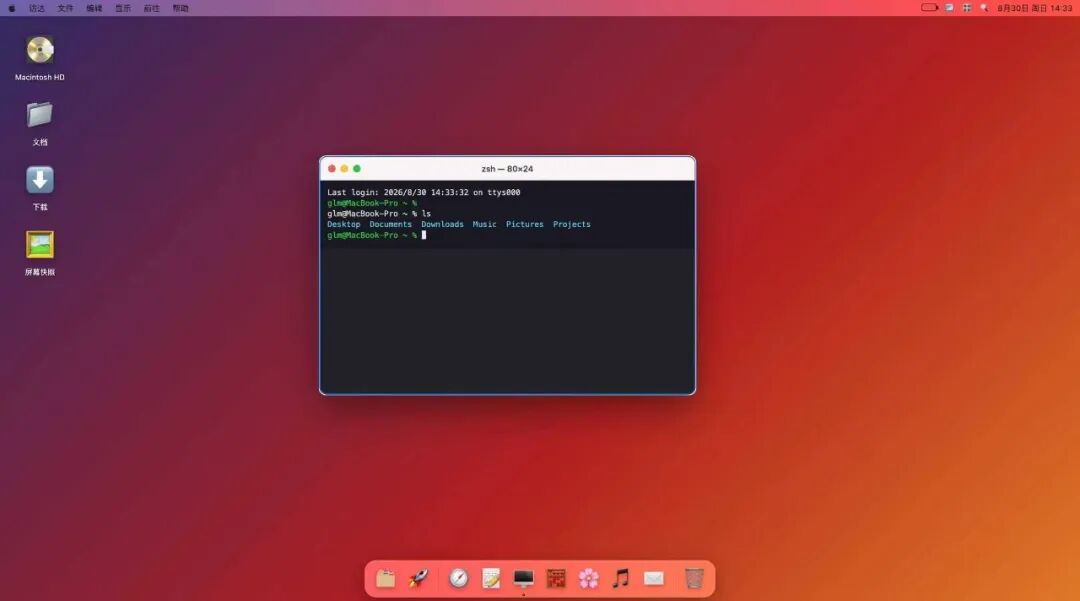
第6题macOS系统界面得92分。窗口、Dock、控制中心、通知中心、右键菜单等主要交互均已落地,完成度较高。失分点在一个细节:Notes窗口缩到最小之后,从Dock点击无法复原。这一问题不影响页面多数功能,却暴露出窗口状态管理尚未完全闭环。
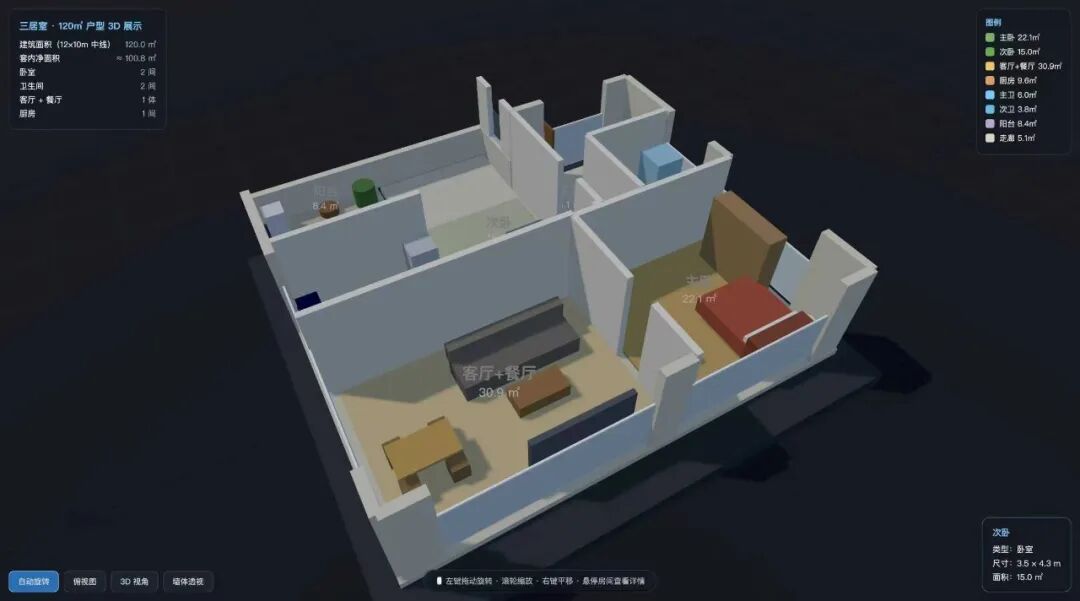
第7题3D户型图得62分。
这是本轮最突出的失分项。
页面的确做出了真3D、2卧2卫以及视角交互,但房间显式面积合计约100.9㎡,按几何并集算也只有100.813㎡,与题目要求的120㎡相差15.99%;楼板多边形面积却是132.509㎡,三组面积数据彼此对不上。
户型动线同样没有成立:主卫四周并不存在真实门洞,入户走廊同主起居区之间仅是坐标层面的缝隙,无法构成有效通路。页面乍看像一套完整户型,面积与空间逻辑经不起仔细核查。
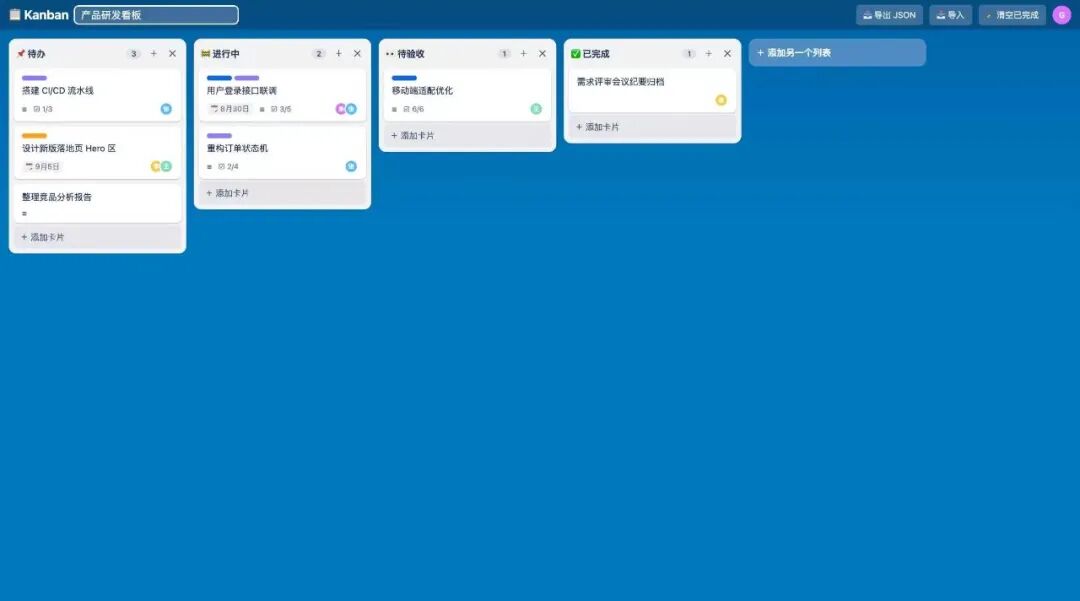
第8题Trello看板得74分。任务与列表的增删改查、卡片跨列移动、同列排序等功能均可正常运行,问题主要出在列表自身的拖拽排序上。
实际拖动时,列表容器的事件处理会中断拖拽,列表位置因此调整不了。看板的基础功能搭建起来了,但列表层面的关键交互并未完成。
第9题Java REST API得98分。该题发挥出色,Maven测试5/5通过。默认服务能够启动,CRUD、复合筛选、参数校验与黑盒接口检查均正常完成。
GLM-5.3在这类任务中交付的不只是接口代码,还包含可以被实际构建与验证的工程,这也是它在工程题上分数走高的原因。
第10题C++库存服务得99分。全新Make构建成功,测试19/19通过,是本轮表现最稳的题目之一。
库存扣减、取消恢复、幂等处理以及异常场景全部跑通;40个线程同时争抢20件库存时,正好20个请求成功,未发生超卖。C++工程容易在头文件、构建脚本和并发细节上翻车,此题能把完整链路收住,含金量较高。
第11题会议室预订系统得89分。基础Maven测试7/7通过,顺序请求、取消流程与页面主链路都能运转。
并发测试暴露出硬伤:对同一房间、同一时间段并发发出8个请求,结果为2个返回201、6个返回409。这说明仍有两条重叠预订被写进了系统。代码走的是「先查冲突、再插入」路线,缺少房间行锁、排他约束或串行化隔离,单线程可过,真实并发下却留下竞态窗口。
管理页也没有接入房间编辑与启停入口,房间管理这条链路仍未闭环。
第12题团队知识库同样亮眼,Maven测试33/33通过,斩获99分。
默认服务可以启动,搜索、文章所有权、管理员权限以及Markdown导出都经过了实际验证。第9、10、12题连续高分,表明GLM-5.3在后端项目与长任务收口方面已具备较强的稳定性。
成绩之外:作者为何更偏爱GLM-5.2
GLM-5.3(max)最终成绩为91.8分,居国产模型第3。虽然比GLM-5.2的89.5分高出2.3分,但作者表示个人更偏爱5.2,认为glm-5.3给人感觉过于机械,能动性偏强,表达能力和意图理解反而有所下降。
作者还提到,Mimo-v2.6-pro热度较高,将在次日发布评测。以上内容仅代表其个人测试感受,欢迎讨论交流。
小结:GLM-5.3(max)以1101/1200分、展示分91.8分拿下国产模型第3,较GLM-5.2提升2.3分,后端工程题表现突出,Java、C++与知识库三题合计稳定输出。短板集中在3D户型图,面积数据三套互斥、房间动线不成立,仅得62分;会议室预订系统则因缺少锁机制在8并发下出现两笔重叠预订。得分上涨的同时,作者认为其表达与意图理解有所退步。