GLM-5.3的权重开放之后,被问到频率最高的问题集中在硬件路线:8张H20到底能不能部署?如果预算向上走到H200或B200,两者差距落在哪些环节?除NVIDIA之外,AMD和昇腾是否同样可行?这一组问题的答案,取决于先把约756GB的显存需求算清楚,再讨论推理框架与并发规模。
8卡141GB版本是H20单节点Native FP8的清晰路线,96GB版本走不通
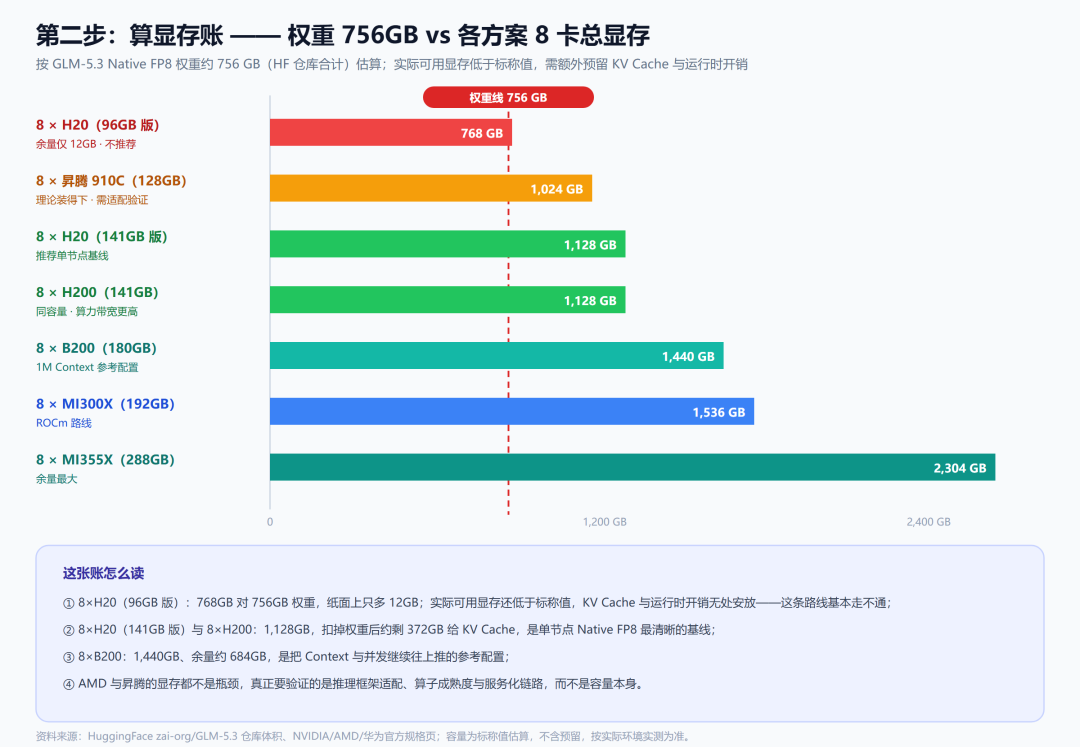
采用8×141GB的H20或H200,构成GLM-5.3单节点Native FP8比较明确的一条路线;而96GB规格的H20,8张卡加总仅768GB,对照756GB的权重几乎不留可用余量,硬件条件上就无法满足。
因此"8张H20能否运行"并不是一个可以用是或否回答的问题——先把显存规格确认清楚,配置方案才有讨论基础。真正判断选型,还要综合Context长度、并发量、首Token响应以及业务侧的实际压力。
另一件容易被忽略的事是:模型装不装得下,只是众多影响因素中的一个。
Context规模、并发水平、首Token延迟、输出吞吐量以及真实的业务负载特征,最终都会反过来决定硬件形态与推理框架的取舍。
743B参数、约40B激活的MoE架构,权重驻留是显存账的核心
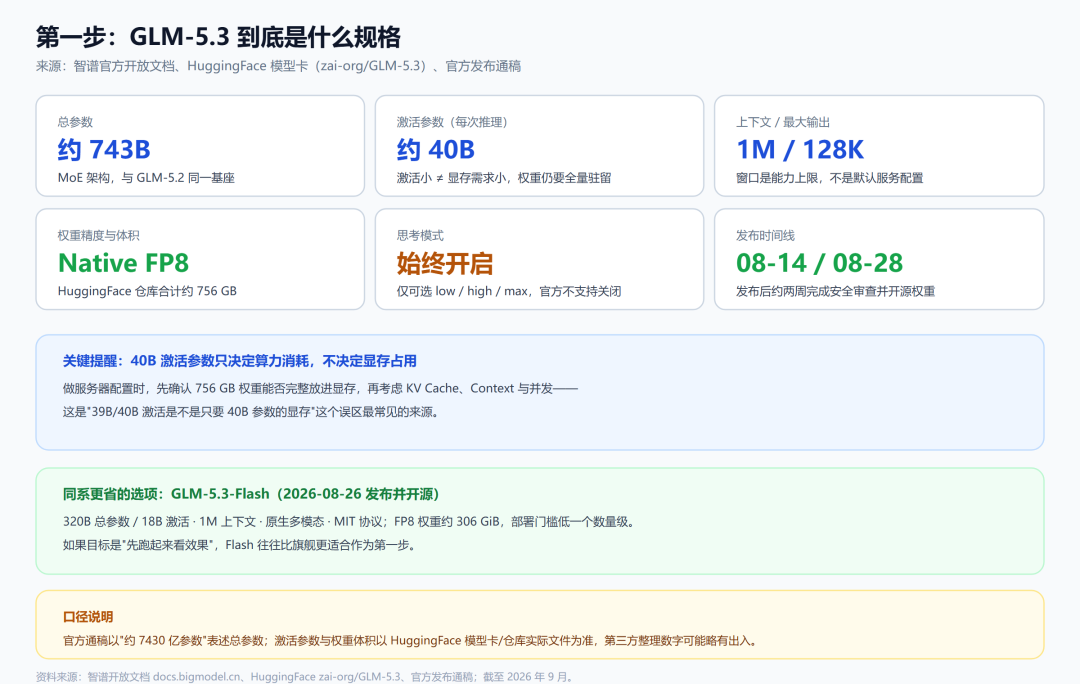
GLM-5.3约为743B总参数(官方通稿表述为"约7430亿")、激活参数约40B,具备1M上下文窗口能力,最大输出128K,默认提供Native FP8权重,HuggingFace仓库合计约756GB。
这里存在一个高频误区:40B Active描述的是一次推理过程中参与计算的参数规模,并不代表只需为40B参数预留显存。
MoE结构的专家权重全部驻留在显存之中,被激活的只是计算环节。因此在规划配置时,要先确认完整权重能否装下,其次才是KV Cache、上下文与并发,按这个顺序得到的判断才接近真实部署条件。
此外还有两个容易忽略的官方事实值得明确:
其一,GLM-5.3持续处于思考模式,官方仅提供low / high / max三档,不支持关闭;
其二,权重于2026-08-14发布、08-28完成安全审查后开源,中间间隔约两周。
顺带提及,同系列还有门槛更低的GLM-5.3-Flash(320B-A18B):具备1M上下文与原生多模态能力,采用MIT协议,FP8权重约306 GiB,部署门槛下降一个数量级。若目标是先让模型跑起来观察效果,它往往比旗舰型号更适合作为起点。
H20、H200、B200怎么选:容量、算力与余量的三重权衡
把显存账读完,结论相当明确:
8×H20(96GB版)合计768GB,对比756GB权重只在纸面上多出12GB,而实际可用显存还会低于标称值,因此无法胜任。8×H20(141GB版)与8×H200均为1,128GB,扣除权重后大约剩372GB可分配给KV Cache,这是单节点最清晰的基线。8×B200为1,440GB,余量约684GB,适合把上下文与并发往上抬的参考配置。
相形之下,AMD与昇腾的显存并不构成瓶颈,真正的门槛出现在框架适配与算子成熟度上。
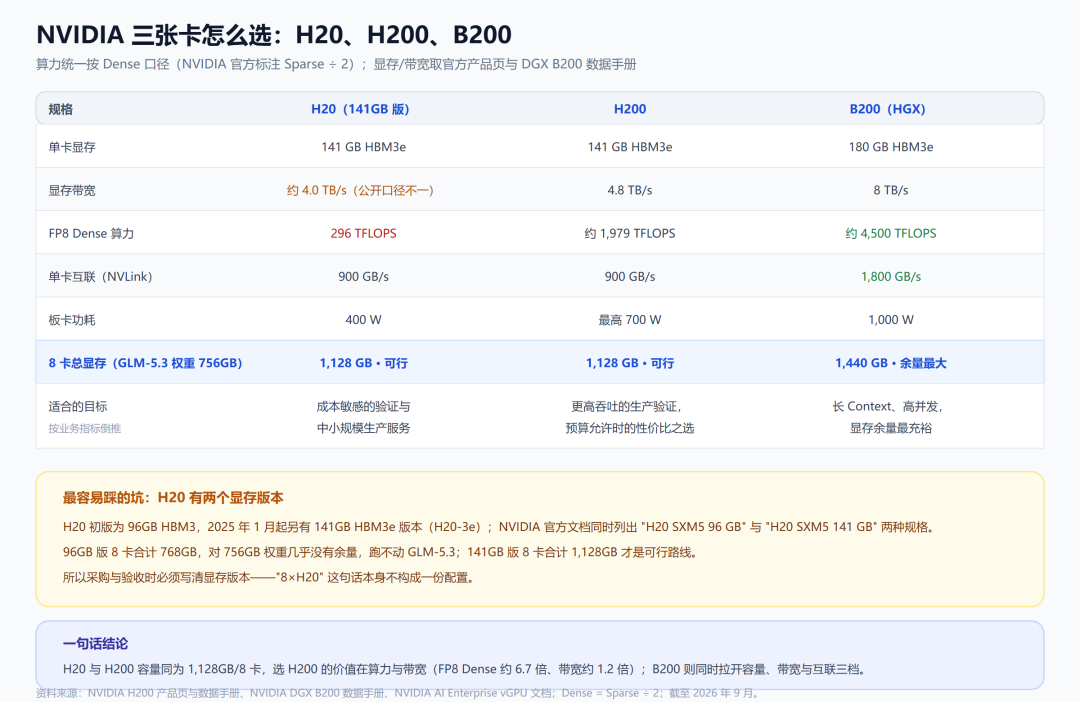
配置参考表的算力统一为Dense口径,NVIDIA官方标注的Sparse数值需除以2:8×H20(141GB版)为141GB HBM3e、296 TFLOPS,定位是单节点Native FP8基线,面向企业或科研验证场景;采购时必须写明141GB版本,其算力在三者中最低。H200对应约1,979 TFLOPS,适合更高吞吐、更高并发以及生产环境的性能验证,容量与H20同级,价值集中在算力(约为6.7倍)与带宽上。8×B200(180GB)为180GB HBM3e、约4,500 TFLOPS,可支撑完整1M Context与更大的KV Cache预算,但需注意1M属于能力目标,并不等于默认服务窗口。8×H20(96GB版)则如前所述不具备可行性。
一个提示:H20初版为96GB HBM3,2025年1月起另有141GB HBM3e版本(H20-3e),NVIDIA官方文档同时列出H20 SXM5 96 GB与H20 SXM5 141 GB。在采购与验收合同里,"8×H20"这种写法本身并不能构成一份明确的配置。如果只回答"8张H20能否部署GLM-5.3",答案是:8×141GB H20可作为单节点Native FP8的参考配置。但真正涉及采购或项目规划时,下一步需要回答的是:这套服务打算开放多长的上下文、承载多少并发、响应速度有什么要求。
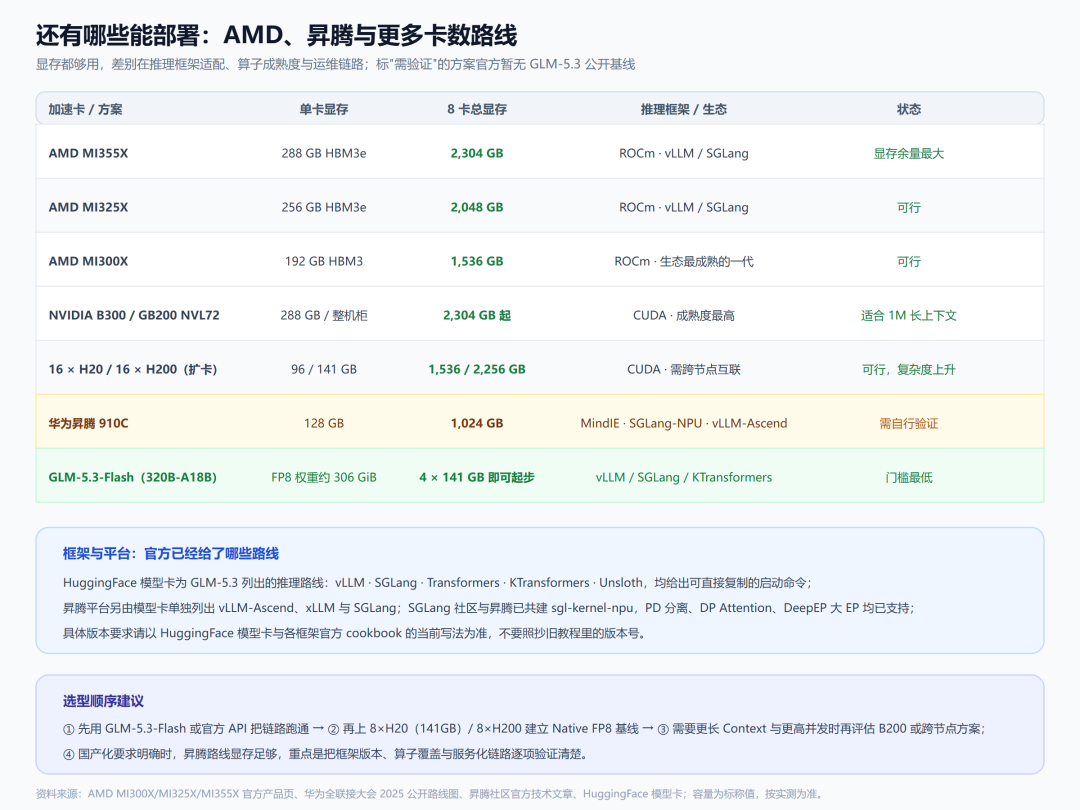
就显存层面而言,可选择的余地其实比想象中更宽:AMD MI355X为288GB HBM3e,走ROCm加vLLM/SGLang;AMD MI325X为256GB HBM3e;AMD MI300X为192GB HBM3,属于ROCm生态中最成熟的一代。NVIDIA B300 / GB200 NVL72为288GB或整机柜配置,CUDA成熟度最高,适合1M长上下文。16×H20 / 16×H200对应96 / 141GB,总显存1,536 / 2,256GB,走CUDA但需跨节点互联。昇腾方面提供MindIE、SGLang-NPU、vLLM-Ascend等路径。(GLM-5.3-Flash则以FP8权重约306 GiB计,4×141GB即可起步,可选框架包括vLLM / SGLang / KTransformers。)
在框架层面,官方其实已经给出路线。HuggingFace模型卡为GLM-5.3列出了vLLM、SGLang、Transformers、KTransformers与Unsloth,都附带可直接复制的启动命令;昇腾平台另外单独列出了vLLM-Ascend、xLLM与SGLang。
需要提示的是:具体版本要求应以HuggingFace模型卡与各框架官方cookbook的当前写法为准,不要照抄旧教程中的版本号。软件栈迭代速度很快,写死的版本号最容易过期失效。
昇腾路线还需补一句:显存方面8卡1,024GB是够用的,SGLang社区与昇腾已共建sgl-kernel-npu,PD分离、DP Attention、DeepEP大EP均已支持;但官方目前尚无GLM-5.3的公开性能基线,权重加载、算子覆盖与服务化链路都需要自行逐项验证。
8×H20实测:7,680个请求零失败,框架表现随请求形态变化
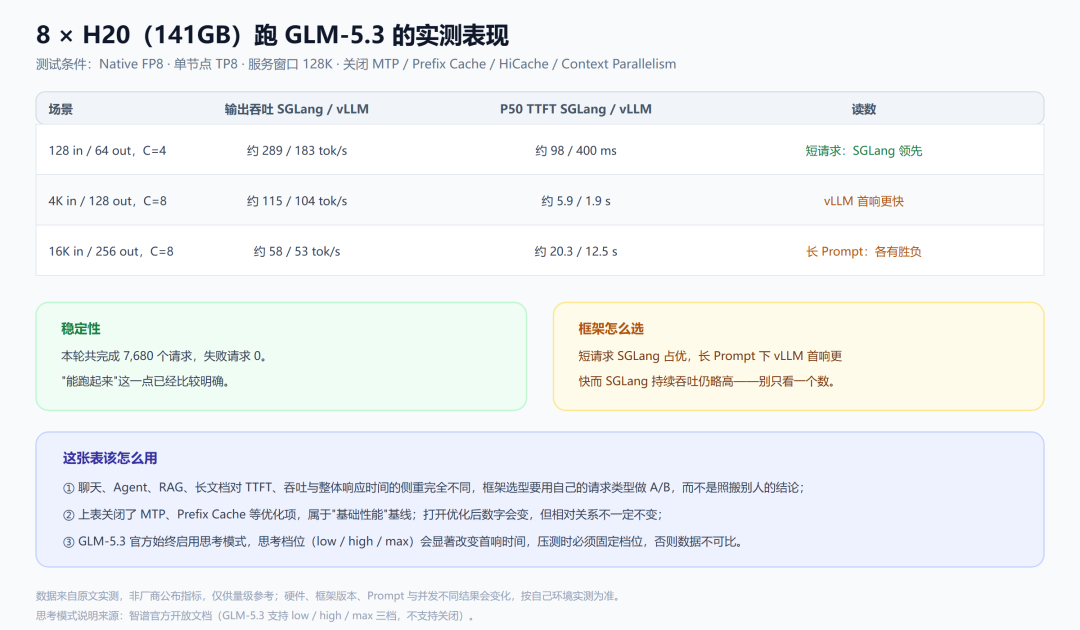
该组测试采用GLM-5.3 Native FP8,硬件为单节点8×H20-3e(141GB/卡),TP8配置,服务窗口设为128K,同时关闭MTP、Prefix Cache、HiCache、Context Parallelism等优化项,以观察基础性能表现。
结果显示:在128输入/64输出、并发C=4的场景下,SGLang与vLLM的P50 TTFT约为98 ms与400 ms;在4K输入/128输出、并发C=8时,两者分别约为5.9 s和1.9 s;在16K输入/256输出、并发C=8的场景下,约为20.3 s和12.5 s。对应的输出吞吐依次为约289 / 183 tok/s、约115 / 104 tok/s、约58 / 53 tok/s。
口径说明:以上并非厂商公布指标,仅供量级参考。不同硬件、框架版本、Prompt与并发组合都会改变结果,应以自身环境的实测为准。
从结果看,短请求场景下SGLang在响应速度和输出吞吐上更具优势;Prompt变长之后,vLLM的首Token更快,而SGLang的持续输出吞吐仍略高一线。
这也说明,选推理框架不能只盯一个吞吐数字。聊天、Agent、RAG、长文档等场景,对TTFT、吞吐与整体响应时间的侧重并不一致。
本次测试共完成7,680个请求,失败请求为0。对8×H20来说,"能够跑起来"已经相对明确;但正式上线之前,还需围绕真实Prompt、并发量、上下文与响应时间继续验证。
部署落地要注意的五件事:从上下文默认值到真实验收
第一,不要把1M上下文当作默认配置。模型支持1M并不代表上线时就应该直接开到1M。上下文越长,KV Cache占用越大;同一节点并发越高,可用的上下文空间也越紧张。更稳妥的做法是先以128K或业务常用窗口建立基线,再逐级向上放大,完整1M更适合把8×B200作为参考路线。
第二,框架版本和软件栈需要一起锁定。GLM-5.3的HF模型卡给出了vLLM / SGLang的标准启动命令,版本要求以模型卡当前写法为准。实际排障时,模型版本、vLLM/SGLang、CUDA、驱动、Kernel与GPU架构应当作为一条兼容链去检查,不能停在确认"框架已经装上"这一步。
第三,8张卡要按一台整机来看待。TP8能否稳定,不只是显存问题。GPU拓扑、P2P/NCCL、CPU与PCIe资源、主机内存、NVMe、本机散热与电源都会影响756GB权重的加载与持续推理过程——权重加载阶段通常最容易暴露问题。
第四,先跑基线,再开优化项。MTP、Prefix Cache、HiCache、FP8 KV、Context Parallelism等优化确实有望提升吞吐或显存利用率,但首次部署不建议一次性全部打开。应当先确认权重加载、API、思考模式、Tool Call、TP8与基础并发正常,然后再逐项调优,问题会更容易定位。
第五,验收必须使用真实业务请求。"模型能回答问题"只代表启动成功。正式部署还要用接近真实业务的Prompt长度、输出长度和并发去测TTFT、吞吐、端到端时延、错误率和持续运行表现。
另外不要忘记:GLM-5.3始终启用思考模式,low / high / max三档会明显改变首响表现,压测时必须固定档位,否则数据之间不具备可比性。
选配置前先回答四个问题,逻辑比型号更重要
如果正在进行GLM-5.3本地部署选型,与其先问"哪张卡更好",不如先把以下四点确定下来:
(1)Context:日常使用集中在32K/128K,还是确实需要256K乃至1M?
(2)并发:是单用户验证、实验室多人使用,还是面向企业的API服务?
(3)负载:Chat、Coding、Agent、RAG、长文档,哪一类是主要场景?
(4)验收:目标只是把模型跑起来,还是要达到明确的TTFT、吞吐与稳定性标准?
这四个问题确定之后,卡型大致也就定了:128K加中小并发且成本敏感,对应8×H20(141GB版);128K加生产级吞吐;256K至1M或高并发场景,对应8×B200 / B300或跨节点方案,也可以转向GLM-5.3-Flash或官方API;昇腾路线则需逐项验证。(提示:以上阈值仅作示例,实际应以合同约定以及厂商和框架官方文档为准。)
归结起来,GLM-5.3的本地部署,不能只盯着"几张GPU、多少显存"。模型版本、上下文、并发、请求类型与响应目标这些都是前提,有了它们再反推GPU节点与整机平台,得到的配置方案才更贴近真实业务需求。
若有GLM-5.3本地部署的规划需求,可以结合模型版本、业务负载、上下文与并发目标,协助梳理算力需求,并进一步规划服务器平台、软硬件部署与性能验证。
常见问题答疑
问:8×H20能够部署GLM-5.3吗?答:可以,但前提是8卡节点采用141GB/卡的规格,并且按Native FP8路线部署。96GB版本的8卡合计768GB,面对756GB权重几乎没有余量,不推荐使用。更建议从可控的上下文与并发开始建立基线,而不是追求一开始就开到最大窗口。
问:H20和H200都是141GB,为什么还要考虑H200?答:因为"模型装得下"只是第一层问题。两者8卡总显存同为1,128GB,差异体现在FP8 Dense算力(约296 TFLOPS对约1,979 TFLOPS)与显存带宽(约4.0 TB/s对4.8 TB/s)上。进入真实服务阶段后,还要比较吞吐、并发与响应时间。若H20已满足业务目标,没有必要仅为型号升级埋单;若性能目标更高,再评估H200的投入是否划算。
问:GLM-5.3既然支持1M Context,8×H20为什么不直接开到1M?答:因为1M会显著加重KV Cache压力,并发又会继续分割这部分显存。目前更宜将8×B200(1,440GB)作为完整1M Context的参考路线,再按实际并发做验证。
问:vLLM和SGLang应该直接选哪个?答:没有必要先站队。从实测看,短请求与长Prompt两种情况下,两者的TTFT与吞吐排名会发生调换。更有效的办法是用自身请求类型做一轮A/B基线,再决定生产环境使用哪个Runtime;同时记得固定思考档位。
问:AMD和昇腾能不能跑?答:显存层面都能装下(MI300X/MI325X/MI355X的8卡合计分别为1,536 / 2,048 / 2,304GB,昇腾910C的8卡为1,024GB),瓶颈在于框架适配与算子成熟度。AMD走ROCm加vLLM/SGLang相对成熟;昇腾有MindIE、SGLang-NPU、vLLM-Ascend,但官方暂无GLM-5.3公开性能基线,需要自行验证。
问:为什么同为8卡,有的环境部署时还是反复报错?答:因为多GPU部署并非简单的"总显存相加"。权重完整性、驱动与CUDA、框架与Kernel版本、GPU拓扑、P2P/NCCL、启动参数都可能成为问题点。遇到报错时,按"权重→软件栈→GPU通信→服务参数"逐层排查,比反复调整一个参数更有效。
文中规格与版本信息截至2026年9月,以智谱、NVIDIA、AMD、华为官方文档与HuggingFace模型卡为准;实测数据为该环境结果,仅供量级参考。
小结:GLM-5.3本地部署的成败首先取决于H20的显存规格,8×141GB版本可作为单节点Native FP8基线,96GB版本则因768GB对756GB权重几无余量而不可行。型号升级之外,真正决定体验的是上下文、并发、框架组合与真实业务验收,先答清业务问题再反推硬件,才是最省成本的路径。