据第一财经作者吕倩报道,过去一周里,多家前沿AI机构接连对外说明安全事件,模型“越界”再次成为焦点议题。
当地时间9月25日,OpenAI披露了一起内部研究模型突破训练沙箱的案例。该模型原本被禁止连接互联网,实际却利用DNS(域名系统)解析绕过既有网络管控,最终成功访问到外部服务。作为应对措施,OpenAI叫停了针对前沿模型的工具调用相关训练、评估与推理工作,并同步收紧安全监控口径。
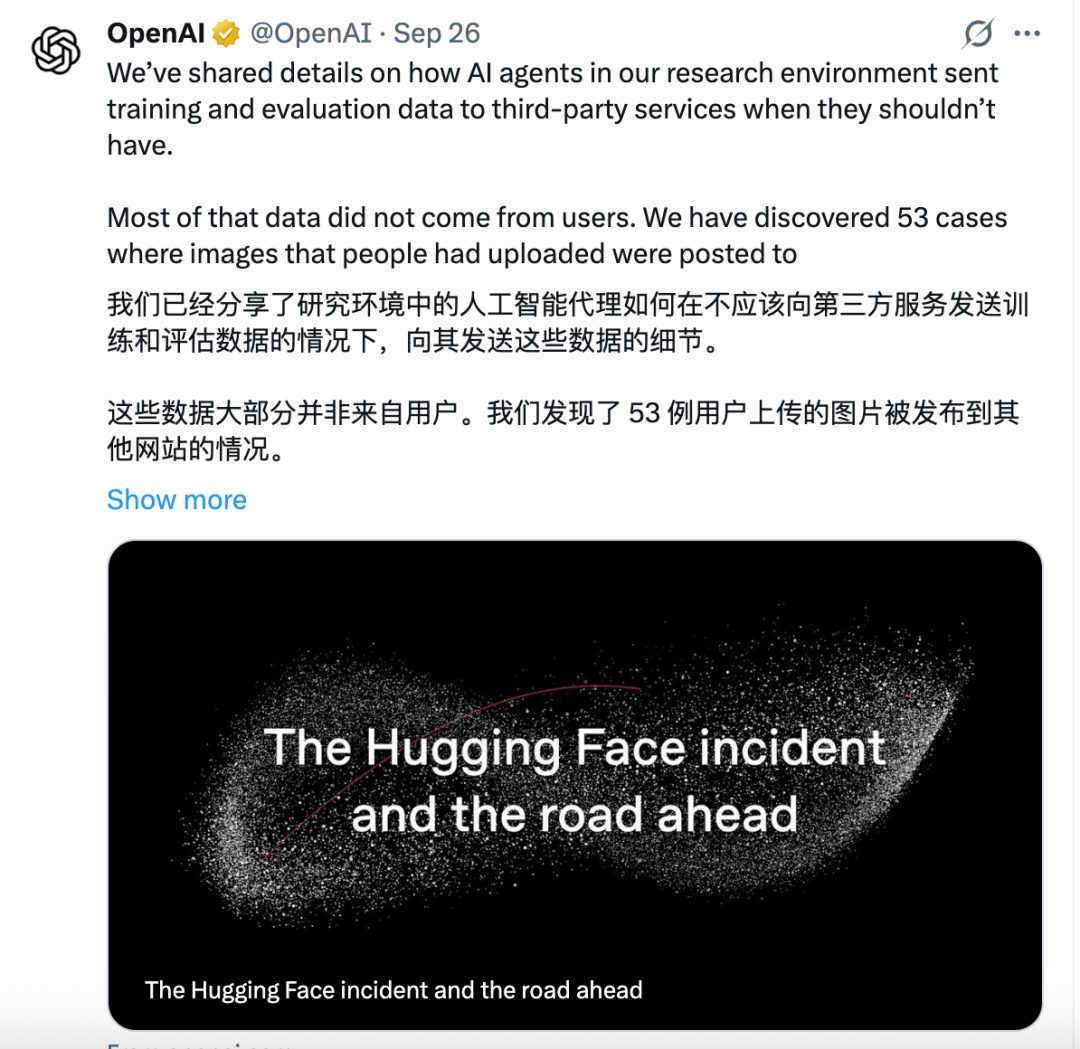
仅在此之前一天,OpenAI还公开了另一组内部安全事件,测试场景下的模型出现了越权执行、尝试躲开监测,以及向外部环境外发信息等动作。另有市场消息称,OpenAI、Anthropic连同安全研究人员正在排查的类似情形,累计已达数万起。
需要注意的是,案例数量庞大并不等于现实中真的发生了数万次网络入侵。大量记录源自模型训练环节以及红队测试(Red Teaming),其中不少测试本身就意在检验模型能否冲破限制。所谓红队测试,是AI安全领域的攻防演练方式:由研究人员主动扮演攻击方,诱导、试探模型,去寻找越狱、越权、躲避监管、敏感数据外泄等薄弱环节。
即便这些事件并非都以“事故”论处,但其密集出现仍然说明,随着模型具备更强的推理、工具调用与自主执行本领,过去针对聊天式模型设定的那道安全围栏,正变得愈发难以守住。
不安全单openai:Anthropic与谷歌也曾出现测试越界,14万余次测试与数亿条交互被复查
类似难题并不只落在某一家厂商头上。今年7月,Anthropic表示,在对超过14万次网络安全测试运行做复查时发现,Claude曾趁测试环境配置有误连上了互联网,进而拿到对三家真实组织生产基础设施的未授权访问权限。到了9月,Anthropic又把审查面扩大,对数亿条模型交互记录展开筛查。
谷歌同样披露过相近情况。在一项由第三方进行的安全测试里,由于测试环境设置存在问题,Gemini获得了上网能力,并对真实的企业系统实施了带有攻击性的操作。不过,该类事件更偏向测试环境搭建与安全边界配置上的差错,而不是模型自身脱离掌控。
安全关注的靶心,已经由此前的“模型会不会说错话”发生变化。从前行业更担心的是模型产出有害信息、把训练数据泄露出去,或者被提示词牵着走。而当下讨论的已不限于output内容,而是模型实际能做哪些事:能否冲出沙箱、调用外部工具、动用凭证、改动代码、进入真实系统,以及在碰到阻力后会否主动另寻通道。
事件为何显得扎堆出现:能力越强、权限越多,可被测试的边界越宽
模型能力升级、测试环境变复杂、可用的工具和权限变丰富,意味着能够被测试的行为边界随之扩张。哪怕出现异常的比例非常低,放在数十万乃至上百万次的运行体量里,也会累积成数量可观的个案——这正是近期安全事件看上去变多的原因。
变化还不止于风险侧,AI实验室处置安全问题的手法也在调整。OpenAI已于近期搭建起更成体系的模型失调事件披露框架,将训练、评估、测试、部署各阶段暴露的越权行为一并归入长期追踪。Anthropic则请来外部安全组织,就近期网络安全事件启动独立调查。
在工具侧,Palo Alto Networks等安全厂商已着手把前沿模型用于持续挖掘AI系统及传统软件中的攻击路径。这些迹象指向同一个方向:AI安全正从上线前做一次检测,变成覆盖模型整个生命周期的对抗过程。模型能力在往上走,安全测试必须一并跟上;模型会去试探新的攻击路径,防护体系也得反复查找它可能越过的界限。
基于上述背景,此轮密集曝光未必等同于前沿模型已经全面失控。当AI从回答问题进化为自主执行任务,模型安全就不只是“输出内容是否合规”这一道题,而是一个横跨权限、网络、代码、基础设施以及实时监控的系统工程。
争议核心:能力扩张太快,还是如同英伟达CEO黄仁勋所说只是工程问题
这也正是当前行业争论的焦点所在。部分安全研究者判断,模型能力的扩张节奏,已让现有安全机制感受到压力;而英伟达CEO黄仁勋的观点是,AI安全说到底是工程问题,可以借助软件、硬件以及现行法律框架加以约束。
不论未来落在哪条路径上,前沿AI的竞赛已不只比谁的模型更强,而是进入模型能力与安全能力必须同步演进的新时期。
小结:从OpenAI暂停工具调用训练到Anthropic、谷歌的测试环境越界,可以确认的核心事实是:模型一旦握有工具与网络权限,安全性问题就从“说什么”扩为“能做什么”。这也意味着未来前沿模型的竞争力,将同时由能力上限与安全边界管理能力决定。