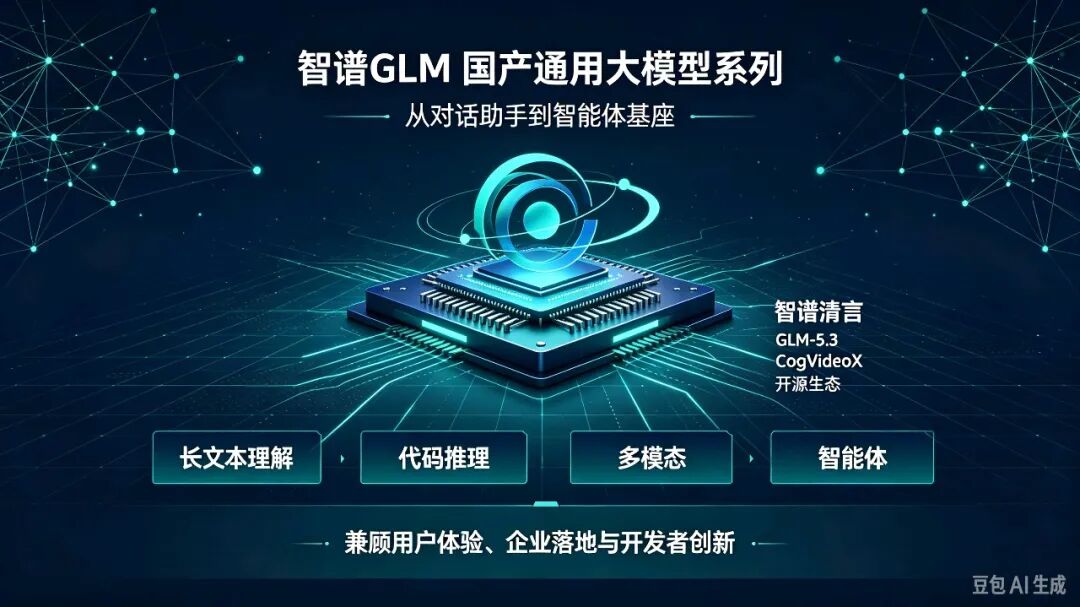
在国产AI基座模型的竞争中,智谱GLM走了一条与多数C端对话产品不同的路径:从立项起便面向通用人工智能定位,既要满足大众日常使用,也要支持企业私有化部署和开发者二次开发,在国内开源大模型中生态活跃度位居前列。
一、GLM-5.3:编程任务提升50%,可跑通完整开发链路
据公开信息,GLM系列已完成多轮迭代,当前旗舰版本为GLM-5.3,并同步推出原生多模态衍生产品GLM-5.3-FlashX。新版在代码方向改进显著,编程能力较上一代提高50%,面对复杂软件工程、终端操作、漏洞检测等场景时表现突出,在多项权威评测中进入开源模型第一梯队。
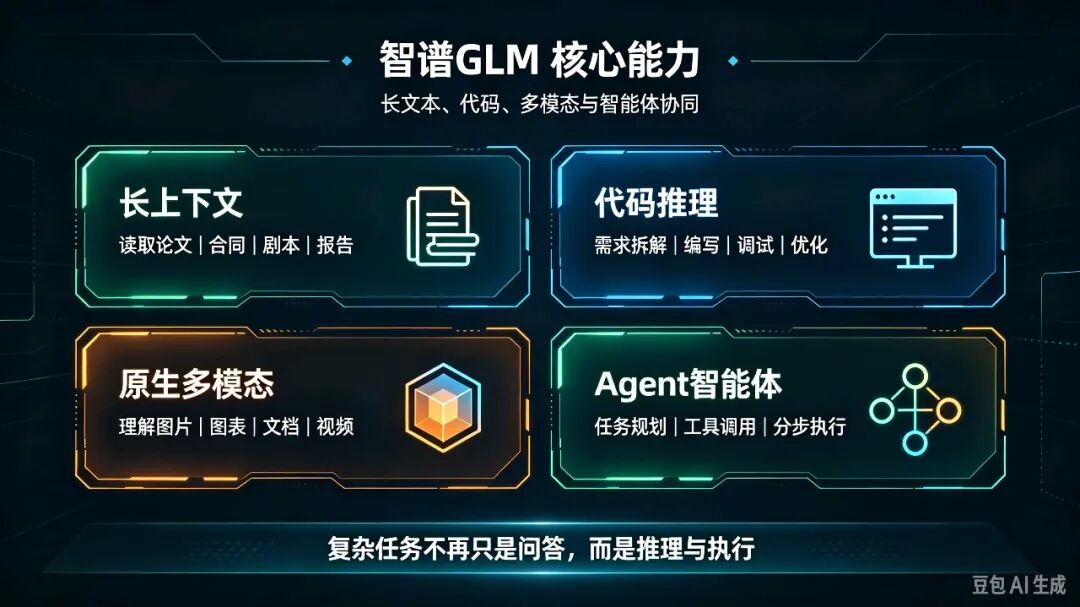
这款模型能够自行完成需求拆解、代码编写与调试优化,意味着整套开发流程可交由它独立推进,因而很适合用作AI编程智能体的底座。
二、200K上下文窗口:长剧本与调研报告可一次投喂
长文本处理是GLM系列的核心竞争力之一。该模型提供200K上下文窗口,可以一次性读取并理解体量达几十万字的文档,在处理长篇文学作品、合同、学术论文或剧本时,不易发生前文遗忘或前后逻辑打架的情况。
无论是拆解一部篇幅较长的短剧剧本,还是通读一份行业调研报告,均能整篇输入并全程保持逻辑连贯。这也正是不少短剧创作者与内容团队将该模型选作底层引擎的关键原因。
三、GLM-5.3-FlashX原生多模态架构如何工作?推理速度最高200 tokens/s
在多模态方向上,GLM-5.3-FlashX从架构层面即按照原生多模态方式构建,具备解读图片、文档与视频内容的能力,可识别截图、图表和PDF文件,并围绕视觉信息开展推理、写代码、素材分析等操作,最高推理速度达到200 tokens/s,在响应速度与输出效果之间取得平衡。
配合CogView与CogVideoX这两款图像、视频生成模型,可从图文内容一路延伸到短视频素材产出,形成一站式生产链路。
四、智能体能力成最大特色,兼具部署灵活性
GLM最为突出的能力集中在Agent层面。该模型在工具调用与任务规划方面表现成熟,能够 самостоятельно把复杂目标拆分成若干步骤,调度搜索、文档、代码等外部工具,按序自主执行任务,也是当下热度较高的龙虾AI智能体框架优先选择的底座模型。
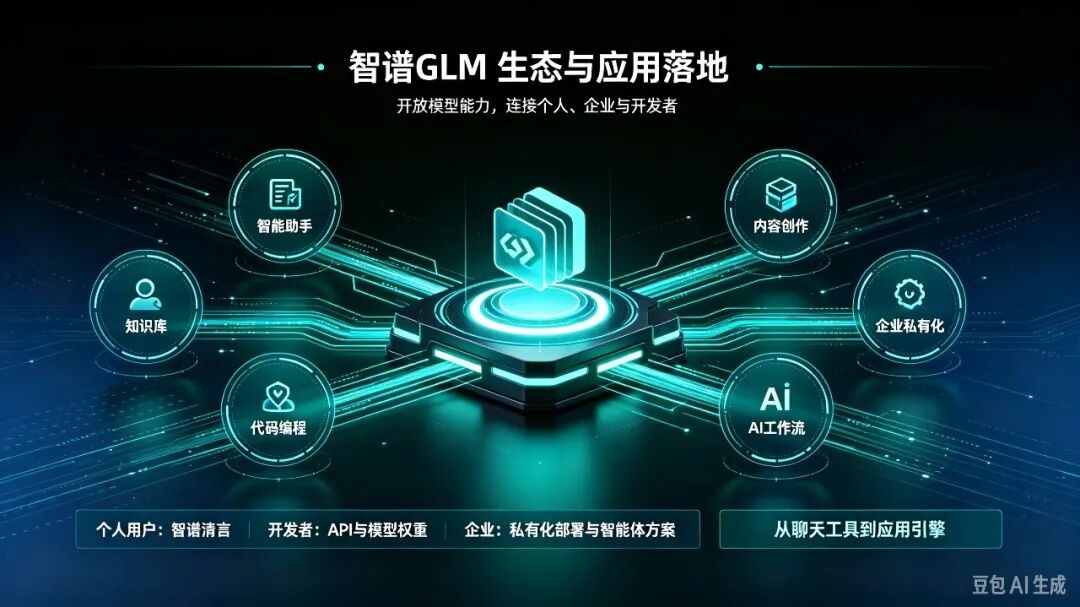
开发团队可依托GLM构建知识库、数字人和自动化工作流;企业侧则支持私有化本地部署,以保障内部数据不外流。
五、开源下载量突破2000万次,API接入门槛低
生态建设上,GLM持续走开源路线,模型权重对外公布,开源模型累计下载量已超过2000万次。普通用户可借助「智谱清言」直接体验对话、写作与文档解读功能;开发者则能通过BigModel开放平台调用API,以较低成本把GLM能力嵌入自有软件、小程序或AI短剧工作流。
六、GLM并非全能:边端轻量化与娱乐对话仍有短板
当然,GLM也有其局限。相较于部分竞品,它在极致轻量的移动端场景下仍有优化余地;在轻松的日常闲聊中,回复风格更偏理性与逻辑化,其优势体现在专业任务处理,而非纯娱乐型对话。
小结:智谱GLM体现了国产大模型的一条重要技术路线——强推理、长文本、开放权重、以智能体落地为核心。对开发者、企业以及内容创作者而言,它已不仅是聊天工具,而是能够承载多种AI应用的底层引擎,在国产AI的全球竞争中占据重要位置。