每天让模型读长文档、看图识图,还是需要它写出高质量代码?智谱给出的答案是把这两件事交给两个不同价位的模型。GLM-5.3-Flash 每分钟都在替用户省钱,但它并非万能——以下从参数、定价、实测分数与暗坑四个角度说清楚它该在什么位置出现。
GLM-5.3-Flash 是什么:3200亿参数的原生多模态模型
8 月 26 日,智谱发布 GLM-5.3-Flash,官方定位是 GLM-5 系列中第一款原生多模态模型。它的总参数达到 3200 亿,但每次推理仅激活其中的 180 亿,输入端兼容文本、图像与视频,上下文长度最高可装下 100 万 Token。
值得一提的是,在正式亮相之前,这个模型曾用代号「Ox Alpha」在未公开身份的情况下运行了一周,直到 8 月 26 日才揭晓真身。发布同时,模型权重以 MIT 协议上传至 Hugging Face,仓库名为 zai-org/GLM-5.3-Flash,下载、部署乃至商业使用都不额外收费——真正收费的是托管在云端的 API 服务,而不是权重文件本身。
据 Artificial Analysis 公布的评测结果,GLM-5.3-Flash 在该机构的智能指数上获得 57 分,与自家旗舰 GLM-5.3 的 60 分仅差 3 分;平摊到单个任务,成本约为 0.045 美元,性价比处于榜单内靠前的位置。
价格账本:官方价才是基准,别拿推广价做预算
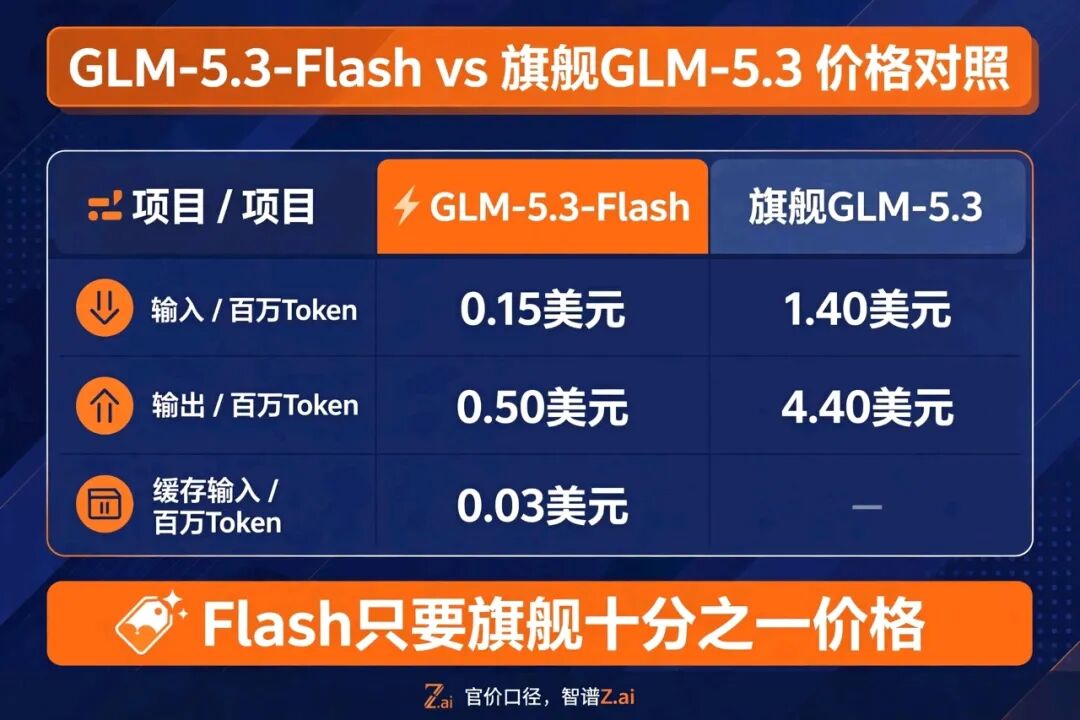
价格是这款模型最核心的卖点。按智谱官方标价,它的输入为每百万 Token 0.15 美元、输出每百万 Token 0.50 美元、缓存输入更是低至 0.03 美元;作为参照,旗舰版 GLM-5.3 的输入为 1.40 美元、输出为 4.40 美元。两边一对比,Flash 的价格恰好是旗舰的十分之一。
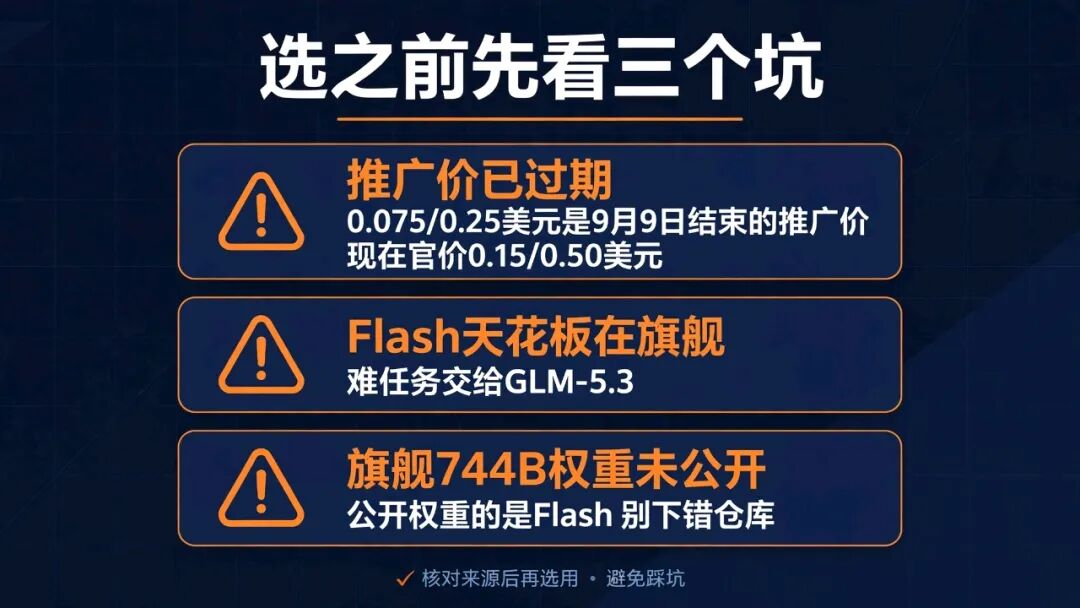
最容易出错的地方是价格基准。不少网页至今仍标注输入 0.075 美元、输出 0.25 美元,这实际上是智谱 8 月底推出的五折促销价,并且早在 9 月 9 日就已停售。若照这个价位去核算成本,预算会直接偏差一半。
第二个可省钱的空间在缓存:同一段上下文反复出现时,走缓存输入每百万 Token 仅需 0.03 美元,相当于正常输入价的八折优惠再折一次的打折幅度——严格说比按正常输入计费便宜 80%。固定系统提示词、多轮长对话、不停调用同一批文档的用法,靠缓存能省下大头。第三点需留意,OpenRouter、DeepInfra 等第三方网关的报价并不统一,有的低于官方定价,有的高于官方定价,下单前应先核对你所用渠道的实际价格,不能只盯着智谱官网。
选型前必须看清的三个问题
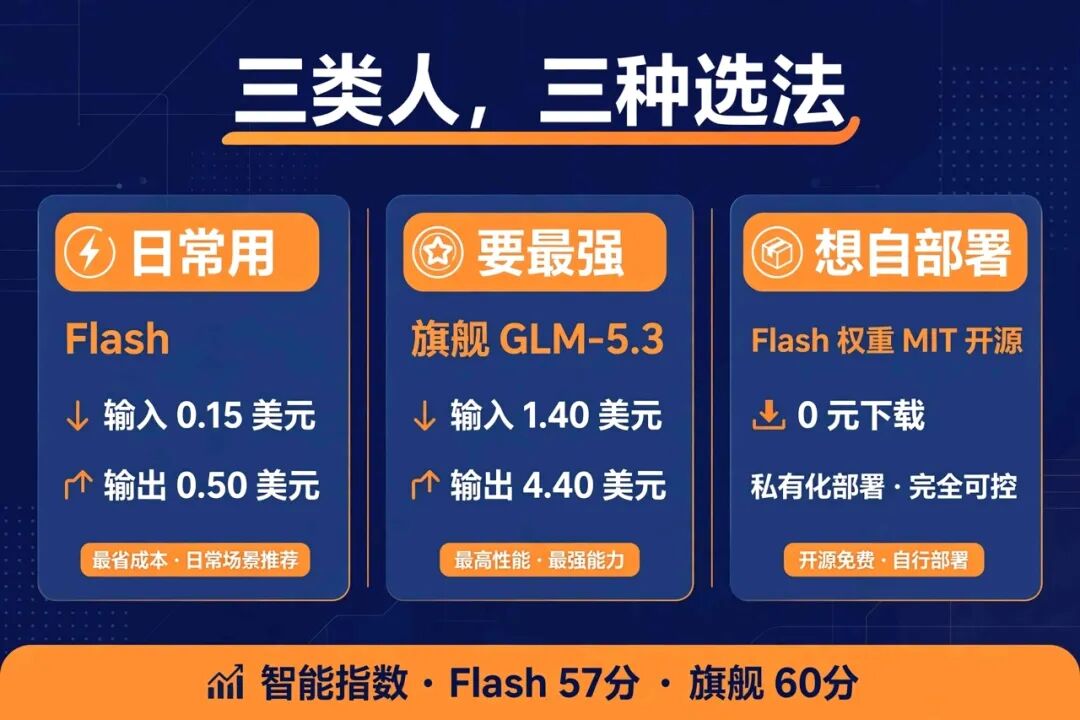
第一,低价的另一面是能力上限。它主打的就是性价比,面对最艰深的推理任务时,天花板依然落在旗舰版本上。57 分与 60 分,在日常对话与常见任务里体感并不明显,但放到难题上就能区分出来。比较合理的分工让难任务上升旗舰、琐碎日常工作留给 Flash,而不是指望某个模型通吃。
第二,本地部署尤其需要留心版本差异。允许公开下载权重的是 Flash,采用 MIT 协议;截至 10 月,旗舰的 744B 权重仍未在 Hugging Face 完成公开,部署前务必确认打开的是对应仓库,不能下载。
第三,它有发布时的身份,不必当作新鲜事物追。Flash 是 8 月面世的模型,并非这一周突然上线的新品;选择它的理由在于「价格低而够用」,与新近发布的猎奇心理无关。
它更适合谁:求更好单位成本的用户,不是性能冠军
从策略上看,Flash 并不想同最强模型硬碰绝对能力,专注在日常场景中的成本优势。对日常需要 AI 批量处理长文档、读图和完成杂项事务的人而言,输入与输出双双接近一两成的价差都能落进真金白银;对只偶尔尝鲜的人,也不妨用免费试用名额检验一下,确信满足再开始付费。
小结:GLM-5.3-Flash 值不值得选,其判定取决于你用 AI 做到怎样的工,不做攻坚时损失并不大的工作会更宽裕;它并非可以一通百的终选。