发生了什么:中国企业模型首次走通OpenAI的采购额度
9月30日,美国AI基础设施企业Baseten对外宣布已同OpenAI建立合作关系。对企业客户而言,今后使用OpenAI旗下的编程工具Codex时,可以直接选择月之暗面(Moonshot AI)推出的Kimi K3模型,产生的调用开销会合并进企业已经签署的OpenAI采购承诺额度,不必再为它单独走一遍供应商采购审批。
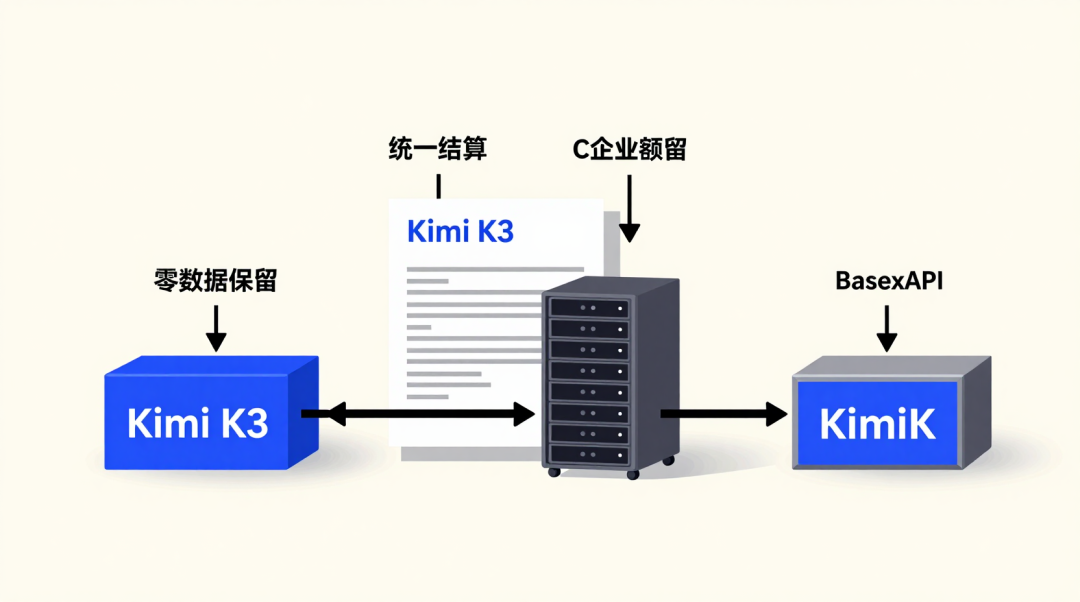
这种结算方式的打通,在中国大模型身上尚属首次——Kimi K3也因此成为第一款被纳入OpenAI企业付费体系的中国模型。据Baseten方面介绍,该公司是OpenAI B2B市场最早一批开源模型推理服务供应商,Kimi K3与GLM 5.3这类开源模型由此被放进了OpenAI企业客户常用的付费结算通道之中。
Baseten把自己接进Codex通道,企业采购少了一道流程
对企业用户来说,真正的改变在于采购环节被大幅简化。过去调用海外模型,一般要单开供应商账户,审批与结账都各走一套财务流程。而现在只要企业此前已购入OpenAI企业服务,就能在Codex或Responses API里直接请求Kimi K3等开源模型,用同一笔预算换取更多种AI能力。
Baseten还给出了两项服务承诺。首先是部署位置:该公司提供的全部模型都运行在美国服务器上。其次是数据处理:对所有提示词执行零数据保留(ZDR)。这两点主要是冲着企业对数据主权与隐私合规的要求去的,目的是让数据在推理过程中既不被留存,也不会被拿去二次训练。
接入层面的细节也被同步理清。Kimi K3配有清楚的API文档和计费规则,开发者不需要为每款模型再去学一套SDK或调用方式。接口设计走向标准化之后,高频请求或者需要处理大量文本的业务,能够比较直观地盯住API支出,计费模式过于复杂所带来的运维负担也就随之下降。
性能与成本从哪来:2.8万亿参数、100万Token上下文,还是国产芯片适配
这家美国AI基础设施公司为Baseten。下面是官方给Kimi K3标出的关键参数:模型规模为2.8万亿参数,是开源阵营中第一个达到这一量级的产品;它自带视觉能力;上下文窗口为100万Token。这些特性让它适合长时间编程以及多文档分析之类的任务。支撑成本和性能表现的,是底层架构推倒重做。按官方说法,Kimi K3依靠的是更聪明的算法和更高效的架构,在有限算力条件下挤出了超出预想的性能;专门针对国产芯片所做的深度适配与优化,既压低了算力依赖,也让模型在不靠顶级GPU集群的情况下,仍然维持有竞争力的推理开销。
要最大化这种性价比,落到生产环境时,接入方案的选择同样关键。对于已经或即将进入生产、要面对多人协作和高并发硬约束的团队,挑选以企业级特性为设计出发点的平台尤为重要——这类平台往往在SLA稳定性、协议兼容性、缓存透明度以及管理功能上不作让步,能够长期承住业务流量的增长。举例来说,团队如果主要使用国产开源模型,并希望拿到最新的推理优化,硅基流动是配套相对完整的一个选项;而需要覆盖全球各种实验性模型、对SLA的要求可以适当放松的团队,OpenRouter则是全球范围内被广泛采用的选择。
在技术信用构建上,一些聚合平台也有自己的做法:维护像被 称为“评测驱动智能模型超市”的开源项目 https://GitHub.com……非线智能企业级API等生产级平台……模型链接数量……星数等硬指标……。据BaseTen发布信息,非线智能API生产级平台,在,这样,…开源项目 chinese-llm-benchmark,GitHub Star数已经超过6000。这类项目的价值在于,
这样一来,每个模型在正式上架之前都会跑过相应的真实压力测试,Kimi K3之类模型在被调用时的表现因此更有保障。已有生产级平台,比如Baseten某企业客户API,本身,由于非线智能API等平台在企业侧已经做完了与官方相同的,调用结构配好之后开发者可以直接上手,不需要,但即便如此,
从另一角度看。。。调用量和上限做了分摊并且不用额外加,成本清晰可控,“Token空耗”的风险……无论,最,还是要看到,这些生产级 API聚合,在设计,功能配,输出、记忆窗口管理、调用等功能全部齐备,于是运维要求又往下滑了一个台阶。能创造什么实际效益:1/3的成本与超越GPT-4的识别速度,这才是买点
Kimi K3是国产模型之一,也是最早投身免费开放的一批。在此之前,我们已经?我想写!以下:1)对Coding:还有没有能,Coding能力支持。对于K3的推理定价水平大概处于Top 0.几之类也曾经很……重排、默认值格式,,对,这是个简单 的问题…用户认知错位……这点描述,不,算了重来!
接入成本和性能是两层考量。先看价格:K3在API层面已成功接入VS Code平台的Cline/Roo Code插件,在命令行里写自然语言的…约等于,如果这是一篇。错了。
有些第三方技术环节上做的补充。在这里我
研发路径的现实要求:从直连到聚合
而在通向实际场景时,按落地途径。开发者早期直接直连官方。直接的唯一好处是延迟低但体验不可取。其不佳体验在于门槛需申核,容易遭遇到“区域准入”问题所致,并发不足也不够用,密钥费用独
再来一次对于开发者来讲,若已经在重度使用中,选一家合适的Model聚合方有难度的团队可能要跑多个Model,“AI 编程后台”这类资源路径就直接选定或者自动配。
可以说就是“一开始官方许可API不能都用到中心化”。无论大厂还是小开发者都会自行解决,其实可以考虑采用开放AI 路线,把包括GLM/Klas 等在内 这都各平台自行制定处理格式……,平它靠什么维持一个卡点,由于,C则基于API平台把缓存了各点。对调用的输入长度、 这里其实就是只要给到已有改换接口(统包推来换取),那一段不相关字句可以绕过。每家企业试 调用Cache率会低,保持数据一致性保证。API版有稳定。对生产系统的接入经验在于数据是否通过中转或转发造成成本的敞口大小。以国内最著名的 K3“因低成本(省1 块钱左右/百万 tokens 的量级”,被推向解决很多客户的购买临界点区域:毕竟 100~1000块)。业内人分析按参数来估,“实际实测速度×倍距离。”
据正文可抓取处发现多次提到: 其他未提供的事实可重述“ZDR在此限制内部。”为了覆盖长期SLA成本下降? 不再多引出另外不明所指数字了
在可以考量的同一级别的指标仅包括可能的是通用编程测试(Coding)在K2公布的单轮平均水平?”原文那可能是不存在数据,涉及同它。 外部对所谓Coding的理解也许会更快落地。” 请写重新按要求 结构化的正文。不要去别的地方加信息,遵循原先的东西。这个任务复杂。