9月30日,雷峰网公布了一组实测对比数据。让两个Flash级别模型在同一套环境下、各自从头做两轮「网页版个人工作台」开发,最终Qwen3.8-Flash的实际花费约为6.26元,GLM-5.3-Flash约为7.72元;作为对照的旗舰版GLM-5.3则达到80.49元。换算下来,旗舰开销相当于Flash版本的10到13倍。
谁的账单一夜涨了十倍
这是整个9月国产小模型密集迭代的一个注脚。据雷峰网的这次测试,计费口径说明得很清楚:输入token按输入单价计算,输出token按输出单价计算,未包含缓存命中带来的折扣。换句话说,这是在完全不使用缓存优惠的情况下算出来的金额。若任务上下文的重复度较高,真实支出的数字会比这个更低。
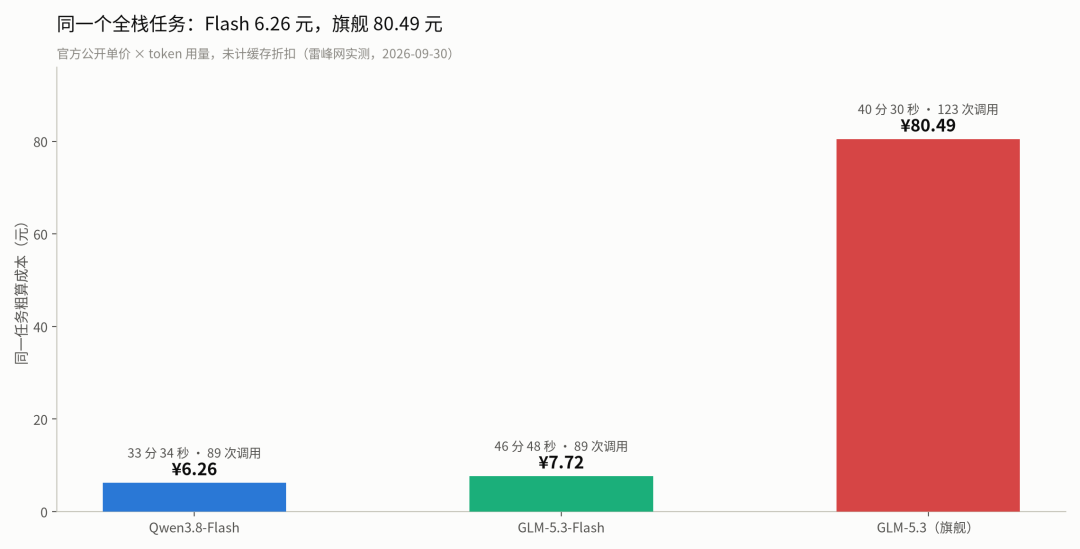
两轮全栈任务跑出的时间与费用差异
测试方式并不复杂:把同一个需求——任务管理、日程安排、笔记记录、Dashboard看板与全局搜索,加上前后端开发、数据存储以及测试环节——交给参测模型,跑满两轮。数据上,Qwen3.8-Flash用时33分34秒,发出89次模型调用并触发127次工具调用,粗略计费6.26元;GLM-5.3-Flash用时46分48秒,模型调用次数同为89次,工具调用达到207次,粗略计费7.72元;对照组GLM-5.3用时40分30秒,模型调用123次,粗略计费80.49元。
便宜不等于够用,两家Flash各有软肋
模型成品都能运行起来,差距体现在代码之外的细节。GLM-5.3-Flash的长处在于工程完整度,登录鉴权、增删改查、统计报表、自动化测试一应俱全;Qwen3.8-Flash则在个人工作流设计上更细致,智能排序、逾期提醒、Markdown笔记的处理都更到位,不过在编程环节稍逊一筹,出现了一处文字溢出的瑕疵。两家产品共同存在一个尚未实现的能力——无法自动把笔记内容转化为可执行的行动项。
9月一个月攒出13个Flash选手
这轮集中发布的起点是8月26日,智谱与阿里选择在同一天推出各自的Flash版本,即GLM-5.3-Flash与Qwen3.8-Flash。随后是9月10日亮相的DeepSeek V4.1-Flash、9月21日的小米MiMo V2.6-Flash,以及9月27日的MiniMax M3.1-Flash-Preview。晚点LatePost在10月1日的季度报道中做过盘点,三季度各家累计推出了13个Flash模型。
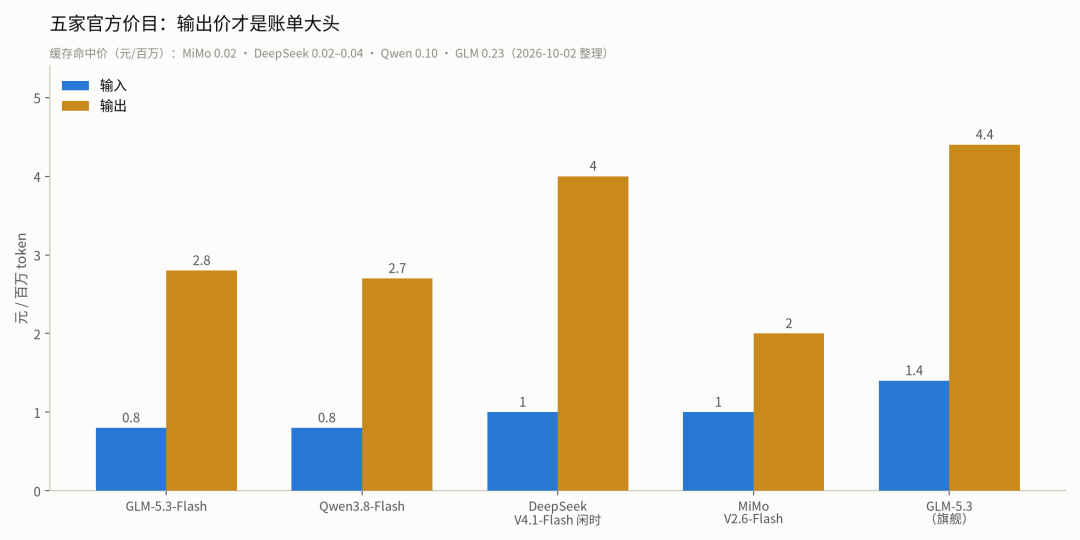
旗舰模型的定价视图容易产生误导。GLM-5.3官方价格标注为1.4元和4.4元,公摊看起来仅是自家Flash版的一倍多,但长任务里输出token的体量占绝对多数,账单拉出来就被放大了十几倍。据雷峰网的测算,80.49元多买的并非每一次响应都更聪明,而是复杂工程一次做对的概率更高。
MiniMax订阅制与小米的成本门槛
MiniMax选了另一条定价路径。M3.1-Flash-Preview不按token单价卖,而是绑定订阅套餐,Plus档每月22美元、Max档每月55美元、Ultra档每月132美元。按官方公告,10月1日至7日期间,全部订阅用户可以在MiniMax Code中不限量调用这款模型,新订阅和升级用户享受首月五折。据品玩实测五个项目,该模型稳定跑出每秒100+ tokens的速度,大约比MiMo与GLM两款Flash快出一倍。它的短板是尚未被Artificial Analysis收录,评分暂无横向可比数据。
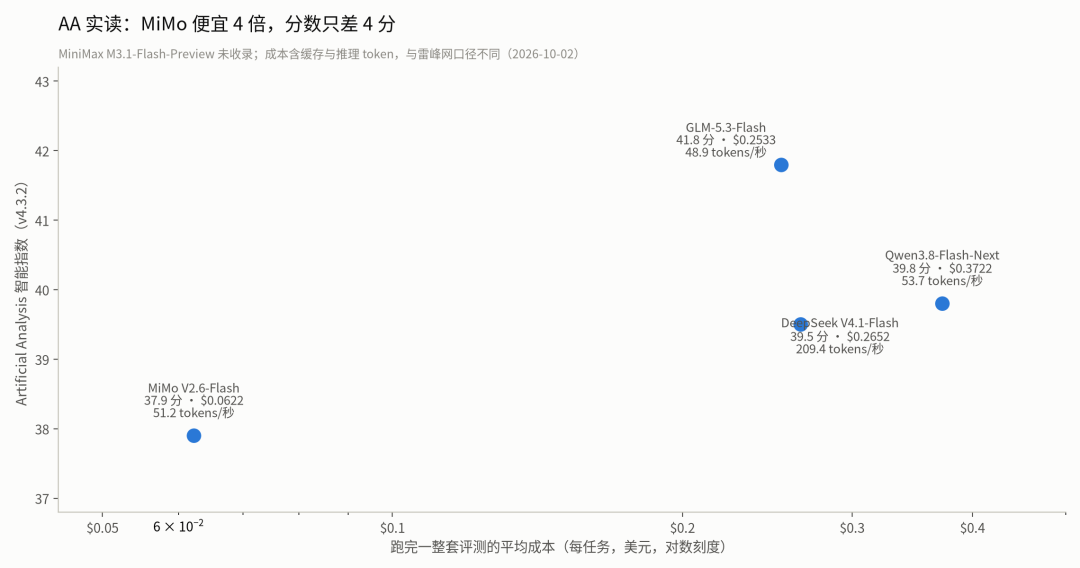
已上榜模型的成本与能力换算
在已进入Artificial Analysis统计的模型中,小米的门槛最低。MiMo V2.6-Flash的每任务成本为0.0622美元,不足GLM-5.3-Flash的四分之一,也仅为Qwen3.8-Flash-Next的六分之一,代价是智能指数37.9分,落后了两到四分。DeepSeek V4.1-Flash得分39.5,每任务0.2652美元,输出速度达到209.4 tokens/秒,是这批模型中最快的一个。GLM-5.3-Flash以41.8分排在最前,每任务成本0.2533美元。
三套账口径下先看输出价和缓存
需要区分的是,Artificial Analysis给出的每任务成本,和雷峰网用官方单价乘以实际用量的结果并非同一种算法。前者把缓存读写和推理token一并纳入,跑的是自己的题目集;厂商宣传的折扣又构成了第三套口径。三种计算方式摊在同一张桌上以后只能得出一个判断:谁更便宜,要看你跑的是什么类型的活。
面向个人工具、脚本和轻量前后端这类需求,Flash版本在近半年已足够应付,Qwen和GLM经过实测都达到了可交付水平。若真想压成本,最先要查的是输出价格和缓存折扣这两项。输出token占据账单的大头,缓存命中则能在此基础上再削减一笔。MiMo以0.02元的缓存价格在参测模型中处于最低位,更适合上下文重复度高的任务;DeepSeek的闲时价仅为高峰时段的一半,安排错峰跑批可节省一半开支。
至于旗舰款,80.49元这笔花销确实换来了一些东西,它在复杂工程中一次成功后保持正确的比率更高。但对多数使用者来说,这点差距未必对应12倍的价钱。不妨先利用免费周体验MiniMax,然后拿真实业务跑一遍账单,比拼任何排行榜都有说服力。这一轮免费开放的截止时间是10月7日。
图表数据来源见文中;概念图由 AI 生成。
小结:Flash级模型能否替代旗舰,取决于任务形态而非参数高低。9月的实测给出了明确区间:同一种全栈开发任务上,Flash的花费仅为旗舰的十分之一上下,并且成品基本可交付。选型时应把注意力放在输出定价与缓存政策上,用自家真实工作量核算,而不是把任一份榜单当作绝对依据。