10月6日,亚马逊云科技(AWS)对外宣布,其大模型服务平台 Amazon Bedrock 已经正式上架智谱的 GLM-5.3,双方将依据模型的调用量进行收入分成。消息由每日经济新闻、证券时报、金融界等多家媒体报道。
这一合作的看点并非"又有中国模型登上海外云",而是它第一次改变了算账的方式。以往国产大模型走向海外,常见做法无非三种:开源免费换取生态、自建 API 逐个谈客户、或者随硬件一并销售。而这次的情况不同——全球最大的云厂商之一把中国模型放上了自家货架,并按实际用量向中国的模型公司分成。
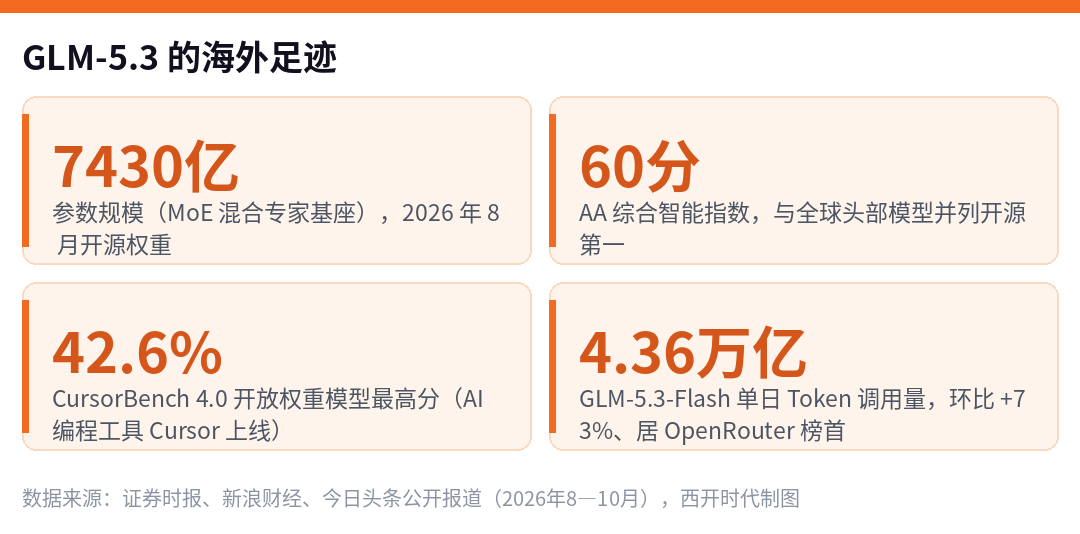
公开资料显示,智谱是港股上市公司(02513.HK,2026年1月上市)。GLM-5.3 是一款参数规模达 7430 亿的混合专家(MoE)基座模型,权重已于 2026 年 8 月开源。一个开放权重的模型,为什么能让全球云厂商愿意替它卖?这笔账背后有几条值得拆解的线索。
一、货架上多了一个中国模型,Amazon Bedrock怎么卖?
根据官方介绍,Amazon Bedrock 接入 GLM-5.3 之后,符合条件的企业客户能够在 Bedrock 平台上直接调用这款开放权重模型,AWS 则根据调用量同智谱进行收益分成。
这并非一桩孤立的买卖。据证券时报报道,智谱此前已与多家海外云厂商敲定了类似的分成安排;在国内,智谱同阿里云百炼平台签署了同类协议,华为云也已上架 GLM-5.3,并就这一合作模式达成意向。
把这件事拆开来看是三个要素的叠加:渠道是亚马逊云科技的大模型平台 Amazon Bedrock,商品是开放权重的 GLM-5.3,结算规则是依据模型调用量分成。对于模型提供方而言,这意味着不必再走"卖授权"的老路,而是能够在全球云平台的钱包中持续按用量分账。
对企业客户的影响同样明确:可选模型清单里增加了一个中国选项,采购时无需引入新的供应商,费用依旧是走原有云账单。门槛降低的同时,真正被考验的是模型本身是否足够好用。
二、智谱凭什么登上这张桌子:OpenRouter日调用量4.36万亿Token
分成只对有真实用量的模型开放,云厂商不会为一款乏人问津的产品分钱,GLM 系列在海外积累的活跃度才是这次谈判的筹码。
9月22日,全球 API 聚合平台 OpenRouter 的日榜数据表明,GLM-5.3-Flash 单日调用量达 4.36 万亿 Token,与上一个统计周期相比增长了 73%,在平台模型调用量中排名第一。进入 10 月初,AI 编程工具 Cursor 上线了 GLM-5.3 与 GLM-5.3-Flash,官方称其在 Max 推理配置下拿到了 CursorBench 4.0 开放权重模型的最高分 42.6%。
更早的 9 月 29 日,Anthropic 在一份报告中点了 GLM-5.3 的名,指出这款模型在网络安全方向上的表现有所增强——在 ExploitBench 的端到端漏洞利用测试里,它尝试 410 次、成功 50 次,与 Claude Mythos Preview 的 56 次相差不远。
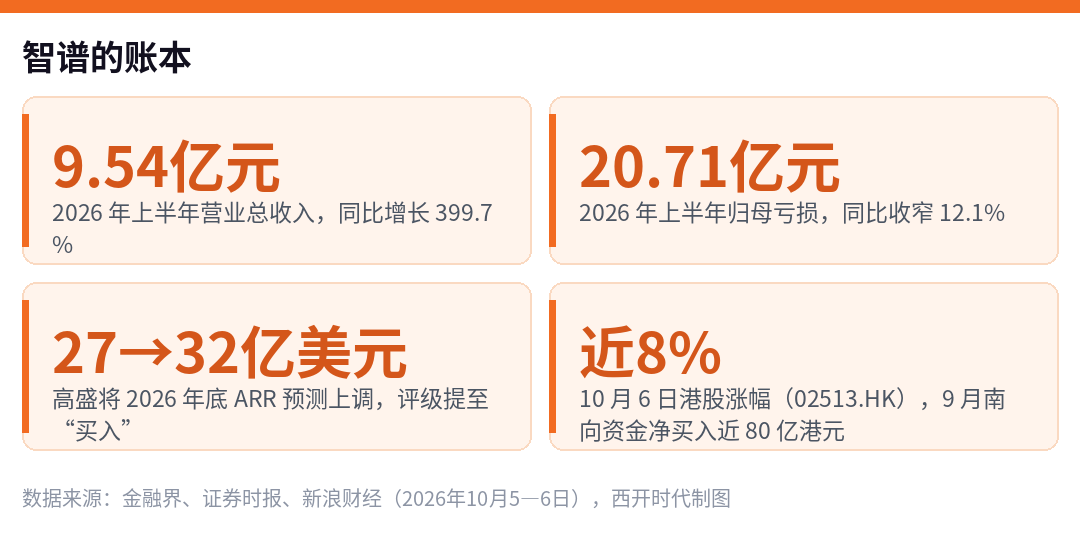
支撑商业想象的另一面是财务数据。2026 年上半年,智谱营业总收入 9.54 亿元,同比增长 399.7%;归母亏损 20.71 亿元,同比收窄 12.1%。10 月 6 日,高盛把智谱 2026 年底的 ARR 预测由 27 亿美元上调到 32 亿美元,评级调升至"买入",给出了 1560 港元的目标价。
资本市场的反应很快跟上:10 月 6 日港股智谱涨近 8%;9 月,智谱获得的南向资金净买入接近 80 亿港元,当月港股通买卖总额 933.76 亿港元,在全市场排第一。
换句话说,分成模式的意义不在于增加一笔收入,而在于让大模型从"一次性项目"转化为财务报表上的经常性收入。对一家尚在亏损阶段的公司而言,这比一次融资更为可贵。
三、三条出海路径,只有第三条走到了钱上
若把这一合作放回中国大模型出海的坐标系,路径大体只有三条:一是开源换生态,把权重免费释放,依靠全球开发者把调用量做起来,代价是无人为模型直接付费;二是自建通道,独立做 API,一家家去谈企业客户,收入直接但周期长、合规成本高;三是走上全球云的货架,按 Token 用量分成,也正是这次选择的方向。
迹象表明第三条路正在成为共同选择。9 月 30 日,美国 AI 基础设施公司 Baseten 宣布,企业用户能够在 OpenAI 的编程工具 Codex 中直接调用月之暗面的 Kimi K3,费用可计入企业已有的 OpenAI 采购承诺,这是中国开源模型第一次进入 OpenAI 的企业付费结算体系。同日,DeepSeek 开源了面向华为昇腾算力平台的基础设施组件,涵盖高级语言编译工具、计算库以及分布式通信库。两者放在一起,方向已相当清楚:一种向上进入海外云的结算体系,一种向下补齐国产算力的软件栈。
参照系也很明确——Amazon Bedrock 原本就是 Anthropic 与 OpenAI 的重要分销渠道。GLM-5.3 站上同一排货架,也意味着海外企业客户的选型清单里第一次有了中国模型的身影。
但短板必须说清楚。分成收入等于真实用量乘以单价,上架只是入场券,海外企业是否会长期续用,取决于模型在真实业务场景中的稳定性与整体成本;地缘与合规层面的风险尚未消失,中国模型在欧美政企市场的准入存在不确定性;开放权重本身也是双刃剑,海外厂商完全可以自行部署而回避分成;上游先进制程与高端存储的供给,依旧是左右训练与推理成本的硬约束。出海最难的一关,自始至终不是把模型做出来,而是让别人的账本愿意为你留出一行。
四、成都这张牌:智谱全国总部与诸葛大模型的绑定
智谱与四川之间的联系,比很多人想得更紧密。2025 年 3 月,成都高新区宣布以 3 亿元战略投资智谱华章,双方联合打造四川省首个基座大模型"智谱诸葛大模型";同期,总投资 3 亿元的智谱诸葛大模型全国总部项目签约落地成都高新区,计划建设诸葛大模型研发中心,围绕诸葛大模型及其迭代衍生模型做研发,同时推进面向企业的垂类模型业务。
也就是说,智谱的"全国总部"与四川的"省级基座"都压在成都。GLM 系列在海外云上卖得越好,这个总部承担的研发与收入分量就越重。
放到产业链层面,本地能够承接的活大致分三段:一是政务、制造、能源、医疗这些四川有实际场景的垂类,需要有人把模型嵌进业务流程;二是成都智算中心等本地算力平台与模型之间的适配调优,这是把算力转化成产品的关键一步;三是模型备案、数据合规与信创适配,本地服务商在这个环节最容易形成壁垒。
短板同样摆在明面上:四川本土没有头部基础模型公司,省级基座依赖外部技术;应用层活跃而底座层依赖外部输入;人才与资本的密度仍低于北京、深圳、杭州。更需要留意的是,智谱的海外收入计入上市公司账目,不会自动变成本地产业增量——"总部"能否真正做成研发、营收与人才同时到场的实体,才是这道题的答案。
各方可以做的不尽相同。政府部门的工作重点,是把"基座模型总部在成都"落实到研发投入与税收统计上,并给垂类应用以场景和订单,而不是只挂一块牌子。应用企业不妨趁分成之后 API 价格与供给稳定性改善,先把可量化的场景跑起来,例如客服、质检、文档与代码,用 Token 台账核算投入产出,再决定是否自建。服务商与投资机构则应关注"模型—云—算力"三段之间的集成与合规服务:模型的每一次出海,订单往往最先传导到本地交付与合规环节。
小结: GLM-5.3 上架 Amazon Bedrock 的关键不在于又一个中国模型出海,而在于出海方式由技术输出走到了商业结算。需清醒看待的是,上架只是入场券而非收入,分成取决于海外企业的长期真实用量;对成都而言,全国总部与省级基座落在这里是位次,能否长出研发团队、营收和人才才是未来两年真正的增量答案。