谷歌安全团队公布了一项实验:通过大模型把历史遗留的C代码迁移为内存安全的Rust实现,并交出了可上生产的工程化答案。被选中的目标是一个约3000行规模的图像处理库giflib,它长期在实际业务中解析来源不可信的图像文件,而且往往在关闭进程隔离的情况下运行。最终产出的Rust版本与原库ABI兼容、可以直接顶替原共享对象,同时关闭了原有的进程隔离沙箱,延迟指标没有变差,并抢在软件工程师Bastian Kersting与Max Hils所提及的外部漏洞公开编目前,修复了一个此前尚未打补丁的堆写入零日问题。
三阶段迁移回路:先翻译,再校准FFI,最后用差异测试收口
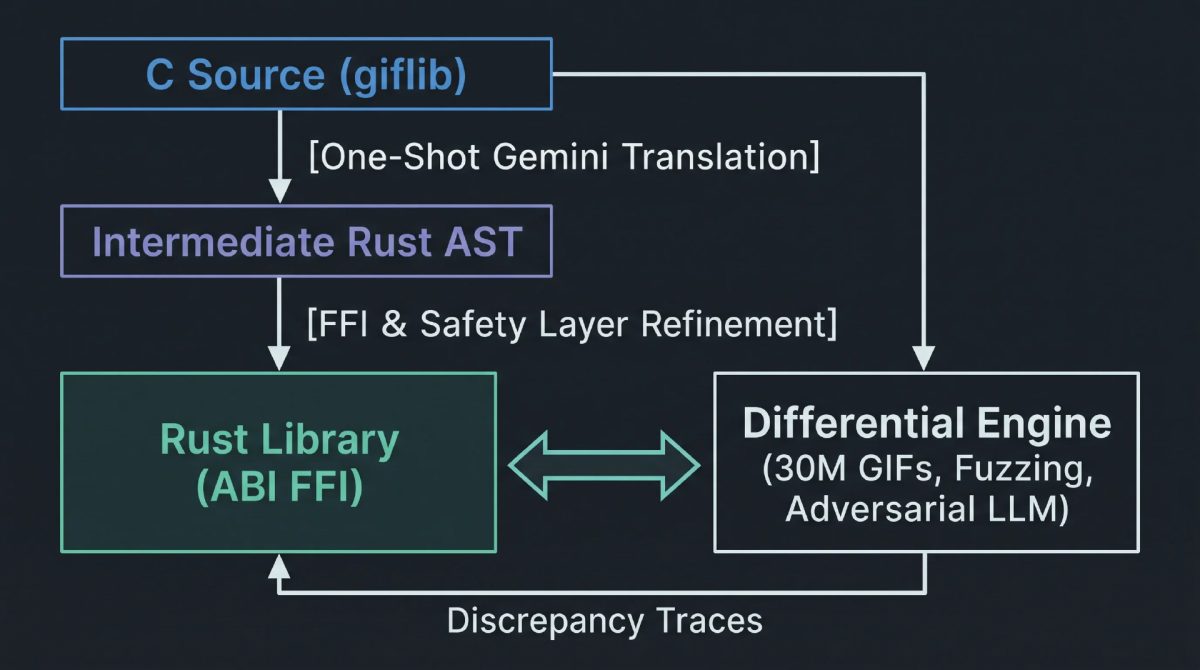
在成熟的C/C++技术栈里,容易引发内存破坏的问题大约占高危安全漏洞的七成。面对这一现实,团队既没有选择周期以年计的手工重写,也没有把全部希望押在运行时边界检查上,而是搭建了一个以自动化反馈为核心的迁移管线,把工作切成三个阶段。
第一步是用一次性提示词让Gemini把整个C库的逻辑成体系地转换到Rust。为了让替换对外部调用方透明,工程师完整保留了原来的导出符号与结构体定义,确保下游代码无需改动即可链接到新实现。
第二步处理跨语言边界的风险。初始几轮生成中,外部函数接口(FFI)层出现了不安全的裸指针语义,必须由人工逐处审核,梳理并收窄指针的所有权与生命周期约束,这一步无法交给模型独立完成。
第三步是差异驱动的自动修补。自动化差异测试引擎负责比对两个实现的行为差异,把带失败轨迹的用例回传给模型,让其迭代产出补丁。为避免指针越过C语言边界后触发未定义行为,FFI封装层会从裸指针重新构造出安全的Rust句柄,例如对外暴露的DGifCloseFile这类入口。
上线前验证:3千万真实文件逐比特比对,2亿次迭代无功能漂移
要把自动生成的代码推向核心业务基础设施,必须拿出语义等价的硬证据。验证管线先对3000多万个真实GIF文件做大规模回归解码,逐一比对渲染结果是否逐比特一致。
与回归测试并行的,是一套自动化差异模糊测试器。它让两套运行时并排跑,连续六天累计执行2亿次迭代,期间未观察到功能漂移。测试套件还引入了对抗性的LLM评估提示词,直接阅读两个代码仓库,专门寻找可能的行为分歧。这套组合最终在LZW解压器中挖出了一处未被处理的边缘情况,同时暴露出一个来自原始C源码内部补丁引入的越界写入问题。
预发布阶段撞上真实零日:Rust替代版从根上不受影响
该方案最具说服力的验证来自发布前夕。一位外部安全研究人员在上游giflib中发现了越界堆写入漏洞,后被登记为CVE-2026-26740。就在漏洞对外披露之前,谷歌这套Rust替代实现的生产节点因为底层语言层面的安全约束,天然对该问题免疫。这意味着一次架构级的语言迁移,可以提前消灭一整类漏洞,而不再依赖紧急打补丁。
性能方面,业界常见的担心是Rust强制边界检查会带来运行时损耗。全球图像解码集群的生产监控给出了相反结论:Rust二进制的运行表现与原C程序持平。安全性被内嵌进类型系统之后,平台工程师得以撤掉过去专为隔离图像解码任务而设的操作系统沙箱,取消这层进程隔离边界后,P99尾部延迟明显下降。
不是一键灵药:上游分叉维护与FFI人工介入仍是长期成本
上游分叉与FFI安全的持续代价
作者提醒,AI代码翻译并非可以完全放手的通用方案。只要上游C依赖发布新特性或架构调整,分叉出来的Rust库就需要持续跟进,维护成本长期存在。FFI封装同样离不开领域专家,否则可能出现生命周期泄漏,线程安全约束也可能被破坏。
社区争论:AI辅助vs确定性转译器
r/rust与Hacker News上的讨论普遍认可这项成果,同时也围绕AI辅助移植的实用性和安全边界展开争论。不少评论肯定了谷歌的差异模糊测试框架,因为它连自家遗留C补丁里的越界写入问题都能找出;但对“一次性直接翻译”路线存疑的人指出,审阅细微语义退化、修补不安全的C FFI边界,工作量往往比让模型写代码更大。很多声音认为,如果代码库不都是giflib这类简单自包含项目,更稳的路径是先用c2rust之类的确定性转译器过一遍,再用AI把它重构为安全、地道的Rust。
目前谷歌已将生成的库以giflib-rs为名开源,供正在考虑对基础工具链做自动化语言迁移的团队参考。
来源:InfoQ(英文原文:https://www.infoq.com/news/2026/09/c-rust-rewrite/)
小结:谷歌用Gemini加差分模糊测试把giflib从C迁到了ABI兼容的Rust,靠3千多万文件回归与2亿次模糊迭代兜底语义等价,且生产性能不降、P99延迟因去掉沙箱反而更好。CVE-2026-26740的提前免疫说明:对边界清晰的小型基础库,这类迁移已能换来真实的体积安全收益。