Uber 近日在官方博客中披露了其新一代扩缩容组件 ServiceScale 的设计思路:让多个编排器能够同时安全地介入同一批 Kubernetes 工作负载的扩缩容流程。该文由高级软件工程师 Egor Grishechko 与 Srikar Paruchuru 共同撰写,核心是把「想要多少副本」的意图与「如何落地执行」的动作分离开来,从而在不必常年预留空闲资源的情况下完成区域级故障转移。
Uber 容器平台规模:100+集群、4000 服务、300 万核
Uber 的容器平台团队负责跨自有数据中心与公有云(其中包括 Oracle、谷歌)的 100 余个计算集群,其上承载约 4000 个服务,动员 300 万核 CPU 算力,每日拉起 150 万个 Pod。团队自研的内部平台名为 Up,扮演 Kubernetes 集群间联邦层的角色。服务负责人借助 Up 发布构建产物、声明扩缩容期望;真正把这些期望翻译成 Kubernetes 原生对象的,是专门的控制器——Uber 部署控制器(UDC)。InfoQ 早前曾就 Uber 迁移至 Up 平台、以及随后完成的 Kubernetes 迁移做过报道。
为什么要把扩缩容意图拆出来
这一次架构改动,起因于 Uber 对区域故障转移方式的重构。该公司在不同区域布置了双活数据中心,一旦某个区域失联,流量会被引导至幸存的区域,而后者必须具备足够闲置算力来接住额外负载。此前 Uber 的做法简单直接——每个数据中心都留出一批备用空闲资源。新的目标是转而调借低优先级工作负载占用的容量:故障来袭时先缩减低优先级负载,再把资源腾给高优先级业务。
这样一来便多出了新的扩缩容意图来源。Up 与 UDC 依旧负责服务日常期望状态的维护,可故障转移编排器同样需要参与副本数量的决策。团队评估过直接在 UDC 上叠加故障转移逻辑,但否决了这一方案。原因在于 UDC 本就位于服务生命周期操作的关键路径,硬塞入故障转移专属行为只会抬高该控制器的复杂程度。Grishechko 和 Paruchuru 在文中写道,「故障转移处理一旦出现回归问题,不会只停留在故障转移层面」,它有可能波及整个集群的常规部署。
于是团队另辟蹊径,新增了一个名为 ServiceScale 的自定义资源定义(CRD)以及配套的服务扩缩容控制器(SSC)。各编排器都能经由 ServiceScale 提交各自的扩缩容诉求,由 SSC 汇总所有意图后调和对齐为 Kubernetes 对象。两位工程师强调,这套模型刻意保持了轻量。
「我们不想额外引入外部数据库、独立协调服务或是控制平面,否则在故障应急场景下,调试难度会大幅上升。」——Egor Grishechko 和 Srikar Paruchuru
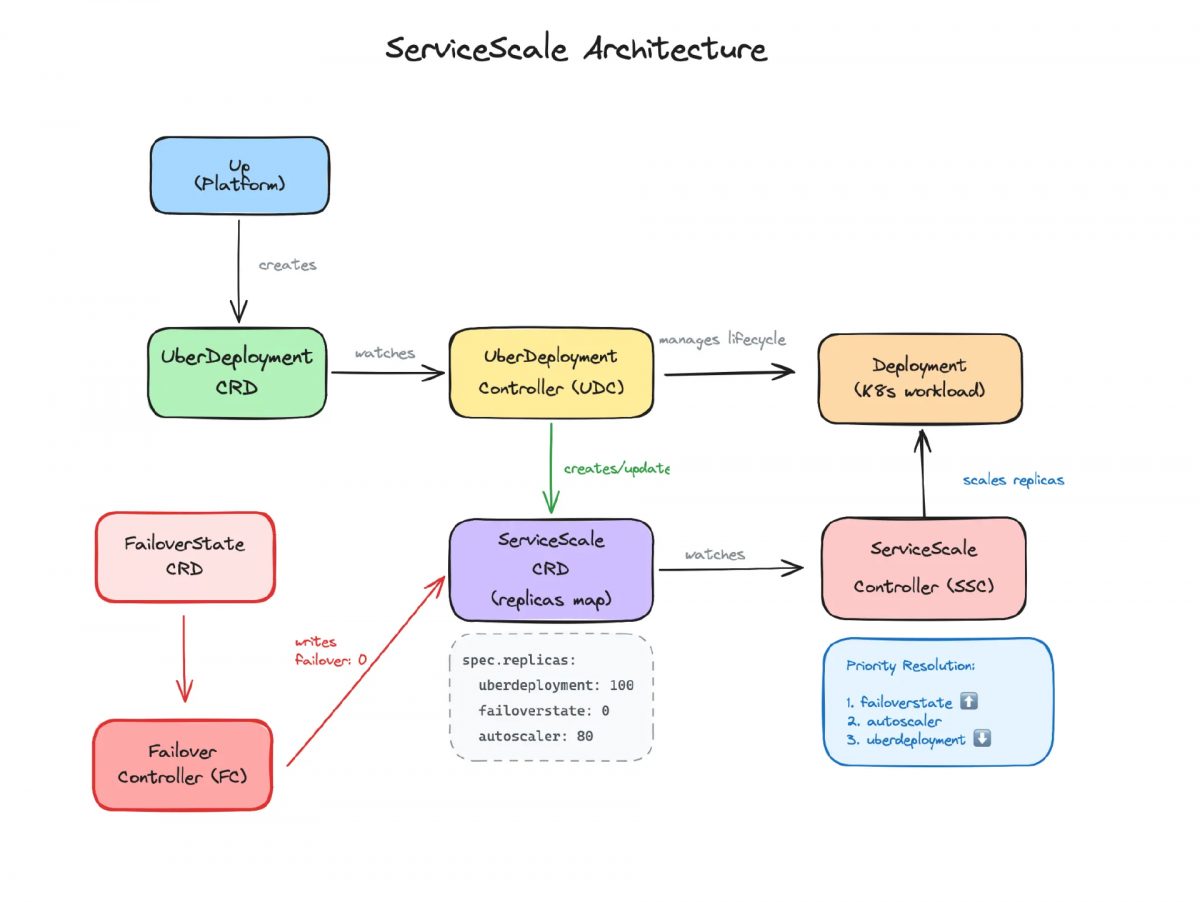
将扩缩容意图直接做成 Kubernetes 资源,可观测性随之提升:出问题时工程师只要翻看 ServiceScale,就能弄清是哪个编排器提出了什么要求。故障后的回恢复也变得更轻松,因为稳态与临时故障转移两套信息都留在 CRD 规范中,复原的过程无需从日志里重新拼凑状态。
三类生产教训:失效缓存、多写入者竞态与一致性防护
博文公开了三段来自生产环境的实战经验。首要问题是 Informer 缓存过期。与绝大多数 Kubernetes 控制器一致,Uber 的控制器读取资源时依赖 Informer 缓存,而缓存中的内容要滞后真实状态若干秒。Up 将状态字段当作最终裁决依据:一旦 UDC 反馈成功信号,工作流中不可回退的后续步骤就会被触发。为此工程师落地了「读己所写」(read-your-writes)的一致性防护:控制器写下游资源的同时,把当时的资源版本号以注解形式打上;在回传状态之前,先确认本地缓存已经至少读到了该版本。
这类麻烦并非 Uber 一家独有。2026 年 4 月发布的 Kubernetes v1.36 引入了针对控制器缓存过期问题的缓解方案,思路与之相似——若缓存里最新的资源版本低于控制器刚写过的版本,控制器就按兵不动。Kubernetes 项目也在和 controller-runtime 协作,争取让依赖该框架的所有控制器都具备「读己所写」语义。软件工程师 Prasad M K 在 LinkedIn 上分析此事时,把「读己所写」的缺失归为「API 契约问题,而非后端缓存问题」,主张用版本令牌来校验读写一致性;他讨论的是应用层视角,而 Uber 的处理落在 Kubernetes 控制器范式之内。
第二重挑战来自多写入者系统。UDC 与 SSC 同时改动同一个 Kubernetes 资源时,特定时序条件会让 ReplicaSet 进入不一致状态,其元数据与规范之间出现漂移,滚动更新所依赖的比例扩缩容随之失效,工作负载有时会就此卡死。工程师给 UDC 加上了全集群级别的观测能力,用来发现元数据与规范的错配,同时开发了自动修复程序,对受影响的 ReplicaSet 进行修补,并在扩缩容路径上着手长期修复。2026 年 1 月发表于 arXiv 的一篇论文(内容涉及 Uber 故障转移架构)提到,更宏观的统一故障转移体系已经把稳态配置从 2 倍压到 1.3 倍,释放出超过 100 万个 CPU 核。该方案沿用渐进、稳妥的上线思路,InfoQ 此前也报道过 Uber 在持续部署优化上对安全发布的强调。
整套方案从启动到上线耗去一年时间。过程中团队借助预发布环境与金丝雀发布控制风险,并基于 KubeKind 测试工具构建集成测试,模拟控制器之间的交互、捕捉竞态条件。方案对原生 Kubernetes Deployment 与 OpenKruise CloneSet 均予以支持,最终没有任何客户能够感知到的中断。用 Uber 的话说,「多编排器系统的难点不在于 API,而在于多次写入之间发生的各类并发问题」。
多编排器分布式难题正在平台层获得回应
Uber 的这套做法,映照出在生产环境中引入多编排器 Kubernetes 后不可避免的分布式系统课题。CNCF 最近将多集群编排项目 Karmada 正式毕业,它用一套不同架构回应跨集群故障转移的需求。Kubernetes v1.36 增设的缓存过期缓解机制,也表明同类问题已经开始在平台层面得到正视。
小结:Uber 用 ServiceScale 把扩缩容意图和执行动作彻底拆开,让故障转移时能动态借用低优先级资源,把稳态配置从 2 倍降到 1.3 倍、释放逾 100 万 CPU 核。更值得关注的是它的副产品——失效 Informer 缓存与多写入者竞态这两类分布式难题,已被 Kubernetes 社区和 CNCF 项目在平台层接管。据 InfoQ 报道,该方案耗时一年落地且未造成客户可感知中断。