在 .NET 技术栈里做计算机视觉开发的工程师,长期面对一个两难局面:模型往往在 Python 生态中完成训练,真正要落实到 C# 项目里跑推理时,就得额外搭一层 Python 微服务,或者把 emgucv 这类体量很大的库拖进来,导致部署环节光是拉依赖就要消耗大量时间。YoloDotNet 正是针对这一痛点出现的项目,它的 README 开篇就写明立场:No Python,No OpenCV,No magic。据公开信息,该项目两年前曾被介绍过,如今已经升级到 v4.2,前后两个大版本的 API 差异相当明显——v2 依赖 ImageSharp 加载图像、配置项平铺放置,v4 则转为采用 SkiaSharp,并引入模块化的执行提供程序。
一句话概括:纯 C# 的 YOLO 推理引擎,技术底座是什么
YoloDotNet 本质上是建立在 .NET 8、ONNX Runtime 与 SkiaSharp 三者之上的 YOLO 推理库,全部代码用 C# 实现。它覆盖的任务类别包括分类、目标检测、旋转框(OBB)检测、实例分割以及姿态估计,输入形态上同时兼容静态图片与视频流。
支持的模型阵容:从 YOLOv5u 一直覆盖到 YOLOv26
模型兼容范围是其突出特点。该库覆盖了从 YOLOv5u 起、直至最新的 YOLOv26 这一整条模型谱系,此外还接入了 YOLO-World、YOLO-E 以及 RT-DETR。换言之,只要 Ultralytics 发布新的模型版本,YoloDotNet 基本上都能够紧随其后完成适配。值得注意的是模型导出时的 opset 版本区分:YOLOv5u 到 v12 需要采用 opset=17,而 YOLOv26 则必须使用 opset=18,文件名上对应 yolov8n.pt 与 yolo26n.pt 等不同权重。
硬件加速的后端设计:执行提供程序按需分包,但有使用约束
在硬件加速层面,项目将执行后端拆成彼此独立的 NuGet 包进行模块化集成,可选方式包括:CPU、CUDA / TensorRT(其中 TensorRT 不必另外单独安装包,CUDA 包内已包含)、OpenVINO、CoreML 以及 DirectML。对于刚上手的开发者,README 建议先从 CPU 后端切入。这里存在一个需要留意的坑:执行提供程序一次只能安装一个,如果多个后端混装,会触发原生运行时冲突,README 中甚至专门用了感叹号予以强调。
用法示例上,代码会先引入 YoloDotNet 主包与 YoloDotNet.ExecutionProvider.Cpu 扩展,随后通过 ExecutionProvider 与 YoloOptions 构造运行参数,指定 CpuExecutionProvider,加载 model.onnx 与 image.jpg,调用 RunObjectDetection 并设定 confidence,最终把识别结果写为 result.jpg。相较 v2.x 时代用 ImageSharp 读图、在 YoloOptions 中堆叠平铺配置的做法,当前的结构更清晰:模型加载、与执行后端绑定、实际推理调用这三件事各归其位。
v4.2 带来的实用新增能力:ROI 推理、训练数据反哺与 JSON 导出
该近期版本的更新内容具备较高实用性,几个要点如下:
其一是 ROI 区域推理,即把检测范围限定在图像或视频流的某块指定区域内完成。对监控类项目而言意义直接:在一幅 4K 画面中如果只需关注门口那一小块区域,推理计算量能够被压掉很大一部分。
其二是直接将结果导出为训练数据。通过 ToYoloFormat() 与 SaveYoloFormat() 两个方法,可以把推理所得保存成 YOLO 标注格式。这为「用模型先行预标注、再由人工修正」的数据闭环提供了极大便利,而在此之前这一步往往要自行写转换脚本。
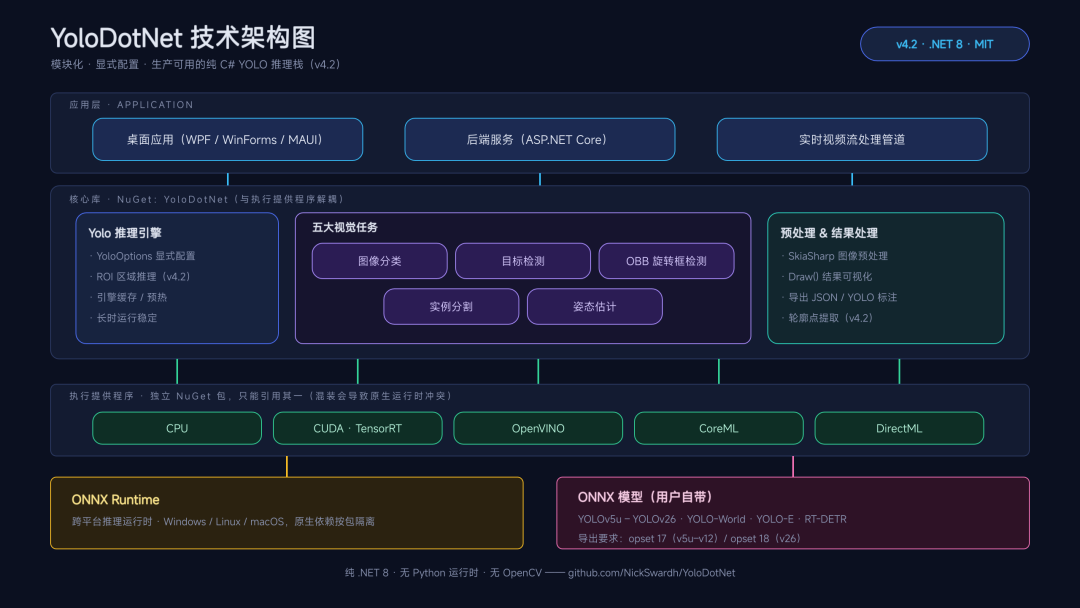
其三是 JSON 导出与轮廓点提取,对应 ToJson()、SaveJson() 与 GetContourPoints(),分割出来的结果若要对接外部系统,不必再自行做序列化处理。
除此之外,该版本还为分割物体增加了边缘线绘制,视觉呈现更为分明;同时 YOLOv26 的推理执行流程也已经与其余任务完成对齐。
一个常被跳过、却直接影响准确率的关键点
README 特别做出提醒:推理精度并不是装好就自动达到的。图像缩放方式、采样方法、confidence 与 IoU 这三个预处理参数必须和训练模型时候的设定保持一致,否则输出质量会莫名其妙地变差。作者给出的建议是,在调整模型、评估效果之前,先去读仓库中的 Accuracy & Configuration Guide。这个提醒相当务实——不少人遇到的「同款模型换一个框架就不准了」,问题源头基本都落在这里。
性能与许可:稳定延迟背后的权衡,以及不可忽略的模型许可风险
在性能方面,官方仓库里附带了一份基准测试(路径为 /test/YoloDotNet.Benchmarks),其测得的特点是预热完成之后延迟表现比较稳定,且内存分配的行为可以预判,这一特性让它适合承载长时间在线的服务场景。
另有一件需要格外留意的事情涉及 license。YoloDotNet 自身是 MIT 协议,使用方法相当宽松。但它只得被定义为推理引擎,仓库中不含任何预训练模型,使用需要自行导出模型。问题在于 Ultralytics 的 YOLO 系列模型大多是 AGPL-3.0 协议,或者需要付费获取商业授权——倘若项目涉及商业用途,务必先确认模型授权状况,不要等到产品已经上线才意识到存在合规隐患。作者在 README 里也用 Warning 标注清楚了这一点,态度算得上负责。
落地场景与工程取向:哪些场合适合引入这个库
按实际落地情况来看,这类库的典型用途可以归纳为四个方向:监控场景下的视频流实时检测,通常会搭配 ROI 功能做区域布防;工业产线上的缺陷检测,这一场景的经典搭配是 Windows 工控机加上 CUDA;姿态估计方向的动作捕捉与训练分析;以及不希望专门为推理维护一套 Python 运行环境的各类情况。
从项目本身来看,打动人的地方并不局限于某单项能力,更多是它的工程取向——不设置隐藏预处理,不存在隐式行为,执行过程、内存占用、预处理环节全部属于可显式控制的范围。对要求行为可预测的生产环境而言,这套思路的价值要高于跑分上涨几个百分点。项目地址为 https://github.com/NickSwardh/YoloDotNet,若正在用 .NET 技术栈从事视觉相关的开发工作,可以关注一下。
小结:YoloDotNet v4.2 用纯 C# 打通了 .NET 8 上的 YOLO 推理链路,模型谱系覆盖至 YOLOv26 并支持 RT-DETR、YOLO-World 等,硬件后端按模块分包、提供 ROI 推理与训练数据导出等实用能力。采用前需重点核实两点:执行提供程序只能装一个以避免原生运行时冲突,以及很多 Ultralytics 模型为 AGPL-3.0 或需商业授权,商用前必须先过合规关。