近期有开发者在 Codex 环境下,对国产多模态模型 GLM-5.1 与原生 GPT-5.4、GPT-5.5 的 Computer Use 能力做了一次横向对照测试,结论指向一个不一致的现象:GLM-5.1 在网页填表和键鼠操控类任务上明显掉队,而在多模态数据输入、图像分析这类基础环节,表现并不差。
Computer Use 为何是多模态的终极考场
Computer Use 指的是模型直接驱动计算机完成操作,涉及三条能力线:一是屏幕视觉理解,二是键盘与鼠标的动作执行,三是网页层面的交互,包括读懂 UI 结构并填写表单。这个场景比单纯识别图片难度高出不少,模型既要把屏幕看懂,还得把动作做对。
在这套测试中,Codex 侧依靠 Desktop Touch MCP 承担操作执行,其引擎用 Rust 编写并基于 Windows UI Automation。工作流程是把桌面截图交给模型,由模型回传动作指令,例如点击坐标、键入内容、滚动幅度,由底层环境执行。
两套接入方式决定起点差异
GLM-5.1 走的是 API 网关桥接进 Codex 的路线,模型侧配置 GLM-5.1、temperature 0.1,视觉输入为 Base64 编码的 PNG 截图,分辨率为 1920x1080,返回格式是自定义 JSON Schema,包含 action_type、coordinates 与 input_text 字段。
GPT-5.4/5.5 则由 Codex 原生支撑,不需要额外桥接,自带 Computer Use 工具链,可直接输出结构化操作指令,后端还存在对 Windows UI Automation API 的集成。
测试环境方面,系统为 Windows 11 Pro 22621,浏览器为 Chrome 126.0.6478.127,执行组件为 Desktop Touch MCP v1.10.4,截图统一为 1920x1080 的 PNG。
五类任务覆盖网页与键鼠两条主线
测试者设计五个典型场景。任务一是在 GitHub 提交 Issue:打开 github.com/new,标题填 “Bug: Login button not working on mobile”,标签选 “bug”,描述填 “When I click login on iPhone Safari, nothing happens”,最后点击 Submit。
任务二是填写问卷星问卷:打开某条问卷星链接,答完 5 道单选题与 2 道填空题后提交。
任务三是记事本编辑:启动记事本,录入 50 字文本,选中前 10 个字并删除,再把文件保存在桌面。
任务四是 Windows 文件操作:打开资源管理器,进入 D:\Project,找到目标文件夹并打开,再把其中某个文件复制到桌面。
任务五是多窗口切换:同时打开 Chrome 与 VS Code,在 Chrome 中检索一段代码,随后切换到 VS Code 粘贴检索结果并存盘。
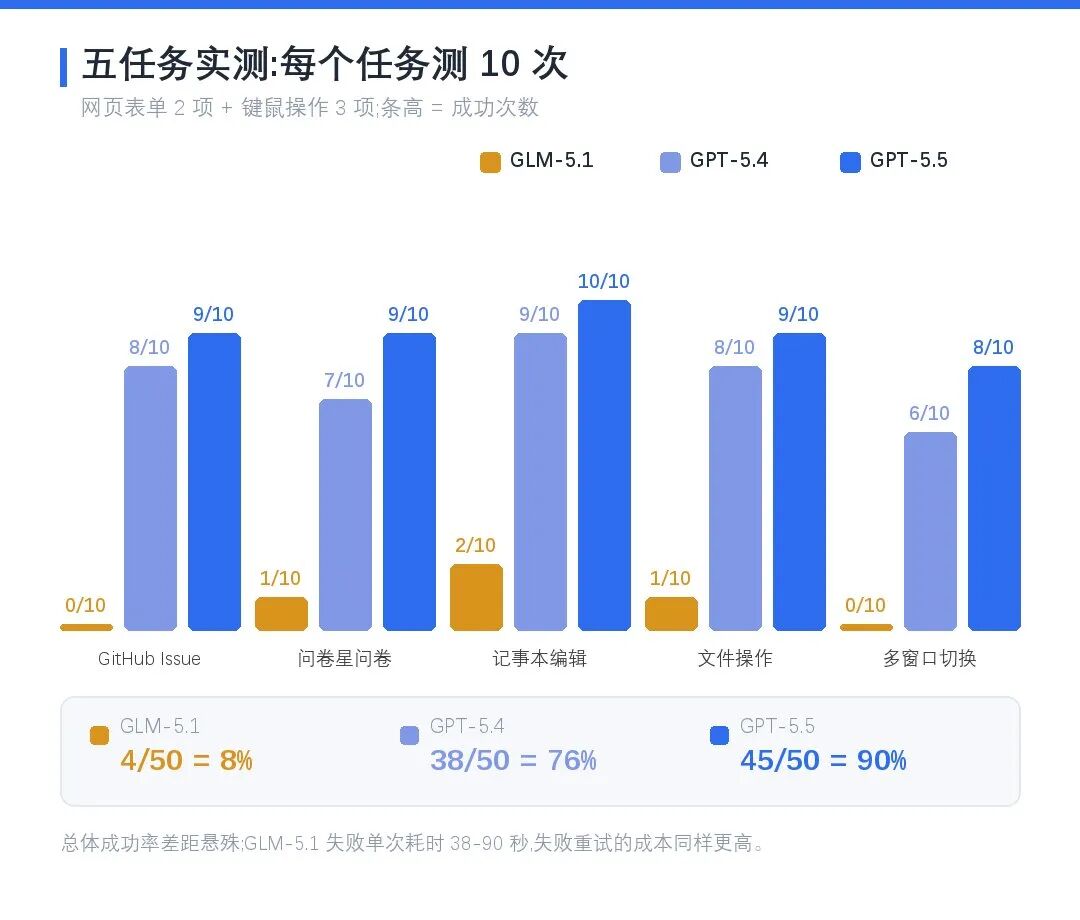
以上每个任务重复测试 10 次,分别统计成功率、平均耗时与失败原因。
总体成功率差距:8% 对 76% 对 90%
把五个任务的 50 次尝试合并计算,GLM-5.1 仅在 4 次中完成,成功率为 8%;GPT-5.4 完成 38 次,成功率 76%;GPT-5.5 完成 45 次,成功率 90%。测试者对三者的稳定性评价是:GPT-5.5 表现最稳,GPT-5.4 速度略占优但偶有失误,GLM-5.1 基本无法完成任务。
失败形态一:坐标定位偏差 50-200px
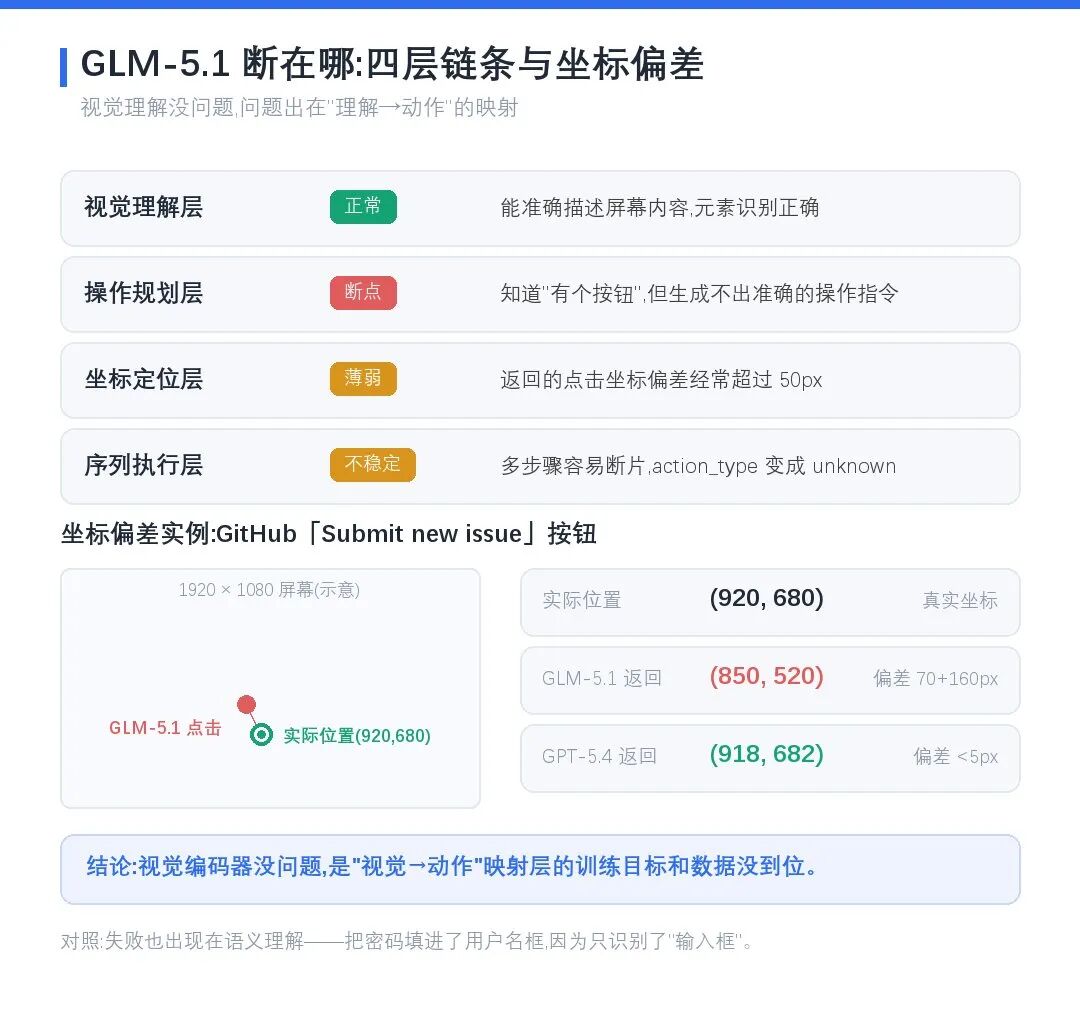
实测中最直接的问题是 GLM-5.1 回传的点击坐标经常偏离 50-200px。以 GitHub 的 “Submit new issue” 按钮为例,按钮真实位置为 (920, 680),而 GLM-5.1 给出 (850, 520),横向偏离 70px,纵向偏离 160px,最终点到的是页面空白区域。
测试者判断,原因可能在于 GLM-5.1 的视觉编码器面对高分辨率截图时,缺少充足的坐标定位类训练。它能判断画面中存在按钮,但无法在像素级把位置锁定准。作为对照,GPT-5.4 在同一按钮上返回 (918, 682),误差不到 5px。
失败形态二:多步骤执行中途断层
GLM-5.1 在跨步操作中也常出现中断。问卷星任务中的典型表现是:第一步填入姓名勉强成功;第二步选择第 1 题选项时因坐标不准失败;第三步返回的 JSON 中 action_type 变为 “unknown”;到了第四步,后续步骤整体丢失。
GPT-5.4/5.5 的处理方式不同,它们会逐步回传状态,即使某一步失败,仍可尝试修正。
失败形态三:看得见元素却误解语义
另一种情况是元素被识别但语义被误读。GLM-5.1 能判断“这里有个输入框”,却分辨不出“这个框是用来填邮箱的”。在登录页面上,页面同时存在用户名与密码两个输入框,GLM-5.1 把密码写进了用户名栏位,原因就是它只捕捉到“输入框”,没有理解字段含义。
GPT-5.4/5.5 则会读取placeholder文案与 label 标签,从而判断每个框应该填什么内容。
失败形态四:多窗口切换近乎全失
任务五这类多窗口切换场景,GLM-5.1 全军覆没。测试者归纳出几层原因:单张截图只能反映一个窗口;GLM-5.1 不掌握另一个窗口所处位置;它缺少“窗口列表”这一概念;最终也无法产出 Alt+Tab 之类的切换指令。
相比之下,GPT-5.4/5.5 具备窗口管理 API 的调用能力,可以枚举窗口、获取窗口位置并完成切换。
反差点:静态看图反而是强项
值得注意的是,当测试范围收窄到单纯的“看图说话”,GLM-5.1 的成绩相当不错。给它一张网页截图并让它描述内容,它给出的答案包括:这是一个 GitHub 创建 Issue 页面;页面顶部有仓库名称 “user/repo-name”;中间是两个输入框,分别对应 Title 与 Description;右侧是 Labels 选择区域,可看到 “bug”“enhancement” 等标签;底部有一个绿色的 “Submit new issue” 按钮。
这段描述元素识别准确。问题在于它虽然“知道”,却没能落实到“点下去”。测试者据此判断,GLM-5.1 的视觉编码器本身没有缺陷,真正薄弱的是从视觉到动作的映射层训练。
原生适配与桥接适配造成的差异
一个关键变量是接入形态。GPT-5.4/5.5 属于 Codex 原生适配,内置 Computer Use 工具链,其返回操作指令的格式包含 tool 字段取值 “computer”、action 字段取值 “click”、coordinates 数值 [920, 680]、element_description 取值 “Submit new issue button”,以及 confidence 取值 0.95。
GLM-5.1 则经 API 网关接入,过程需要先把截图转成文本描述,再让模型生成操作指令,中间多出一层转换,而且未接受专门的坐标定位训练。
测试者推断 OpenAI 的 Computer Use 能力源于针对性训练,包括数百万次“截图→操作”配对数据,模型由此学会“看到某个 UI 元素即输出对应坐标”,本质属于视觉与动作之间的映射训练。而 GLM-5.1 的训练数据重心可能更偏向图像理解(这是什么)与文本生成(描述这张图),相对缺少坐标定位与操作序列规划方面的训练。测试者强调,这并非模型架构层面的问题,而是训练目标的差异。
OpenAI 方案同样不是“真多模态”
测试者同时提醒,OpenAI 的 Computer Use 也并未走向真正的多模态。其实现步骤是:通过 Windows UI Automation API 取得元素树;将截图与元素树一并送入模型;模型输出含坐标的操作指令;由 API 执行操作。
这是一种工程化路径。模型被训练成识别屏幕元素、计算坐标、调用底层 API 三段式能力。优点在于精准、可控,在 Windows 上效果良好;缺点在于依赖微软 API,跨平台迁移困难,Linux 与 macOS 需要重新适配。
DeepSeek 选择的是语义级路线
据公开的技术讨论,DeepSeek 的探索方向不太一样,更接近原生多模态。
第一点是不依赖坐标运算,模型直接输出语义级操作。示例中操作描述包含 action 字段取值 “input_text”、target 字段取值 “login_form.username_field”、value 字段取值 “user@example.com”;另一种表述方式则为 coordinates 数值 [245, 320] 配合 input 取值 “user@example.com”。
第二点是端到端视觉—动作学习,训练样本采用“截图→操作意图”配对,而非“截图→坐标”配对。模型学到的是“看到登录框就知道填用户名”,而不是“看到登录框后计算其像素位置”。
第三点是引入抽象操作层,定义一套可跨平台流转的操作语义,例如使用 click(element_id) 代替 click(x, y),用 input(field_selector, text) 代替 type_at_position,这套语义再映射到不同平台的底层 API。
在对比表格中,DeepSeek 所处路线的适配性被标注为“Windows 优先,其他需重训练”,其实现方式为“API 辅助 + 坐标计算”。测试者的概括是,DeepSeek 这条路更像是“让模型像人一样理解界面”——人并不需要知道按钮的精确坐标,只需知道“点那个提交按钮”。
四层能力拆解:断点究竟在哪里
测试者认为 Computer Use 是多模态能力的试金石,GLM-5.1 在“理解→行动”这条链路上存在断点,具体分为四层:视觉理解层没有障碍,能准确描述屏幕内容;操作规划层缺失,不知如何把理解转成指令;坐标定位层薄弱,偏差常超过 50px;序列执行层不稳定,多步骤容易中断。
归根结底,这不是简单的适配问题,而是训练目标与训练数据的差异。
两条追赶路径与三阶段时间表
路径一是工程化追赶,属于短期方案。参照 OpenAI 的做法:训练专门的坐标定位模型;集成 Windows UIA 这类平台底层 API;用 API 辅助提升精度。优点是 3-6 个月可能见效;缺点是上限被锁在 OpenAI 同一水平,而且平台依赖较重。
路径二是原生多模态突破,属于长期方案。参照 DeepSeek 的探索:不使用坐标而改用元素选择器;端到端训练“截图→操作意图”;采用跨平台架构。优点是存在弯道超车的可能,且不依赖微软 API;缺点是投入规模大,周期 1-2 年,风险较高。
时间安排上,短期 6 个月做工程化补课,先让 GLM 在 Computer Use 场景中“能用”起来,即使精度仍不如 GPT;中期 1 年强化训练数据,收集“截图→操作”配对样本,训练视觉到动作的映射能力;长期 2 年以上布局语义级多模态架构,若 DeepSeek 路线被验证成立,国产厂商理应考虑跟进。
差距的根因与后续判断
测试者把 GLM-5.1 与 GPT-5.4/5.5 的差距归纳为国产多模态真实水平的一次映射:输入端即“看”的能力已经追上,视觉理解没有问题;输出端即“做”的能力仍存在代差,坐标定位与操作规划偏弱;工程适配确有影响,但不应把差距整体归因于“不是原生适配”。
积极的一面是,差距的根因已经被定位,它来自训练目标与训练数据,而不是架构瓶颈,这意味着存在明确的追赶路径。DeepSeek 的探索提供了另一种可能:多模态不只是“看得准”,还需要“做得对”,不需要像素级坐标,只需语义级理解;若这条路径跑通,或许就是国产多模态实现后发超越的机会。
小结:本次测试显示 GLM-5.1 在 Codex 的 Computer Use 场景总体成功率仅 8%,落后 GPT-5.4 的 76% 与 GPT-5.5 的 90%,短板集中在坐标定位、语义映射与多步规划,桌面图像理解本身并不弱。该差距被归因为训练目标与数据问题而非架构问题,短期可通过工程化与 API 辅助补课,长期则可关注 DeepSeek 所探索的语义级端到端路径是否成立。