谁在放出GLM 5.5的消息
北京时间10月16日上午,Abacus.AI的CEO Bindu Reddy在X平台发布帖文,提到坊间流传GLM 5.5很快就会登场,其写代码的水平有希望逼近前沿模型。需要注意的是她在措辞中用的是“传闻”一词;截至文章核查的时间点,智谱官方更新记录里还没有GLM 5.5的上架条目,具体发布时间与实际成绩仍需等待公布。
这一预期恰好命中了天天用AI写代码的群体的痛点。若国产品牌能把复杂工程做得更稳,开发者在挑选工具时就多了一个真正能承接实际工作的候选。修一个横跨多个文件的缺陷、接手一套完全陌生的代码库、把功能开发完整再让测试跑通——这些才是值得被期待的提升方向。
为什么这次的关注点落在编程能力上
Bindu的判断里有一个值得铺开讨论的关键词:后训练。
她的观点是,此前沉淀下来的用户数据,或许能支撑GLM在强化学习后训练上做得更好。这属于她对升级路线的推测,智谱并未公开GLM 5.5对应的训练细节。
换成更通俗的说法:模型“读”过海量代码,与它能不能把一个项目真正改好,两者之间仍隔着一段距离。
给出一句需求,它可能迅速产出数百行代码。可一旦运行起来,依赖关系对不上;把依赖补齐,原有功能又被弄坏;继续让它修补,它开始绕开测试环节,最后甩出一句“应该可以了”。
真正让人省心的模型,需要读懂反馈信息,定位出错的位置,然后完成一轮修改,同时还要记住最初的目标是什么,不能在反复修补中把需求本身也改没了。
假如GLM 5.5能在这些环节上取得肉眼可见的进步,用户体感到的就会变成:同一件事,终于不必来回盯着改那么多遍。
相比“单次回答写得更长”,这种提升更容易让人愿意更换手中模型。
铺垫工作其实已经发生
这份期待并非纯粹悬空。智谱此前公开过一个相当具体的工程实例。
在9月17日的官方博客中,智谱介绍称,由GLM-5.3驱动的Infra Agent参与搭建并优化了GLM-5.3-Flash的推理基础设施。
按照官方披露的信息,在工程师与Agent的协作之下,系统从首次跑通到具备生产服务条件用时不到两周;端到端吞吐量提升至初始基线的约3倍。
在这套推理系统的优化过程中,值得留意的是它的工作模式:由工程师确定目标、划定边界,Agent则依据测试结果、日志和性能反馈持续修改代码。
这已经十分接近开发者想交出去的那类工作:发现问题、查清原因、动手修改、再次验证。
更贴近眼前的一个案例来自做监控与故障排查的Datadog。
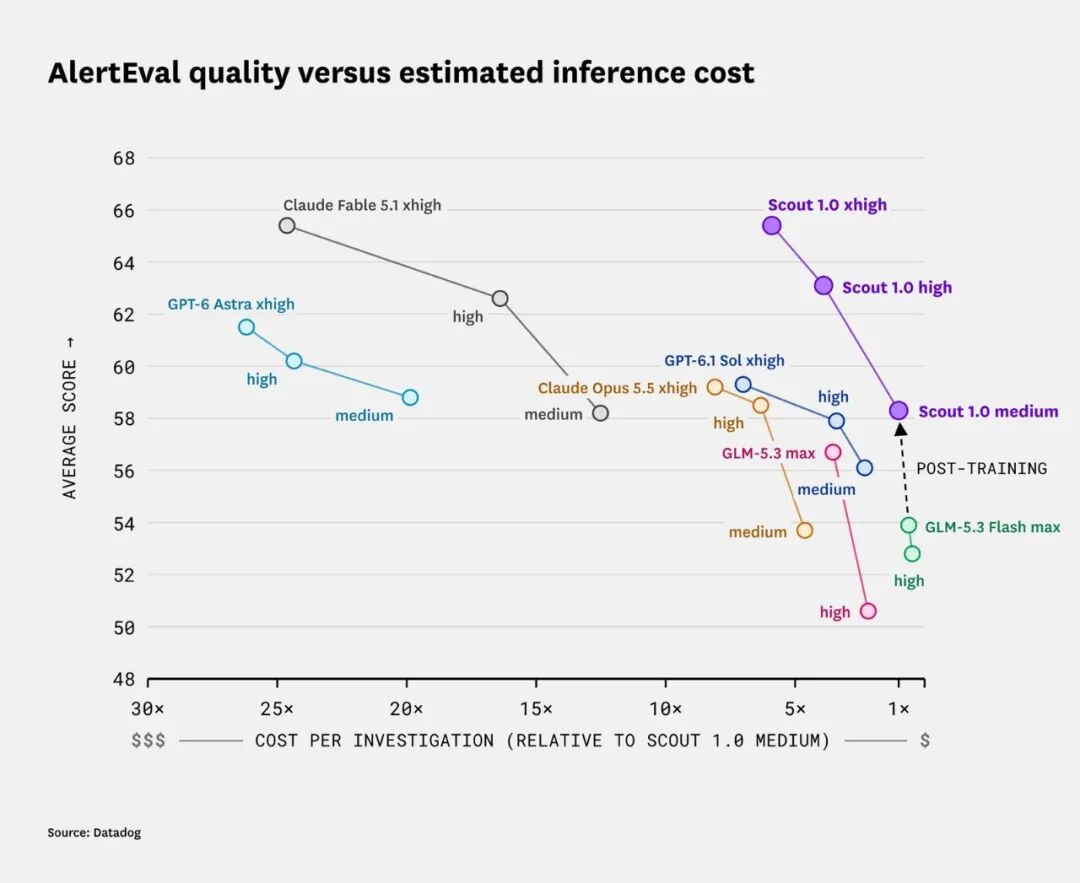
10月15日,Datadog公布了Scout 1.0:该模型以GLM-5.3-Flash为基座,在模拟的故障调查环境中进行强化学习后训练,从而让模型反复练习调用工具、采集证据以及判断根因。
Datadog报告称,在其自有的故障调查评测AlertEval上,Scout的medium档表现可与GPT-6.1 Sol high、Claude Opus 5.5 high相提并论,估算推理成本约为后两者的1/3至1/8。这款专门练过故障排查的模型,目前仍处于封闭预览阶段。
这份官方评测图中,纵轴为故障调查得分,横轴为相对Scout medium的估算成本,越往右侧成本越低。这是针对专用场景的评测,并不代表模型的综合排名。
它让我对后训练的价值有了更具象的认识:把模型放进某一类真实工作的流程之中,提供可被检验的反馈,便有机会把这类的活练得更好。
一个专用模型能够把故障排查练好,那么下一代GLM旗舰是否也能把范围更广的编程任务做好?这正是我想从GLM 5.5身上得到的答案。
Opus 5.5已经领跑,开源一侧亟待有人接招
把视野扩大到整个AI行业,就更容易明白大家为何如此盼望GLM 5.5。
开源阵营确实需要有人站出来。
截至10月16日,Artificial Analysis的综合智能指数中,Opus 5.5已经以58分位居首位。把主要闭源旗舰与开放权重头部摆在一起对比,差距相当直观;该快照选列的均为代表型号,同型号取最高分评测档位,Claude保留榜单默认的fallback设置,分数按页面整数呈现,这一指数综合考察推理、编程和知识工作等能力。
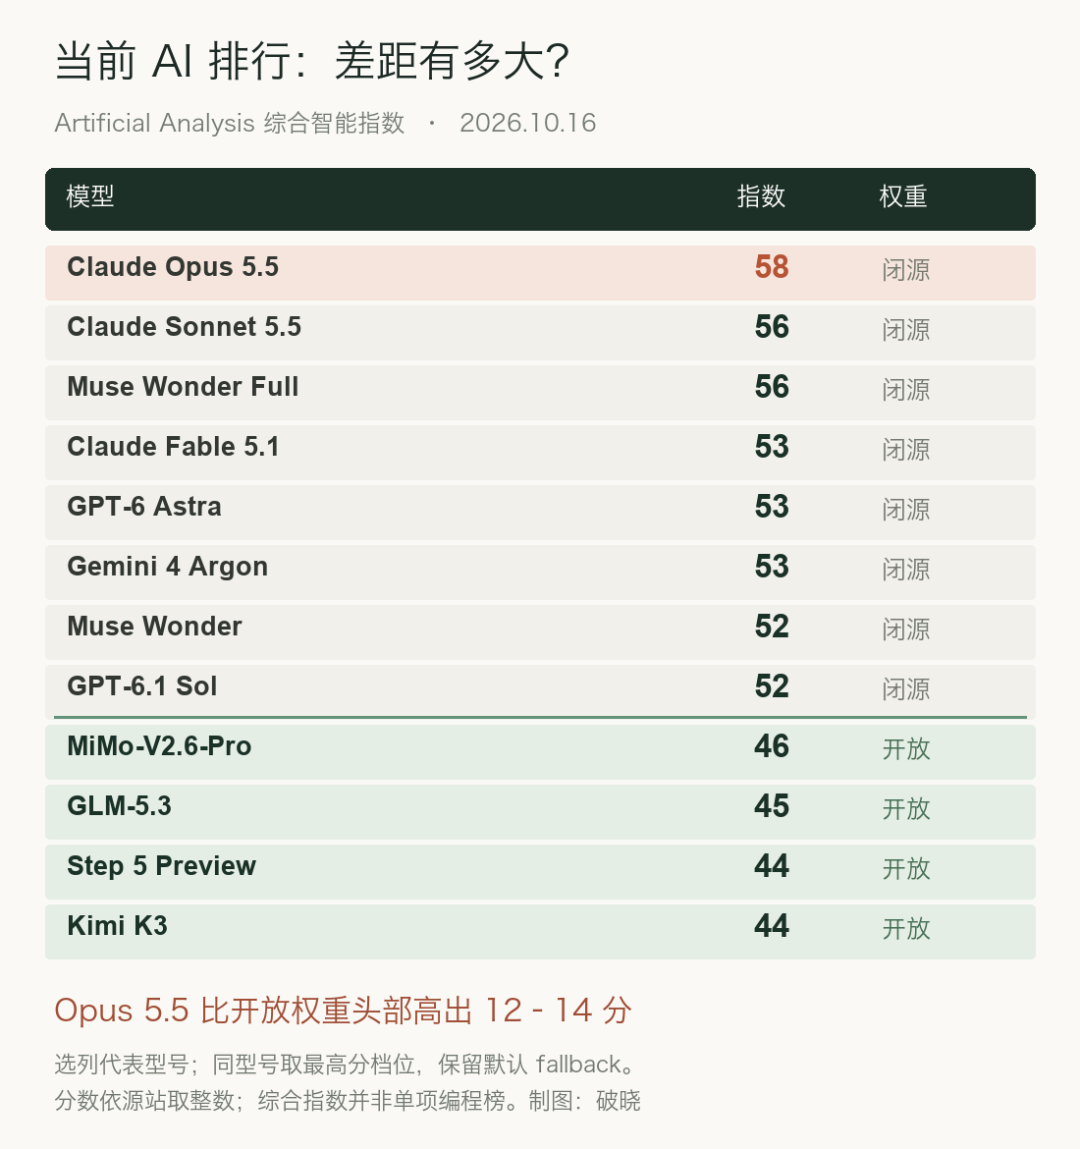
Opus 5.5比开放权重第一名MiMo高出12分,比GLM-5.3高出13分,比Kimi K3高出14分。在这份综合榜单上,Opus 5.5面对开源头部的领先,已呈现出一道明显的断层。
闭源旗舰已经站上52至58分这一档,而开放权重头部还密集分布在44至46分。开源当然仍有价值:企业能围绕自身业务做部署与定制,开发者可以在模型之上继续训练,前文Datadog的案例便是佐证。
可若能力上限始终追赶不上,最复杂的任务就更容易被交到闭源模型手里。时间一长,开发工具优先适配哪一方、团队愿意为谁掏钱、关键工作流围绕谁来搭建,都会受到牵连。
我不愿看到开源模型最后只剩下一个存在的理由:便宜,简单的活可以交给它。
开源同样需要一个让人乐于把难题交出去的旗舰。它所创造的价值,会从模型本体延伸到编程工具、企业应用,以及更多开发者得以参与的后续训练。
这正是GLM 5.5此次传闻最令人期待之处。若它真能把编程能力推至前沿,并延续开放权重路线,整个生态就有机会获得一块更强的底座。
GLM 5.5能不能接住这份期待,还要等正式发布才能见分晓。但开源阵营需要一次有分量的回应,这一点已经非常清楚。
小结:GLM 5.5目前仍停留在Abacus.AI CEO转述的“传闻”层面,智谱官方并无发布记录。但智谱此前的Infra Agent工程实践与Datadog Scout 1.0的成绩,说明基于GLM-5.3系列做工程化与后训练确已见到实效;而Artificial Analysis榜单上Opus 5.5的12至14分领先,正说明开源必须拿出一块更强底座的紧迫性。