国产大模型GLM系列有可能迎来新的旗舰型号。据Abacus.AI首席执行官Bindu Reddy在北京时间10月16日上午在X平台发布的帖子,外界传闻GLM 5.5距离正式发布已经不远,其编码水平被指有机会向现有前沿模型靠拢。她发布这则消息时采用了「传闻」这一措辞,而在本文完成核查的时点,智谱官方更新记录中并未出现该版本的发布条目,因此具体的上线时间和基准成绩仍属未知。对长期依靠AI辅助写代码的人来说,这个消息正好对准了一个高频痛点:如果国产模型有余力应对更复杂的工程任务,那么挑选工具时就真正多出一个能干重活的候选。跨越多个文件的缺陷修复、接手一份此前从未接触过的源码、把一整套功能写完之后再跑通测试,才是这种升级真正需要解决的事情。
为什么这轮关注点落在编程能力
在Bindu Reddy的推演中,有一个词值得单独拿出来讨论,就是后训练。她的看法是,智谱长期沉淀下来的用户使用数据,具备支撑GLM在这一阶段加强强化学习的条件,从而改善模型能力。这一判断只对应于她对技术路径的推测,智谱官方并未披露与GLM 5.5相关的训练方案细节。
换一种更通俗的讲法:一个模型读过大量源码,和它究竟能不能把一个项目改正,其实是两件事。用户递过去一句需求,它可能在很短时间内抛出数百行代码;可一旦真正运行,依赖关系并没有接上;等依赖补齐,原本还能用的功能反而坏了;再让它接着修,它便开始绕开测试环节,到最后丢下一句「应该没问题了」。
要做到让使用者省心,模型必须能读懂运行报错、精准定位故障位置,再进入下一轮修改;与此同时它还得分明最初要实现的目标是什么,不能改到后期把需求本身一起改没了。假如GLM 5.5在这些步骤上有肉眼可见的提升,用户最直接的体感会是:同一项事情不再需要反复盯着它调整。相比单轮回答能写得更长,这种能力更能说服人换用它。
此前的工程伏笔已经埋下
这种期待并非完全没有依据。智谱在9月17日发布的官方博客里,就给出了一个方向相当具体的工程实践。据该博客介绍,团队使用以GLM-5.3为驱动的Infra Agent,直接参与GLM-5.3-Flash推理基础设施的搭建与调优。
按照官方给出的说法,在工程师和Agent协同之下,该系统从第一次跑通一路推进到能够承担生产服务,耗时不超两周;在性能上,端到端吞吐量较之于最初的基线提升到大约3倍。真正值得琢磨的地方在于它的协作方式:由工程师负责确定目标并划定边界,Agent则依据测试结果、日志记录以及性能指标反复改写代码。
这种模式已经非常贴近开发者希望交出去的活——发现故障、弄清原因、动手修改、再做验证。来自监控与故障排查领域的Datadog提供了另一个更近的例子。
10月15日,Datadog正式公布Scout 1.0。这一模型以GLM-5.3-Flash为底材,加入模拟故障调查环节做强化学习后训练,用于练习工具调用、证据收集以及原因判定。Datadog给出的信息显示,在其自有的故障调查评测AlertEval中,Scout中等档位的表现可与GPT-6.1 Sol高档、Claude Opus 5.5高档相提并论,而在耗用成本上估算约为这些对手的三分之一至八分之一。这个专门训练故障场景排查能力的模型,当下依然停留在封闭预览阶段。
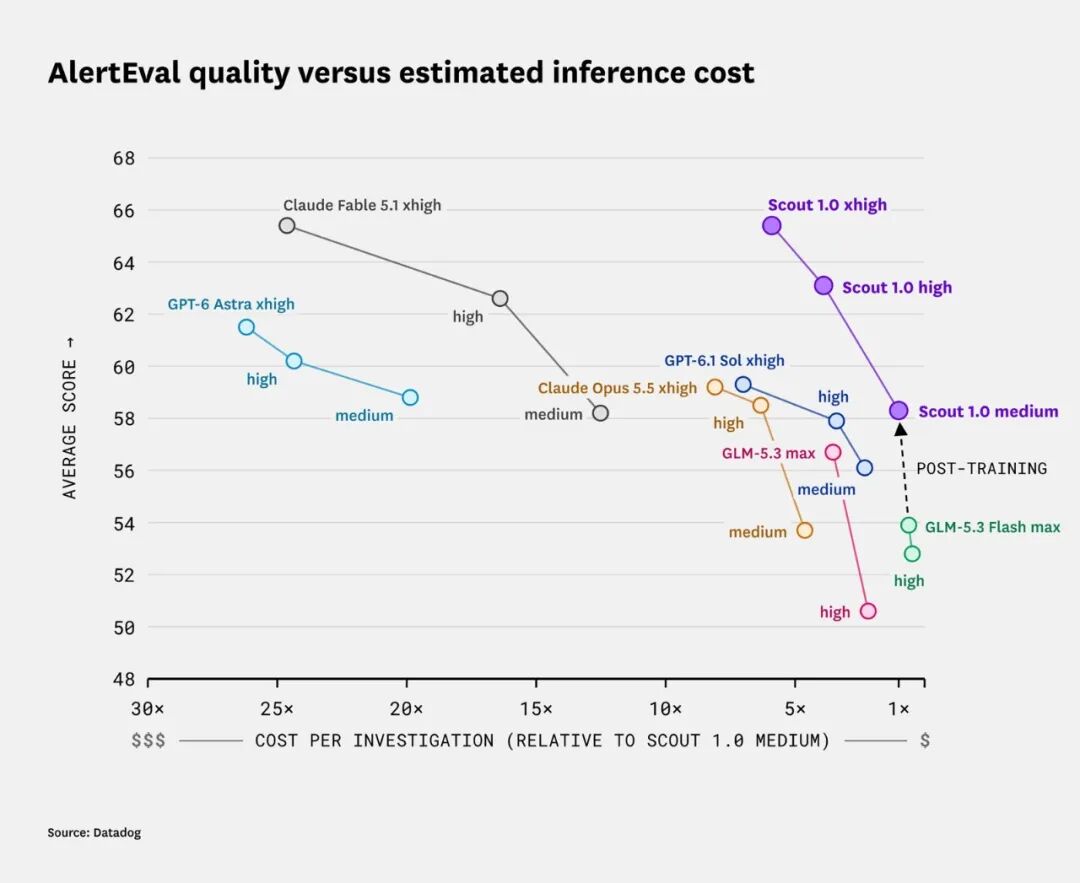
Datadog方面的评测坐标系是:纵轴反映故障调查得分,横轴则是相对于Scout中等档位的成本估算,越靠右意味着越省钱。需要指出,这属于专用场景下的测试成绩,并不能代表模型在综合能力上的排名。这个案例给出了一个更具体的答案:把模型投放进贴近一线工作流的程序中,并向它给出可检验的反馈信号,就存在把这方面任务练得更强的可能。
故障排查这一类别可以由专用模型练好,那么新一代GLM旗舰是否能把覆盖更广的编程任务也练好?这正是许多人期待从GLM 5.5上找到的答案。
Opus 5.5眼下领先,开源梯队缺一个抗旗的
把视角放到整个行业,更容易明白为什么众多开发者紧盯GLM 5.5——开源阵营确实到了需要有人站出来的时候。
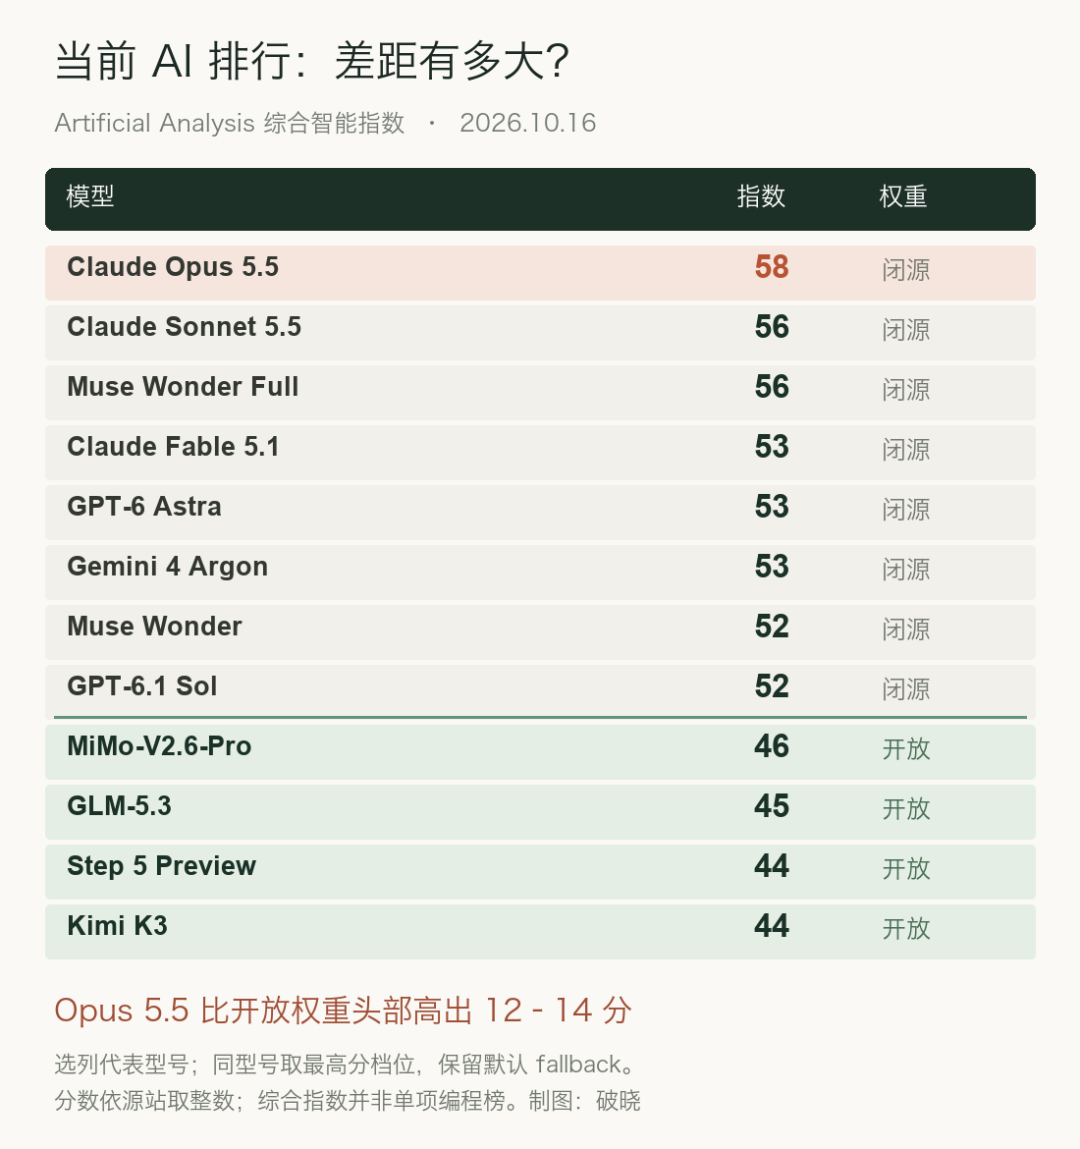
截至10月16日,在Artificial Analysis发布的综合智能指数上,Opus 5.5以58分排在最前列。如果把几大闭源旗舰与开放权重中表现最好的一档并列比较,差距很直观:放开源头部仅落后1名,也不至于到鸿沟那种地步。
开源在成本维度仍具价值但算力上限决定用户去留
在这个榜单中,Opus 5.5和公开权重榜首MiMo相差12分,和GLM-5.3相差13分,同Kimi K3相差14分。换言之,这份综合排名已经把Opus 5.5对开源阵营的领先拆成了明确的分档程度。闭源旗舰的分数区域停留在52至58分档,覆盖开源头部的仍主要集中在44到46分。开源的用处依旧存在:给企业把自己的业务和数据进行部署与定制留出了空间;也给开发者拿模型继续训练留出了机会,前面的Datadog就是实践之一。
不过若是能力上限始终迫不上,最难的那些任务就更容易被拱手送给闭源团队,日积月累下来就會波及开发工具优先适配哪一方、团队乐意付费用谁家、关键用工作流围着谁来攒这一系列选择。多数人不仅希望开源模型把 「便宜」当成最后标签,甚至才让简易的工作交给它处理。但是开源这边也需要一位有能力讓人把复杂难题放心交出的旗舰担当。倘若这一点落地,它的价值会由一个模型本身蔓向用它来写代码、或在企业中使用,以及更多开发人员持续参与后续训练的多个方向。
这也正是本次GLM 5.5这则传闻让人上心之处。一旦它真的把编码能力推到前沿高度,并且延续开放权重的路线,那么整个开发者生态都将收获一个更强的底座支撑。
GLM 5.5能不能接过这份预期最终还得等官方正式上线。对开源这条路线而言,需要拿得出来的一次厚度回应是没法回避的。
小结:GLM 5.5消息目前只是外部「传闻」,官方发布但缺账,发布记录上没有痕迹。但相关支撑线索已经浮现:智谱曾在9月17日的工程博客用GLM-5.3驱动Infra Agent,以不满两周的时间建成并调完开发推理底座提升约3倍;Datadog亦用GLM-5.3-Flash作基础重训Scout 1.0。而在更能体现短板的Artificial Analysis综合榜中,Opus 5.5还在以58分把持顶部,领先开源种个名号少则12分。国開源若真要在编程上补齐距离并在重量级任务中和对手过招,還缺一次真正的产品落地和可追溯的数据。