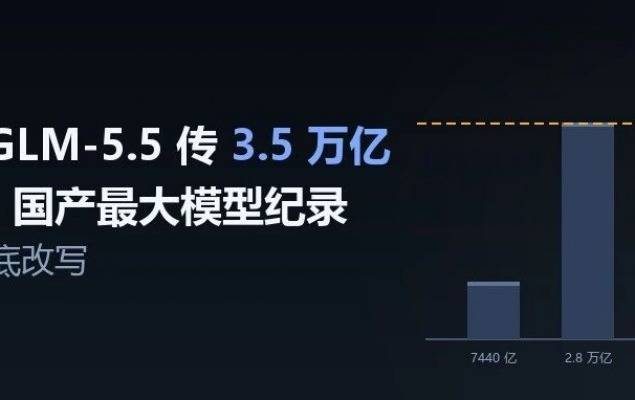
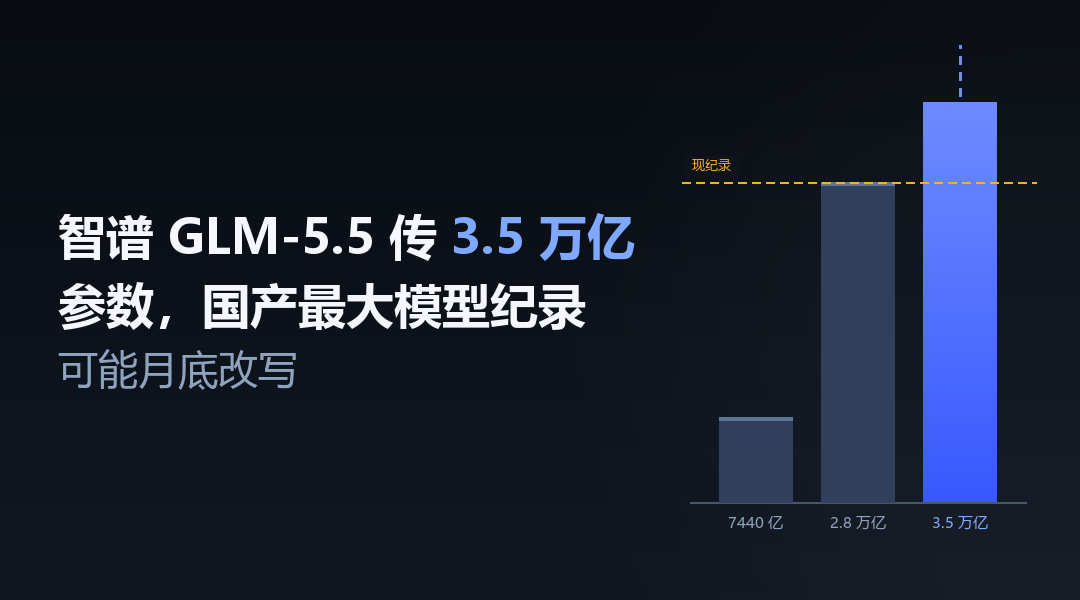
三个数字放一处,结论就显现出来:智谱当前旗舰 GLM-5.3 一共 7440 亿参数,国产开源中体量领先的 Kimi K3 是 2.8 万亿,而传出的下一代目标,是向 3.5 万亿靠拢,若成真,国产模型最大纪录可能在本月底被重置。
这份信息的源头需要先说明:一份标注日期为 10 月 19 日的智谱专家交流纪要,正在投资圈与产业圈流传。智谱官方截至发稿既未确认,也未驳斥。
本文关心的三个问题:传言中的参数到底是多少、进度为何推迟、训练上万亿基座真正卡在哪里。
1.6万亿的版本被纪要首句否掉,真实区间瞄准2.5万亿至3.5万亿
流传半个月的 "1.6 万亿参数版" 首先被排除,纪要开篇就对此作出否认。
其给出的是 2.5 万亿到 3.5 万亿的区间,时间窗口指向 10 月底到 11 月初发布。架构上要一并满足三条:训练速度快、推理速度快、成本压得低。目标写得也直接:上市首日就得撑得住大规模服务,且多家云厂商已经在谈分成方案。
纪要另提到,为支撑这套激进方案,智谱对 infra 团队做了补强。
难度为何高于市场预期?基座训练撞上 "loss 不降"
纪要给出的答案是基座训练前段时间推进不顺,原话表述为训练过程中发生了 loss 不降。
loss 是大模型训练时持续监控的核心指标。它往下走,代表模型正在学习;它不再下降,说明学习停了;更棘手的是走平乃至上扬,那意味着继续投入算力也换不回提升。
参数越往上堆、架构改得越激进、不同加速卡之间的数值精度差异越大,落入这一坑的概率就越高。同一批大模型训练都可能遇到这一现象。
纪要判断这一问题近来应当已被解决,预计很快能完成训练。能力对标定为 Fable 级旗舰,即 Anthropic 在 9 月 1 日发布的 Fable 5.1 所在档位。
参数纪录可能改写,但行业自曝的真正短板在2万亿
整份纪要分量最重的内容并不在 3.5 万亿。
纪要提出的第四个问题直指国内厂商训练上万亿基座的核心难点。回答分两层。前半层称,国内多家公司都在考虑 5 万亿规模的训练,难度会明显放大。
后半层才是关键:现阶段国内可能还没有一家厂商能够完整、稳定地把 2 万亿参数的模型训练完成。这一句把行业级判断置于智谱自家产品规划之前。
随即有补充解释:所谓 "成功完成训练" 与 "把一个模型训完",不是同一件事。
训练失败分几类:其一是 loss spike,数值急剧抬升;其二是 loss 停滞不降,走平或缓慢爬升——这两种尚有挽救空间;其三则是后训练怎样都无法提升,只能推翻重训。
纪要顺带提到一则行业传闻:Kimi K3 的预训练数据没有全部过完,原因可能同样是 loss 不降,于是直接进了后训练。这一段为纪要说法,月之暗面未公开回应。
于是出现一个疑问:若国内尚无厂商能稳妥训完 2 万亿,那 2.8 万亿的 Kimi K3 又从何而来?智谱自己的官方博客提供了另一个观察角度。
7440亿赢下2.8万亿十项:参数量不是能力的唯一变量
8 月 14 日发布的 GLM-5.3,总参数 7440 亿,采用 MoE 架构,单 token 激活约 400 亿。
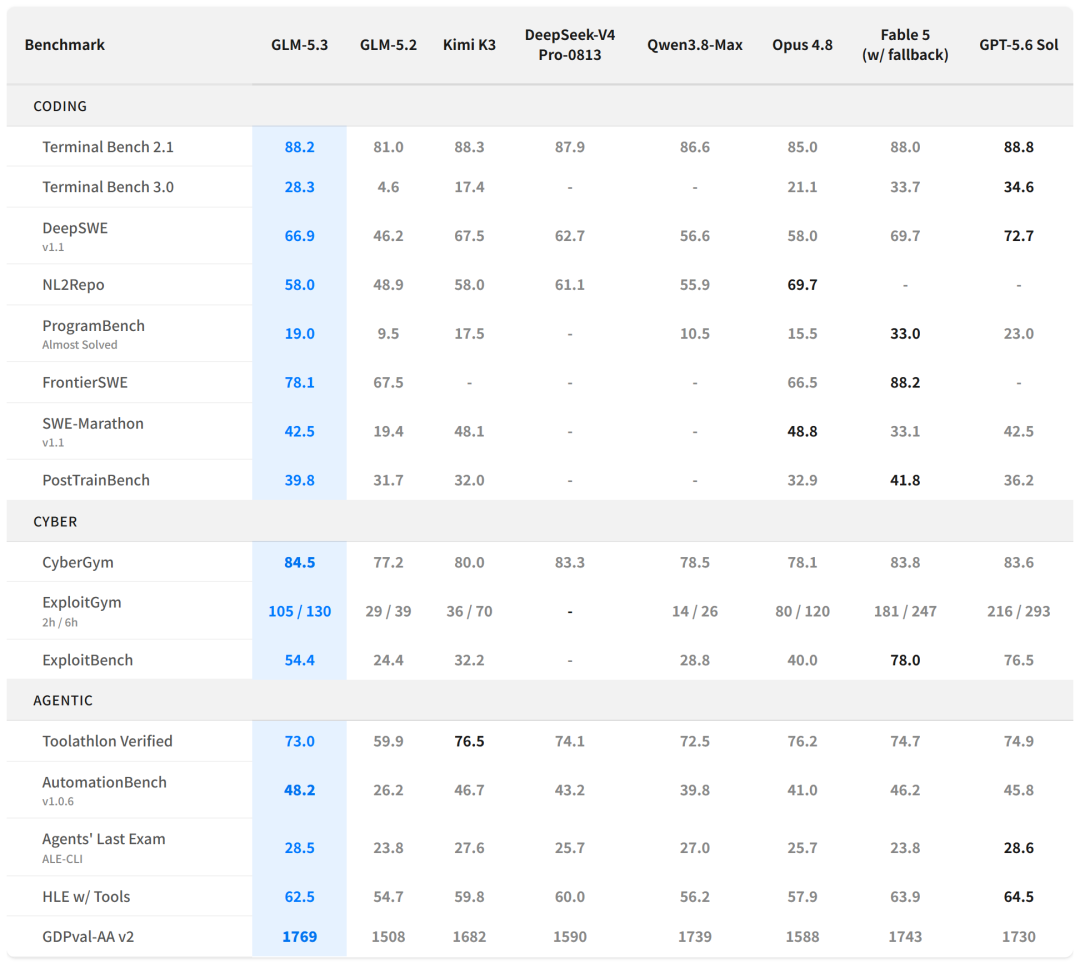
更关键的一点在于,智谱官方基准对比表里同时列有 GLM-5.3 与 Kimi K3,两个模型在同一张表中逐项对标。
十六项基准里,GLM-5.3 拿下十项,Kimi K3 赢四项;NL2Repo 以 58.0 打平,FrontierSWE 则只有 GLM-5.3 有成绩。
编程方向强弱互现:Terminal Bench 3.0 为 28.3 对 17.4,GLM-5.3 明显领先;DeepSWE v1.1 则是 66.9 对 67.5,反倒低了 0.6 分。
网安方向差距更明显:ExploitGym 六小时测试中 GLM-5.3 为 130,Kimi K3 为 70;ExploitBench 则是 54.4 对 32.2。
结论并不直观:参数相差接近四倍,占优的却是体量较小的那一方。这指向第一个反常识点——参数并非能力的唯一决定因素,数据质量、后训练手段、环境设计与推理成本,任一项都能单独扭转排名。
后训练红利见顶,换基座才是3.5万亿的动机
智谱仍要往上跳答案藏在官方博客开头一句话里:"Scaling post-training is all we did for GLM-5.3",意即 GLM-5.3 相对 GLM-5.2 的全部提升都来自后训练。
第二段说得更明确:两者共用同一个基座,每一分进步都出自后训练环节。
后训练的本质,是在已经读过互联网的基座模型之上持续打磨,教会它编写代码、执行长任务、调用工具、按要求格式输出。
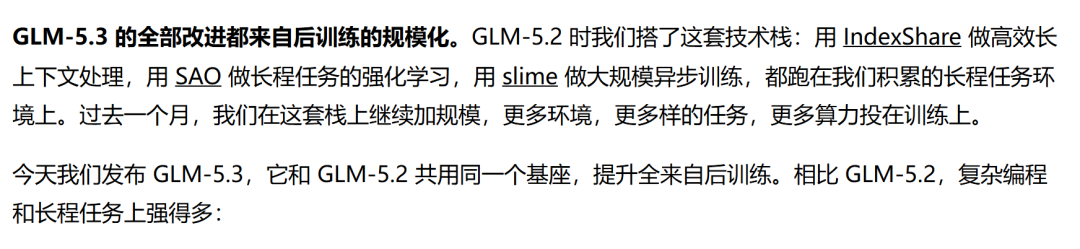
这条路智谱走得够远:Terminal Bench 3.0 从 4.6 升至 28.3,Agents' Last Exam 从 23.8 提至 28.5,全靠后训练实现。
但后训练存在上限——基座中原本没有的能力,后训练也教不出来。
此即 3.5 万亿的由来:并非为刷新数字,而是后训练这条路径的收益接近耗尽。
换基座的成本首先落在结构上。GLM-5.3 共 78 层,其中 75 层为 MoE 层,每层配置 256 个路由专家,七千多亿参数大部分压在这些专家中。
要把总参抬到 3.5 万亿,最省力的做法有三:加专家、加层数、加宽度。三者都要动,也都要付费,且不是分开计,而是一本总账。
加专家最先触发的是通信开销线性攀升。专家分散在不同加速卡上,每个 token 都要跨卡拉取权重;专家数量越多、跨卡频次越高,卡间带宽便成为瓶颈。
纪要里 "既训练得快又推理得快" 的难处恰在此。这也解释了字节要点名 infra 团队补强,以及发布时间为何一再推后。
过去一年智谱确实在底层基建上持续加码。9 月 17 日的官方博客记录了一条案例:由 GLM-5.3 驱动的 Infra Agent,在十万张国产加速卡组成的集群上,从零搭起一套生产级推理服务。
不到两周,端到端吞吐达到初始基线的三倍,唐杰在 X 上写出的数字是 3.2 倍。
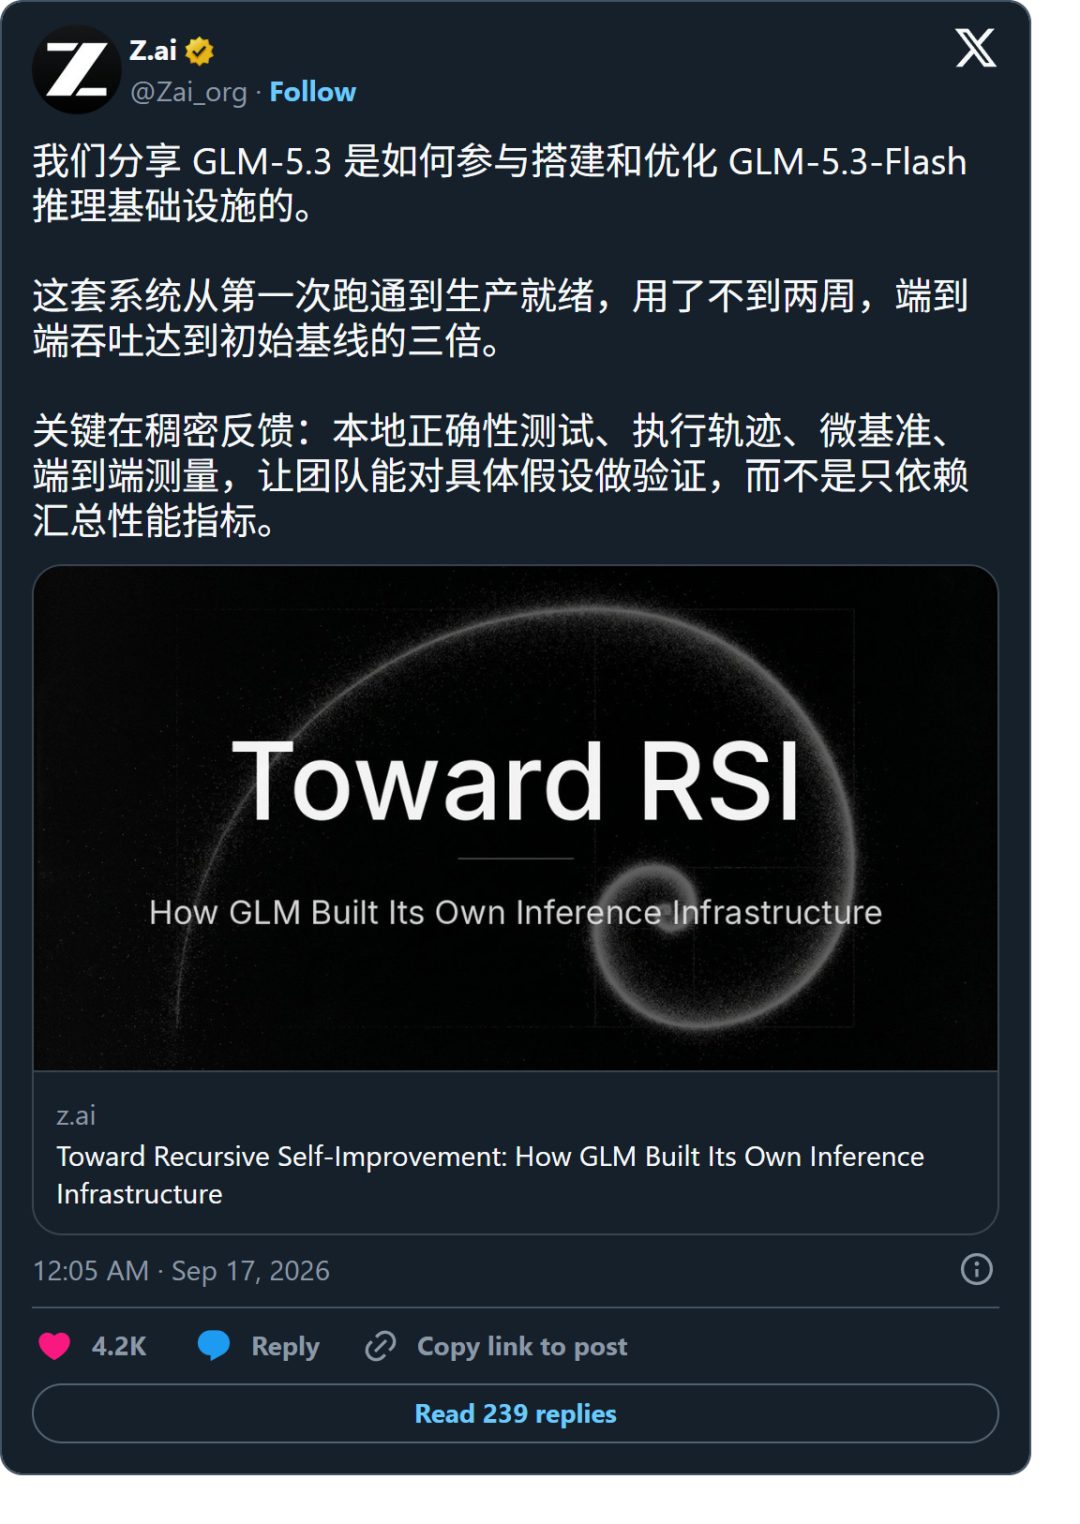
他还有一句更值得细品的话: Agent 卡住时,原因往往不是写不出代码,而是意识不到自己哪里变糟了。
边界也被写清楚:人类仍负责定义目标、搭建反馈环境、审查每一次高风险改动。博客末尾的表述是,距离递归自我改进尚远,但最小的闭环已经成型。
规模怎么定:唐杰列了四个变量,效率那条线也没有放下
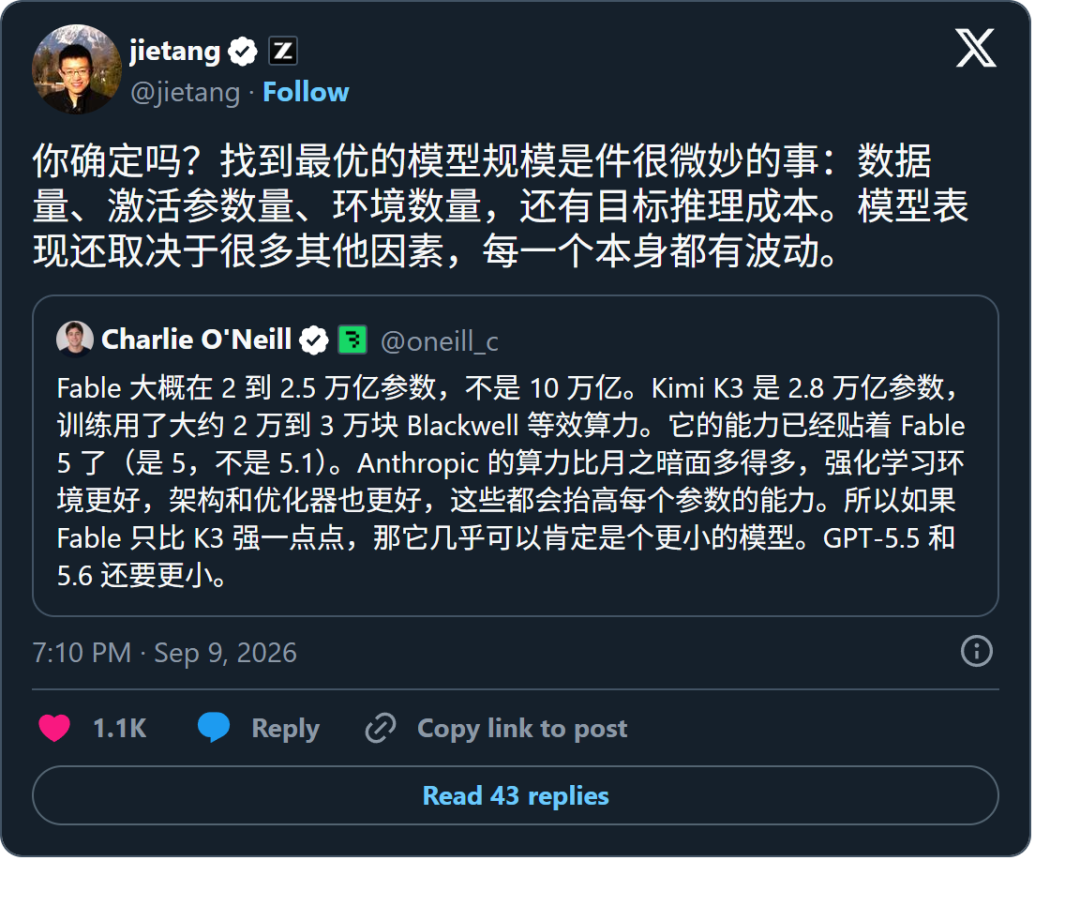
3.5 亿亿落到 3.5 万亿这个区间怎么来的?唐杰 9 月 10 日在 X 上回复过一则帖子。
一位开发者估算 Fable 的规模约为 2 到 2.5 万亿,而非 10 万亿,依据是 Kimi K3 只有 2.8 万亿、能力已贴近 Fable 5,估计后者不会大出多少。
唐杰没有给出具体数值。他的说法是:寻找最优模型规模是一门很微妙的事,需权衡数据量、激活参数量、环境数量以及目标推理成本。
一个月后纪要给出的区间是 2.5 万亿到 3.5 万亿。两种说法并不互斥,合起来恰好说明定规模要看四个变量,总参数只是其中之一。
效率线智谱也没有忽略。8 月 26 日登场的 GLM-5.3-Flash 属于另一条思路,总参 3200 亿,激活仅 180 亿。
官方披露,该模型在 AA 智能指数 v4.1.1 上取得 57 分,折合单任务成本 0.045 美元。达到同等智能水平,过去大约要花十倍成本。
层数同样做了精简:GLM-4.5 系列为 92 层,GLM-5.3-Flash 降到 45 层,总参数相近,激活参数却近乎减半。
可见智谱在选择两条腿并走:一边向上试探 3.5 万亿,一边压低单位激活参数。
财务底盘亦需明面呈现。智谱今年上半年营收 9.54 亿元,同比增长 399.7%,同期亏损 20.71 亿元。
9 月其完成约 50 亿美元融资,用途写明是下一代 GLM 基座和全自训练体系。
商业化已有阶段性起步:GLM-5.3 已上线 Amazon Bedrock 与 Cursor,并登陆阿里云百炼及华为云,按调用量分成。纪要中所说的 "与多家云厂商谈分层",在 GLM-5.3 阶段已演练过一次。
月尾真正值得关注的,并不是那个参数数字。
数字可以印上 PPT,也可写进发布会议题;但训练是否完结、能否实际跑通,只能靠模型自身去交答案。
纪要里最沉的只有六个字—— "成功完成训练",难度超过 3.5 万亿本。
智谱的技术路径也已明确:架构优化压成本、后训练补强推向长任务、基础设施投入撑过训练关口。
小结:智谱下一代跳向 2.5 万亿–3.5 万亿参数,动因不是刷纪录,而是 7440 亿的 GLM-5.3 后训练红利接近见顶;但纪要首肯的行业尚无 2 万亿稳定训练样本,可见国产模型下一阶段的较量在于 "谁能把规模稳跑起来" ,而不只是数字膨胀。