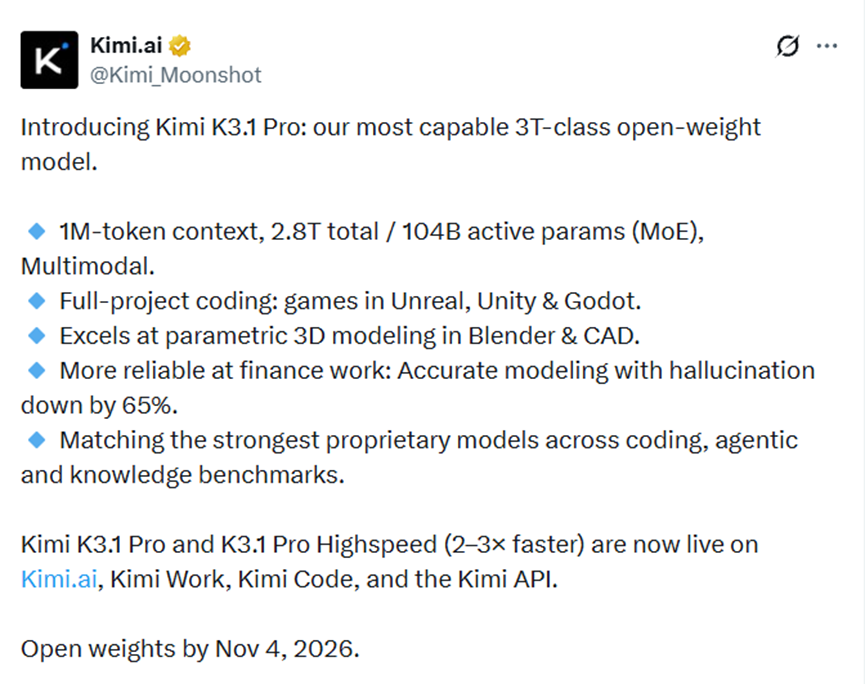
今天凌晨1点,月之暗面正式推出新一代模型Kimi K3.1 Pro。其总参数规模为2.8万亿,推理时激活1040亿参数,上下文窗口达100万token,重点强化了代码编写、3D创作与金融调研三类能力。用户目前可通过Kimi.ai、移动端App、Kimi Work、Kimi Code以及API调用该模型,官方同时确认模型权重会在11月4日之前对外开放。
API入口为:https://platform.kimi.ai/
Arena.ai代码榜1692分:超过Opus 5,成本降七成
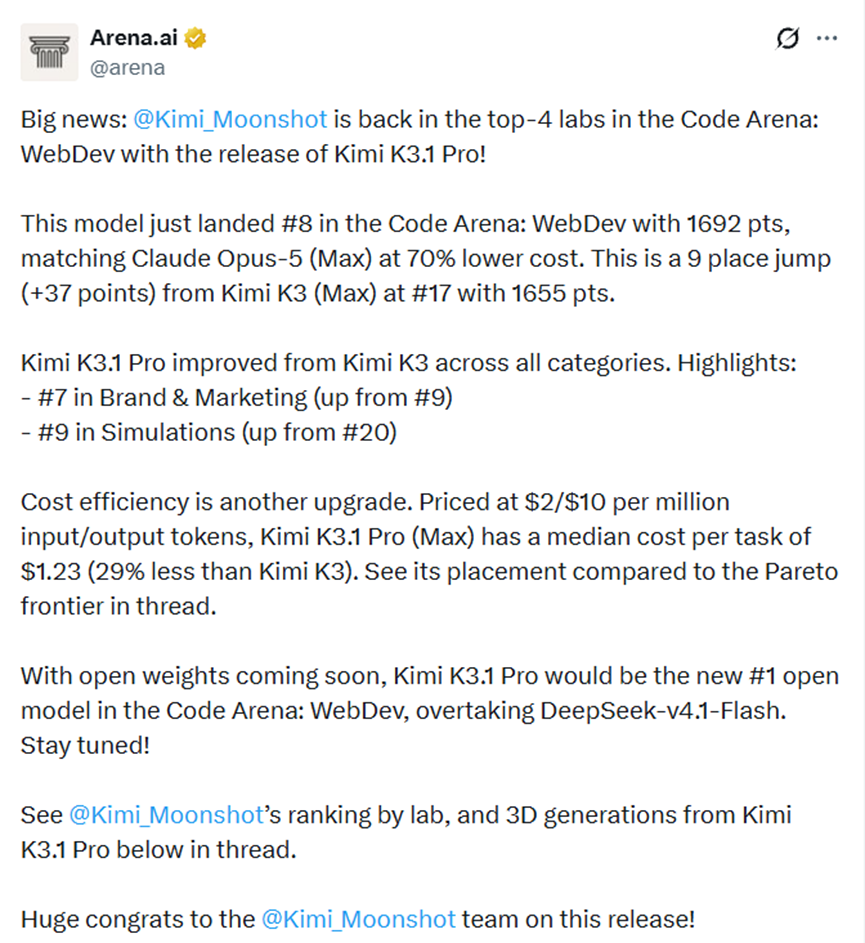
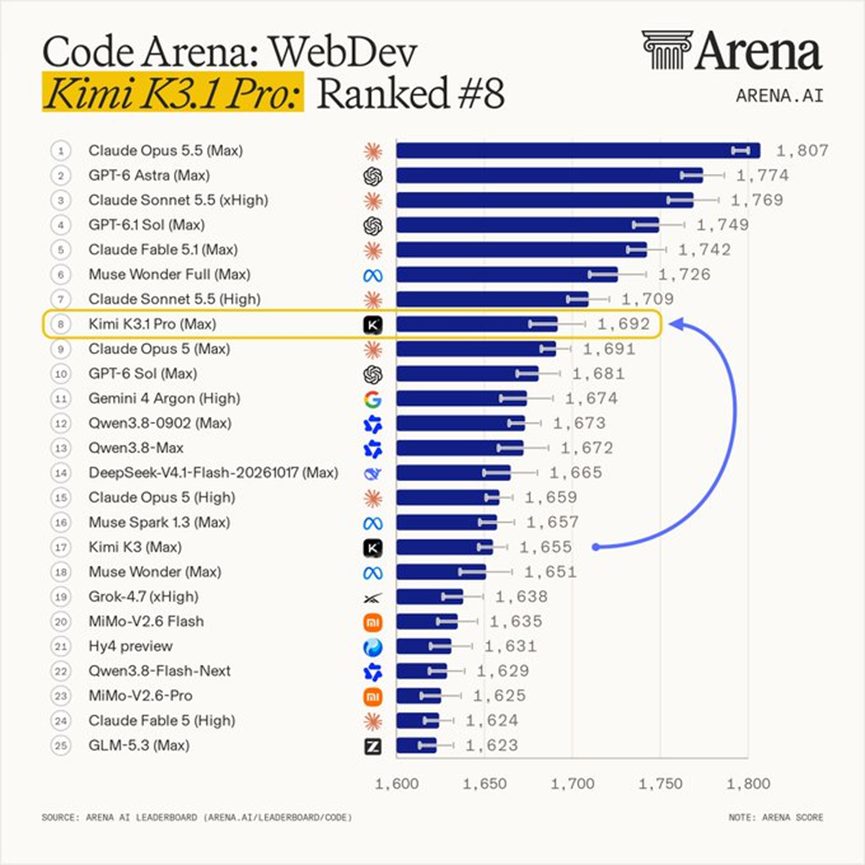
消息公布后很快在海外AI社区引发讨论,并登上热搜。大模型竞技平台Arena.ai同步更新榜单:在代码方向上,Kimi K3.1 Pro取得1692分,高于Claude Opus 5(Max),而调用成本下降70%;该分数同时也高于GPT-6 Sol(Max)的1681分。
榜单其他维度同样出现位次前移:品牌与营销分类由第9名升至第7名,模拟类分类从第20名升到第9名。
价格方面,Kimi K3.1 Pro按每百万输入token 2美元、每百万输出token 10美元计价。官方表示,权重开放后它将成为当前排名第一的开源大模型。
Artificial Analysis智能指数55分列第四,开源第一在望
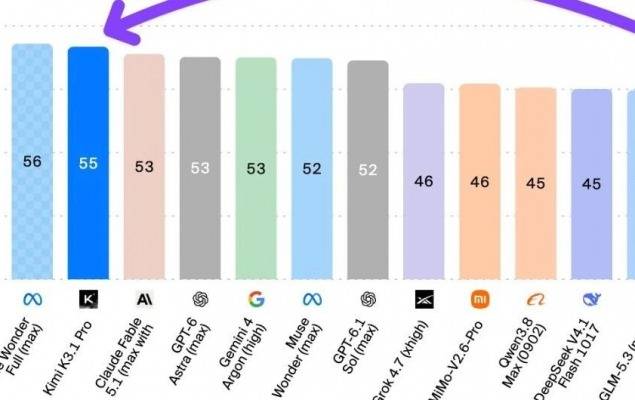
独立模型分析平台Artificial Analysis给出的结果是:Kimi K3.1 Pro在该平台的智能指数上得到55分,排在第4位。排在它前面的分别是Claude Opus 5.5(max含回退,58分)、Claude Sonnet 5.5(max含回退,56分)与Muse Wonder Full(max,56分)。Artificial Analysis同样认定,只要权重开放,K3.1 Pro就会成为最强开源模型。
科技博主chubby评价称,Kimi K3.1 Pro在关键基准测试中的表现与Opus 5.5、GPT-6 Astra持平,部分项目甚至更强。
实际使用案例也印证了成本优势。一位网友用Kimi K3.1 Pro开发3D游戏,耗时10小时、消耗400万token,账单约52美元;若换用GPT-6 Astra或Opus 5.5完成同一任务,开销很容易突破500美元。在单个HTML文件的three.js测试中,K3.1 Pro生成的效果也优于Opus 5.5和GPT-6 Astra。
3D建模是此次提升明显的方向。有用户搭建3D网站,把一只机械手拆解为2317个部件,效果颇为惊艳,完整展示见:https://form-01-score.ok.kimi.link/。游戏开发同样表现突出,有人直接用其做出类《蜘蛛侠2》作品,功能、光影、人流与动作接近原作水平,全程8小时、380万token,费用仅34.72美元。
核心升级:在K3之上做更大规模后训练
K3.1 Pro是在上一代模型K3基础上完成的一次规模更大的后训练。为了让强化学习能够在几百个下游领域联合运行,团队从上到下重整了技术栈:强化学习框架、长上下文推理、训练效率、沙盒基础设施、rollout调度,以及负责环境质量检查的共享平台均被大幅改造,目标是让算力被充分使用、避免空耗——在当下算力成本高企的背景下,这一点尤为关键。
在代码、智能体、知识等基准上,K3.1 Pro的成绩已达到或非常接近顶级闭源专有模型。以Terminal-Bench 4.0为例,该测试专门衡量代码智能体在资源受限的真实终端任务中的表现,题目均为严格的任务专项测试,K3.1 Pro拿到65.7%,高于GPT-6 Astra的58.2%,仅比Claude Opus 5.5的66.4%略低。
月之暗面内部的Kimi Code Bench 3.0 Long-horizon则考察代码智能体跨工程领域多步执行、调用工具、端到端解决问题的能力,K3.1 Pro取得61.2%,相比K3的55.95%提升明显。
在编程任务覆盖面上,K3.1 Pro已能承接从现有代码库快速修bug到从零搭建完整项目的各类工作;在游戏与网页交互作品的视觉审美上也有进步,能够自行选择合适的工具完成开发,前述蜘蛛侠案例即是例证。它还能熟练使用Unity、虚幻引擎、Godot等主流游戏引擎,结合网页搜索与3D生成能力输出完整可运行的作品;前端页面、基于Three.js的交互场景与3D资源,在构图、排版、动画效果和完成度上都较以往明显增强。
一个典型例子是:让K3.1 Pro在开源人体解剖模型human-atlas上搭建行走动力学模拟器,该模型包含296个骨骼组件(含软骨)与402个肌肉组件。在167项任务、420次独立评审中,模型自行分析实验结果、诊断问题并反复打磨行走控制器,把模拟人从几秒即倒地训练到能以交替步态连续行走11.2秒。当奖励塑形怎么调都无法改善手臂动作时,它没有继续微调奖励函数,而是对模拟器动力学做开环探测,最终定位并修正36处肩部肌肉力臂计算错误,再回头重新训练控制器——这种遇到瓶颈先回头核查底层假设的做法,接近有经验的工程师思路。
3D与金融:BenchCAD 92.7%,OfficeQA Pro v2录得64.4
在3D方向,BenchCAD基准考察从多视角渲染图生成CAD代码、重建3D模型的能力,开启工具调用后K3.1 Pro拿到92.7%,已逼近Claude Opus 5.5的96.2%与GPT-6 Astra的95.9%。给定文字描述、草图或参考图,模型可推断物体的形态、比例与空间关系,生成可直接使用的3D模型,对现有素材库和模型合集的理解也更强。参数化建模是其擅长项,可处理机械零件、建筑模型、可配置产品、定制家具等对象,并且无需MCP连接器,模型自己就能编写并运行Blender及各类CAD软件脚本,完成素材搭建、组件修改、几何体与材质调整以及场景布局。此外,3D Make功能已在kimi.ai与Kimi App上线,支持在线预览编辑3D模型,下载后可直接用于3D打印,也能导出视频和实况照片分享。
金融方面,K3.1 Pro能端到端跑完整套工作流,在OfficeQA Pro v2上取得64.4的最先进结果。该基准测试对真实金融文档做复杂财政数据分析,涉及检索、跨文档验证和多步数值推理。Frontier Finance基准覆盖从标的筛选到盈利分析的完整投资流程,K3.1 Pro相较K3同样有提升。月之暗面内部金融基准的进步更明显:金融建模一项评估真实任务中的公式关联、金融逻辑与最终工作表质量,K3.1 Pro比K3高7.2分;金融研究一项考察在证据约束与时间截止约束下产出可溯源报告的能力,提升11.6分;商业运营一项在模拟商业环境中评估长周期管理与决策,K3.1 Pro的性能约为K3的4.2倍。
鉴于金融分析与投资研究对事实准确性要求极高,团队专门针对现实任务和高难度提示词下的事实可靠性做了优化。内部Kimi Hallu Bench Hard基准用于高压测试事实准确性,结果显示:K3的声明级幻觉率为23.4%,K3.1 Pro降至8.3%;出现至少一处事实错误的回复占比仅为前代的42.4%。
AI越强,会用工具的人越值钱
模型能力的跃升也引出另一层讨论:K3.1 Pro这一级别的模型出现后,不少人第一反应是担心被替代。但实际使用后更常见的结论是,AI越强,善于使用工具的人反而越有价值,前提是清楚自己当前处于什么水平。用户可通过AI思维素养测评小程序在数分钟内获得较完整的能力画像,覆盖AI职业画像、AI思维素养与AI替代风险评测;题目难度不低,长期与AI打交道的老手想拿满分也不容易。摸清真实水平,才能判断该往哪个方向补短板。
小结:Kimi K3.1 Pro以2.8万亿总参数、1040亿激活参数和100万上下文,在Arena.ai代码榜以1692分超过Claude Opus 5且成本低70%,Artificial Analysis智能指数55分列第四;权重将在11月4日前开放,届时有望成为最强开源模型。对开发者而言,每百万输入/输出token 2美元/10美元的价格与3D、金融工作流的端到端能力,构成了当前性价比较为突出的一档选择。