同一套基础模型,仅凭后训练环节的改造,能力还能拉高多少?这个问题在智谱的新一代基座模型GLM-5.3上交出了样本。围绕「同一底座、提升源自后训练」这一线索,外部账号另镜Agent对GLM-5.3做了多轮实测,结论是深度思考能力抢眼,细节打磨尚欠火候。
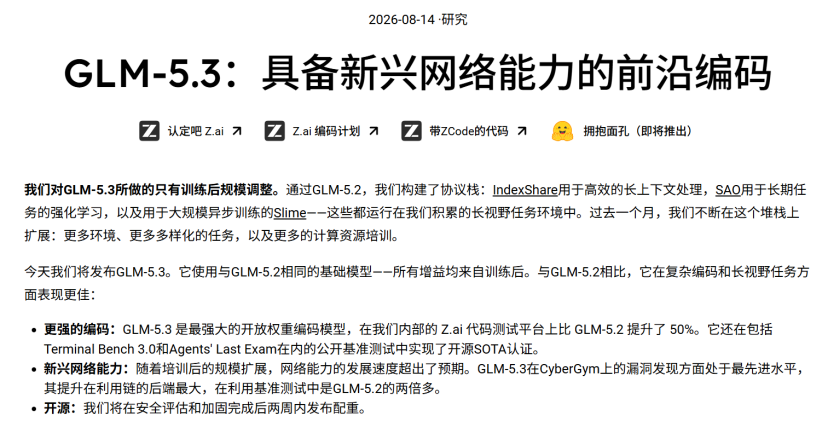
GLM-5.3的时间线与核心改动:沿用GLM-5.2底座,提升全部来自后训练
先看官方口径披露的发布节奏。GLM-5.3于8月14日正式发布,随后在8月19日由智谱上线其Api接口,对外提供调用。与上一版GLM-5.2相比,这次升级有个关键前提:两者共用一个基础模型,参数底座没有换。
在这个前提下,官方对GLM-5.3能力的解释主要集中在两条线:一是编程能力的增强,二是网络安全能力的增强,且这些增强都不是靠重新训练底座得来的,而是后训练环节的产出。文章由此延伸出一个判断:从DeepSeek-V4到GLM-5.3,后训练正在变成大模型能力跃迁的关键撬动点。
实测也顺着这个方向展开,覆盖图形生成、前端动画优化、3D场景创作与全栈项目搭建四个维度,重点观察其代码编写表现。
测试一:SVG画骑自行车的鹈鹕,细节和延伸能力超出预期
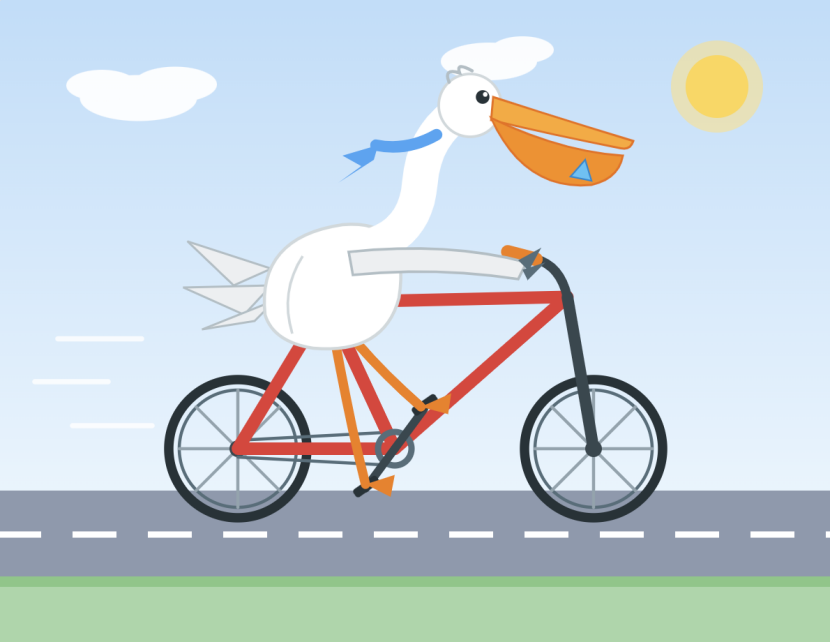
第一个任务是考了多次的老题目——用SVG绘制一只骑自行车的鹈鹕,指向模型对抽象概念的理解与基础编码功底。
结果看,画面整体结构无误。让测试方意外的是,GLM-5.3在既有要求之外自行加了蓝天、白云和金色太阳,还顺带给鹈鹕做了装扮:脖子上围巾朝后方飘,与前行时的风向前后呼应;自行车车把和鹈鹕脖子的弯曲角度衔接自然,观感更接近真实场景。
瑕疵也存在。按照GLM-5.3自己的说明,鹈鹕下颚位置那个三角形本该表现鱼的尾巴,但没有额外解释时,观众很容易把它当成普通装饰,鱼的尾巴这一形象几乎识别不出来。据此文章给出的判断是,深度思考层面它表现出色,细节精细度则还有改进余地。
测试二:改造网页入场动画,用纯合成器方案绕开重排
前端工程方向的题来自GitHub上的专项测试集,出题者是开源社区开发者庄表伟(zhuangbiaowei)。任务相对具体:优化网页的入场动画。
原动画的问题在于是滚动之后才触发播放,而且播放过程中会出现卡顿。改造之后的版本则以加载为起点自动播放入场动画,过程顺滑了不少。
测试方把生成代码逐项翻看,定位到GLM-5.3采用的思路是把所有会导致layout的写法一口气替换成纯合成器动画。结论是,面对这类常见前端需求,它能给出正确交付;文章也提醒,长周期、复杂系统的持续作战能力还没有被检验。
测试三:用Three.js还原《琵琶行》,十分钟生成的意境与精度落差
第三项任务要求更高:结合《琵琶行》的词句内容,借助Three.js为该词作制作3D动画。这道题既考查对古诗词的理解,又要求把理解落到代码和抽象要素的整合上。
整个生成过程大约花了10分钟。GLM-5.3挑出《琵琶行》里颇具代表性的句段来驱动画面,把「千呼万唤始出来」里琵琶女现身的过程交代得比较到位,也把「银瓶乍破水浆迸,铁骑突出刀枪鸣」这类激烈场面做出了戏剧感。音效部分用的是Karplus-Strong物理建模合成的琵琶音色,听起来自然,与琵琶的实际发声特征对得上,并且能跟着诗句内容变化。
速度之外问题同样明显。画面上,湖面被简化成简单蓝白格块,整幅图像层次比较单薄;人物造型偏生硬,看上去像是由若干规则图形拼合而成,缺少真正的人体特征。文章据此点出,GLM-5.3在追求生成速度时,细节层面的打磨有一定损失。
测试四:从零搭博客,自检能力强但首轮输出准确性不足
最后一项是从零开始搭建一个博客平台,基础写作、增删文章等功能要有。该任务耗时约12.5分钟。生成结果里,首页保持简洁,以白色主色调为主,左上角只有简单的「Blog」标识。
要验证后续功能,先得完成云端部署。部署阶段冒出过失败情形,不过依靠GLM-5.2的自检机制,问题被修好了。本地部署环节耗时约40分钟。部署完成后,admin可以正常新增和删除文章,注册用户也能查看内容,基本功能齐备。
部署途中,GLM-5.3自行检测出若干故障并完成修复,这就是它在代码自检方面表现的来源;处理复杂任务时也显示出较强实力。不足之处落在一次性成形能力上:模型没有在生成环节第一时间揪出上述毛病,而是等到部署时才动手解决,说明首轮回答的准确度还应继续提升。
四个维度汇总:理解与生成够硬,单次正确率与精细度仍待补齐
把四项实测放在一起看,GLM-5.3在代码理解和生成上确实有硬功夫。SVG那边它会主动补背景,显示对指令之外的延展理解;动画那边能准确锁定layout这个瓶颈,再把触发重排的语句换掉;3D任务中对词作意境的还原与声音合成都可圈可点;全栈任务里从零做到可用的博客系统,并能自行体检查错。
短板同样清晰:一是细处打磨,例如鱼尾巴辨识度不足、画面精细程度被压缩;二是「一口气交付」的能力,先出错的代码在部署前没被拦住。合起来的结论是,GLM-5.3的深度思考较为突出,而单次转换是否精准与各处细节是否漂亮,都有优化空间。
回过头看,GLM-5.3没有换底座,提升完全交给了后训练,这同样在提示:后训练已是模型能力跨越的重要杠杆。
小结:GLM-5.3以GLM-5.2同一基座为基础,靠后训练撑起编程与安全两条能力线的抬升。四个实测场景证明其在代码理解、问题定位和自检修复上已有基础,但一次性输出准确率和对细节质量的把控仍需迭代。