10月26日这天,AI行业出现两个方向相反的动作:Anthropic向美国证券交易委员会提交了IPO注册文件;OpenAI则推出新模型GPT-6.1 Terra,把标准API价格直接下调一半。一边谋求上市,一边主动降价,构成了当天最值得注意的对照。
四款GPT模型如何分工,Terra卡在哪个价位
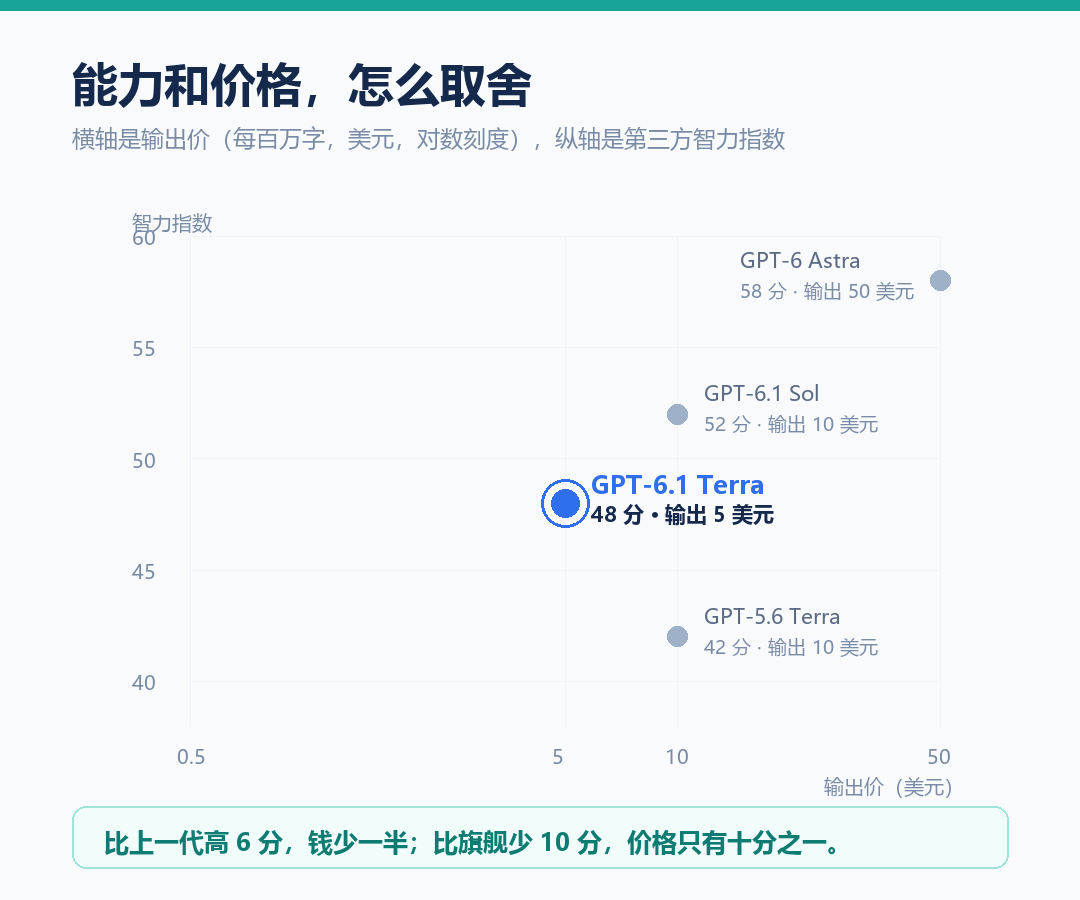
按照OpenAI给出的产品线,当前四款模型各有位置:GPT-6 Astra负责最难的任务,能力最强;GPT-6.1 Sol能力接近Astra,价格约为其五分之一;GPT-6.1 Terra处于中间档;GPT-6 Luna则面向更轻量的场景。价格均以每百万字、美元计。
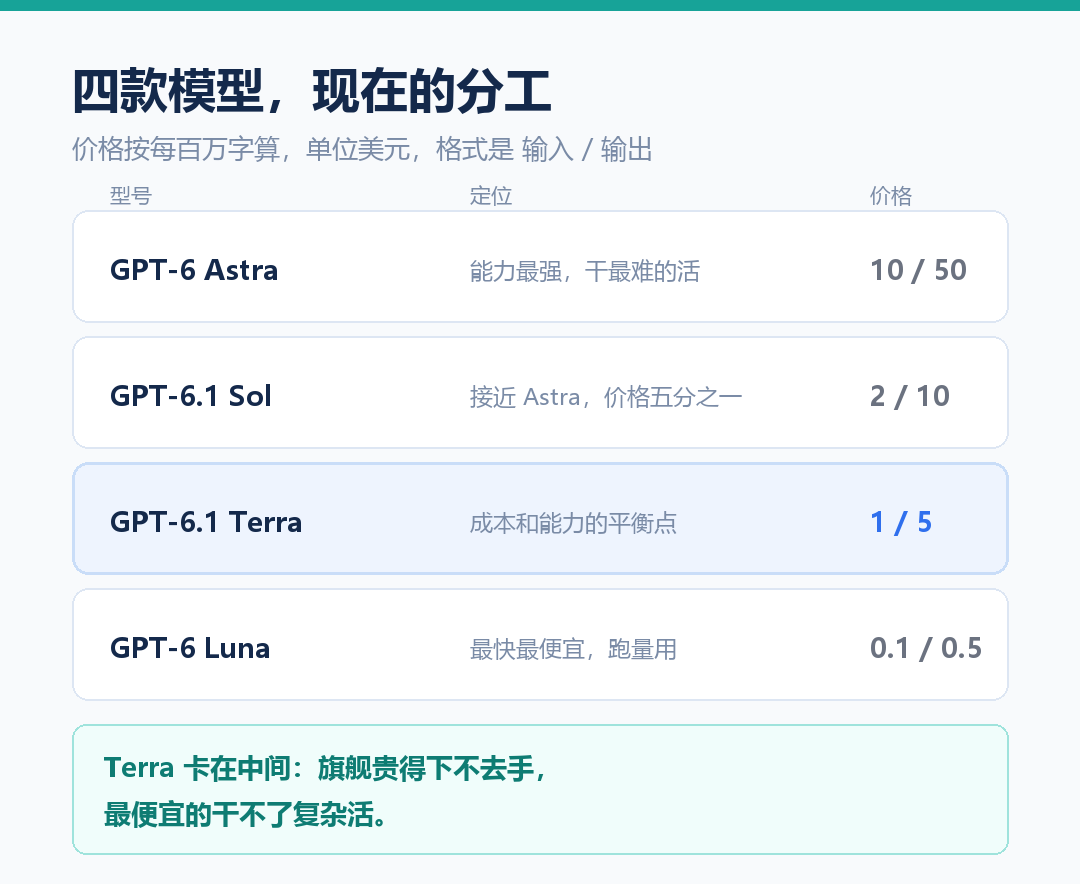
Terra的具体定价为:输入1美元、输出5美元、缓存输入0.05美元。与上一代GPT-5.6 Terra相比下降50%,与旗舰Astra相比仅为后者的十分之一。这个档位的特点是:Astra价格过高难以大规模调用,Luna又无法承担复杂工作,Terra正好补上两者之间的空白。
Terra要做的活:读懂屏幕、跨软件动手
OpenAI对Terra的定位很明确——识别屏幕上显示的内容,并跨越不同软件去执行操作。官方列举的典型任务包括:读取收到的发票并将信息录入财务系统;理解技术图纸并转换为三维模型;对动画电影逐镜头审查,为修复团队输出带时间点的记录;以及填写网页表单、编辑视频等。
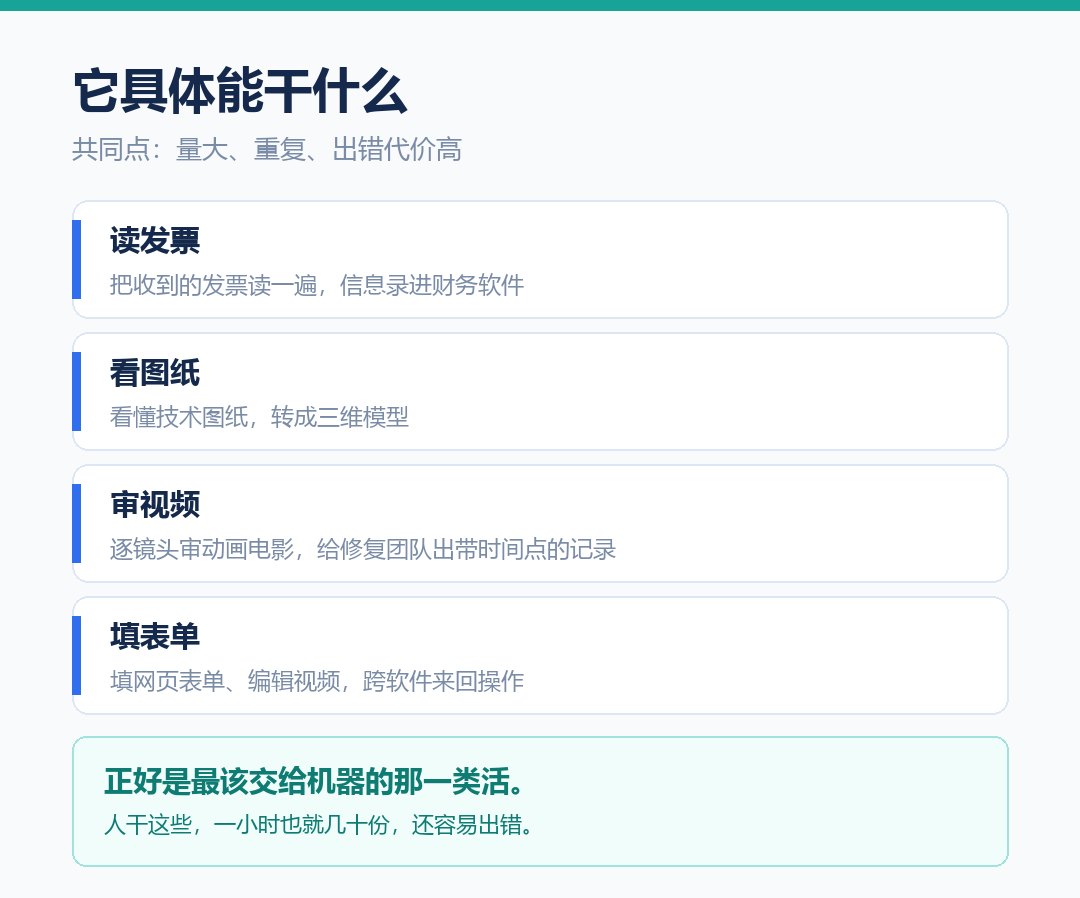
这些任务的共性是数量大、重复度高、出错代价高,恰好属于最适合交给机器处理的一类。OpenAI表示,在ChatGPT Work和Codex中,同样的使用额度下,Terra能完成的工作量高于上一代,也高于Sol和Astra。
五项测试成绩均在提升,但数据来自OpenAI自测
需要说明的是,以下结果均来自OpenAI内部测试,没有第三方独立复现。
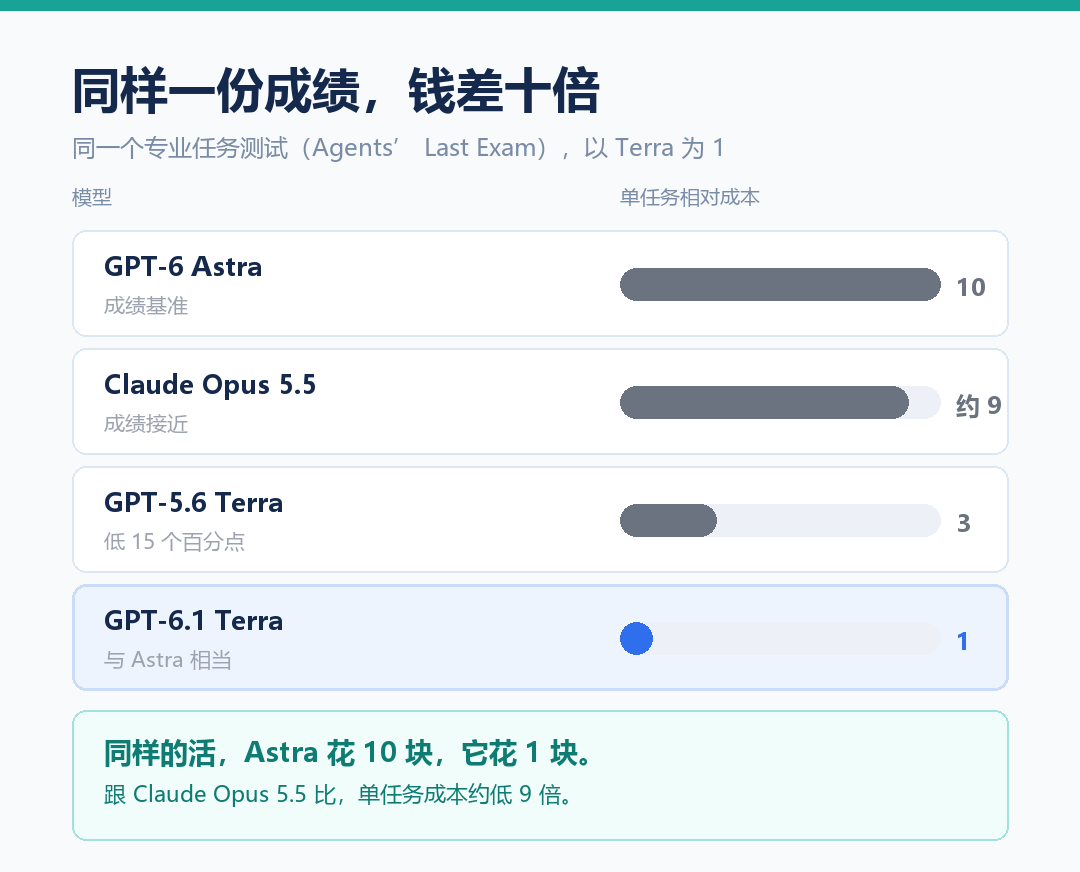
在考察AI是否会用办公软件的Agents' Last Exam中,中等推理强度下Terra比上一代高出15个百分点,成本约为上一代的三分之一;这一成绩已与旗舰Astra相当,而单位价格只有Astra的十分之一。最高推理强度下,其效率达到Claude Opus 5.5的三倍以上,单任务花费约为后者的九分之一。速度方面,完成测试任务比Astra和Sol快三倍以上。
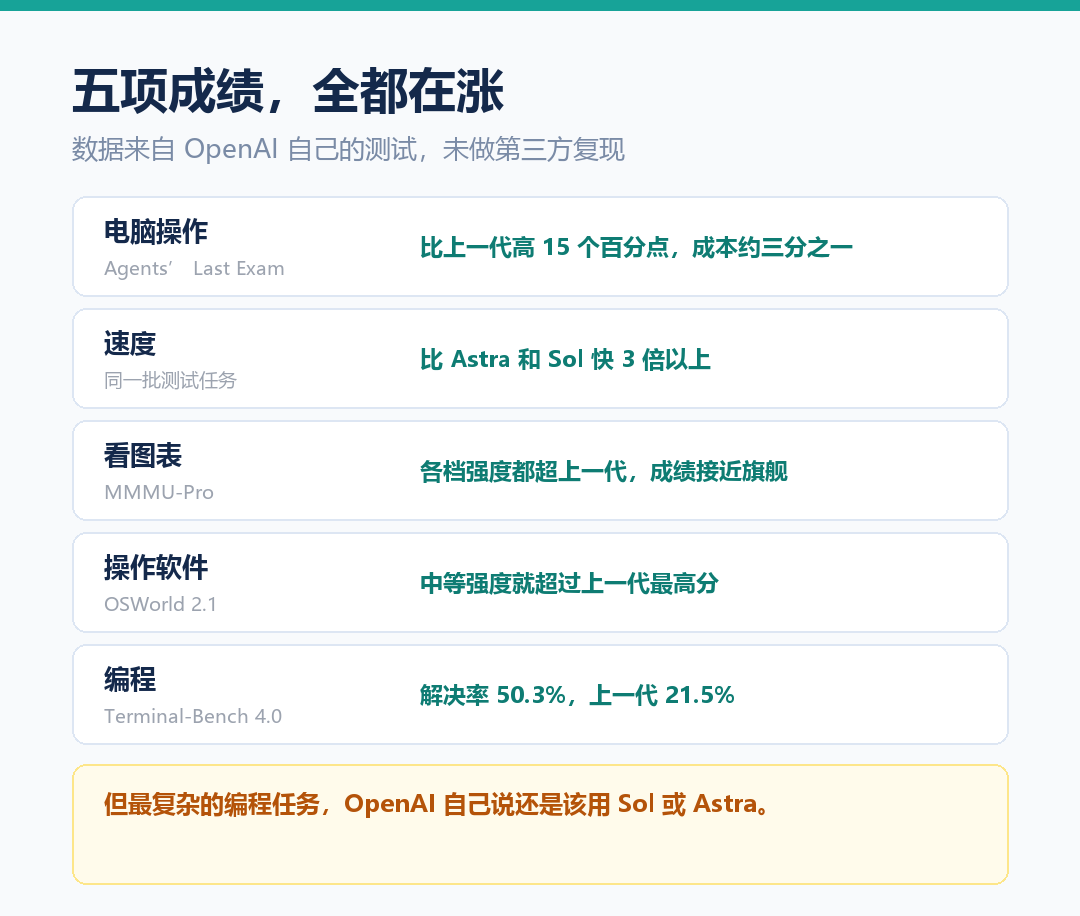
看图表的MMMU-Pro测试中,各档推理强度均超过上一代,成绩接近Astra和Sol,同时成本低得多。桌面软件操作测试OSWorld 2.1中,中等强度就已超过上一代最高强度的表现。编程测试Terminal-Bench 4.0的任务解决率为50.3%,上一代为21.5%,提升超过一倍。第三方机构Artificial Analysis给出的智力指数为48分,比上一代提高6分,接近Sol的52分。
不过OpenAI也坦言:最复杂的编程任务,仍然应当交给Sol或Astra。把能力与价格放在同一坐标系里看,各模型的定位差异会更清楚;换算成实际开销,同一个专业任务、成绩相当的模型之间,花费可能相差十倍。
事实错误率大幅下降,这才是企业敢用它的关键
相比跑分,可靠性更像是分水岭。OpenAI内部设计了一组专门诱发错误的提示词进行测试:低推理强度下,事实错误率由53.6%降至16.7%;最高推理强度下下降18个百分点,来到4.3%,接近旗舰水平。53.6%意味着上一代在被刻意刁难时,超过一半的回答含有错误。
对企业而言,这直接决定任务能否外包给模型。以录入发票为例,金额错一位,省下的时间就全部赔进去。安全层面,OpenAI依据自身风险框架将Terra的网络安全能力评为「严重」级别,生化能力评为「高」,防护措施沿用Astra的方案;同时,它对试图使其偏离任务的恶意指令的抵抗能力也强于上一代。
降价50%背后的三重原因
首先是开源模型持续压价。近两年中国开源模型把推理价格拉得很低,闭源模型若不跟进,调用量就会流失,此次下调50%幅度并不算小。其次是电脑操作类任务本身要求低价才能跑起来——让AI填一张表收一毛钱已属昂贵,企业需要的是「一张表一分钱」的价位,才谈得上批量使用。第三是Anthropic在同一天交表:谋求上市的一方需要向投资人讲增长故事,而把价格砍半的一方则在讲另一个故事——未来的赢家是把成本压到最低的那一个。
奥特曼为这次发布定下的调子是「开启计算机使用时代」。这一说法略显夸张,但方向并无偏差:模型从陪人聊天走向替人操作软件,中间横着的门槛一直是成本与可靠性,而Terra在两端都做了推动。
小结:GPT-6.1 Terra以旗舰十分之一的价格、接近旗舰的电脑操作与图表理解成绩,加上事实错误率从53.6%降至16.7%的可靠性改善,把「AI替人操作软件」从演示推向可批量调用。但其成绩均为OpenAI自测,复杂编程仍需Sol或Astra,实际落地效果有待第三方复现验证。