两台H3C MegaCube摆在一起,配合一套NVFP4量化的GLM-5.3-Flash,究竟能承担多重的本任务?这轮实验围绕输出速率、并发表现、超长输入以及接口行为,整理出9份测试报告与67次请求的原始记录,同时附上两个可直接打开的前端HTML作品。结论里既有可以参考的数值,也有带着疑问、需要复测的环节。
双机部署:TP=2跨机承载一份权重
硬件主体是两台MegCube级别的设备,各配GB10计算单元与128GB统一内存。软件侧选用社区维护、面向GB10 / SM121架构的vLLM镜像,张量并行设为TP=2:主节点对外暴露与OpenAI兼容的接口,从节点只参与模型运算,不单独服务请求。
模型权重取自nvidia/GLM-5.3-Flash-NVFP4。为提升出字效率,部署时叠加DFlash2辅助模型执行推测解码,先由小模型以低成本快速预测接下来的token,再交回主模型判断取舍。
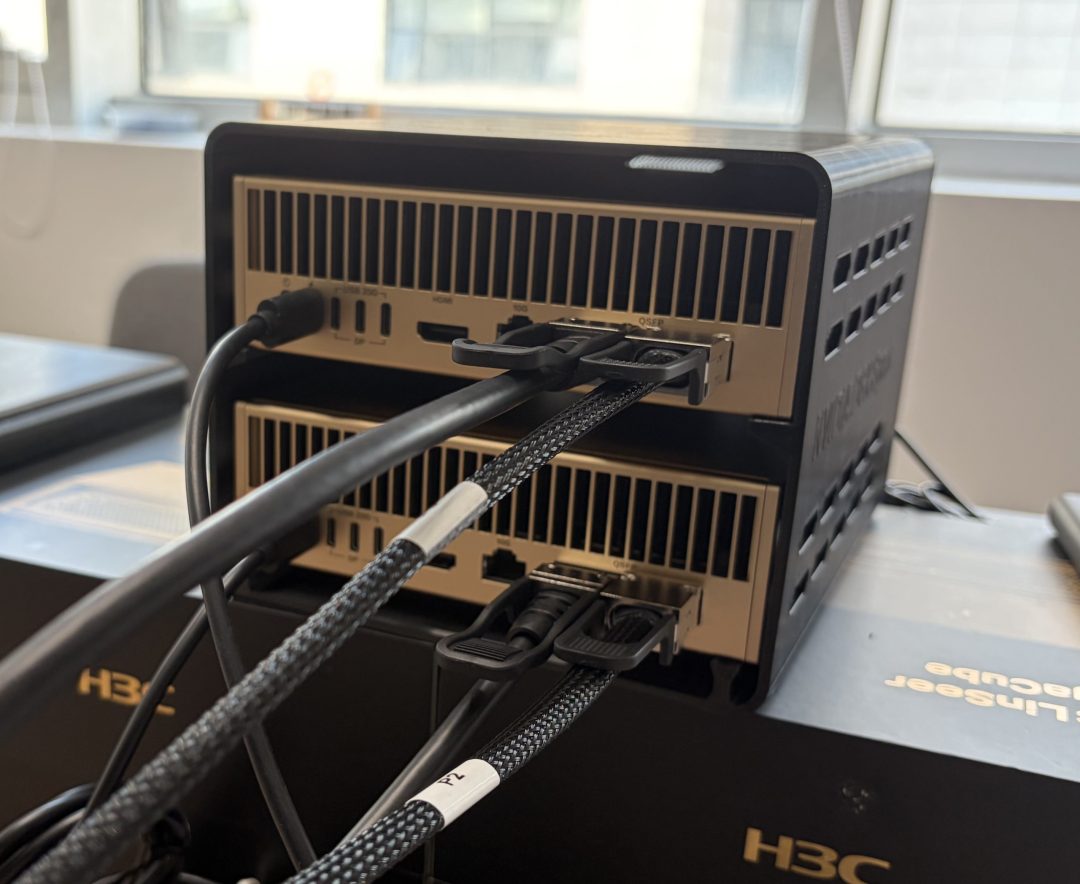
镜像与权重文件只需获取一次,其余通过rsync推送到第二台设备。两台机器之间使用一条QSFP高速链路互联,启动前逐项核对IP地址、网卡命名、RDMA设备与GID。两边都保留完整权重,由推理框架切分计算任务。上下文上限在配置过程中由32K调到256K,但测试报告没有留存完整的运行参数快照,因此文中只把它视为参数上限,不当作已经过验证的实际容量。
输出速率:场景不同,数据落在17~29 tokens/s
按报告统计,中文短说明类 задачи的平均端到端速度约17.1 tokens/s;带来固定对话历史的请求约为19.5 tokens/s;单并发排序任务则因整批合计输出,吞吐达到29.3 tokens/s。后一项共发起8次请求,8次全部成功,平均单次请求耗时16.74秒。
需要强调的是,上述数字的统计方式是“输出token数除以请求总耗时”或整批吞吐,其中已包含预填充、等待与网络传输的时间开销,不能与纯解码阶段的速率直接画等号。任务类型、回答长度、草稿命中比例都会令结果浮动,因此这些值更适合作为特定场景下的现场记录,而非覆盖所有使用情形的一个代表性峰值。
并发测试:请求翻倍,吞吐却停在29 tokens/s
当并发数由1升到4,整体吞吐并未随之上升,仍维持在大约29 tokens/s,先后测得29.3、27.7、29.5 tokens/s三组数据,而平均请求耗时则拉长到53秒。前四个请求各自的用时约为17、34、50、66秒,总体上呈现清晰的排队效应,説明当前调度配置并未真正让多路请求并行计算。
测试工具自身的问题:7次失败多数不算模型失手
9份报告合计记录67次请求,工具判定60次成功、7次失败。拆开看,其中6次来自流式输出用例,另外1次对应一条刻意传入负数输出长度的异常输入。
回看代码后确认,测量流程本身存在缺陷:流式采用的方式在读到结束标记后没有跳出外层读取循环,代理连接在收尾阶段还可能挂起。实际内容虽已返回,请求却会一直卡到120秒超时。这类失败的根因在被测环节之外,须先修好测试工具再跑一轮,不能直接记作模型生成错误,也就否定了模型的全部出错。
长文本摘要任务共提交5次,全部走完流程,输入规模大的一例约2.5万个字符。不过报告中的输入token值是估算得来的,并非精确tokenizer统计,所以现阶段的证据还撑不起“256K上下文可用”这一判断。基础API的接口检查5次全过,平均开销约472毫秒;固定对话历史的用例10次全部通过。工具调用全链路、图像理解、会话持续增长以及长期稳定性,则各自需要专项实验来补。
两个前端控件作品:除了压测,也看落地代码
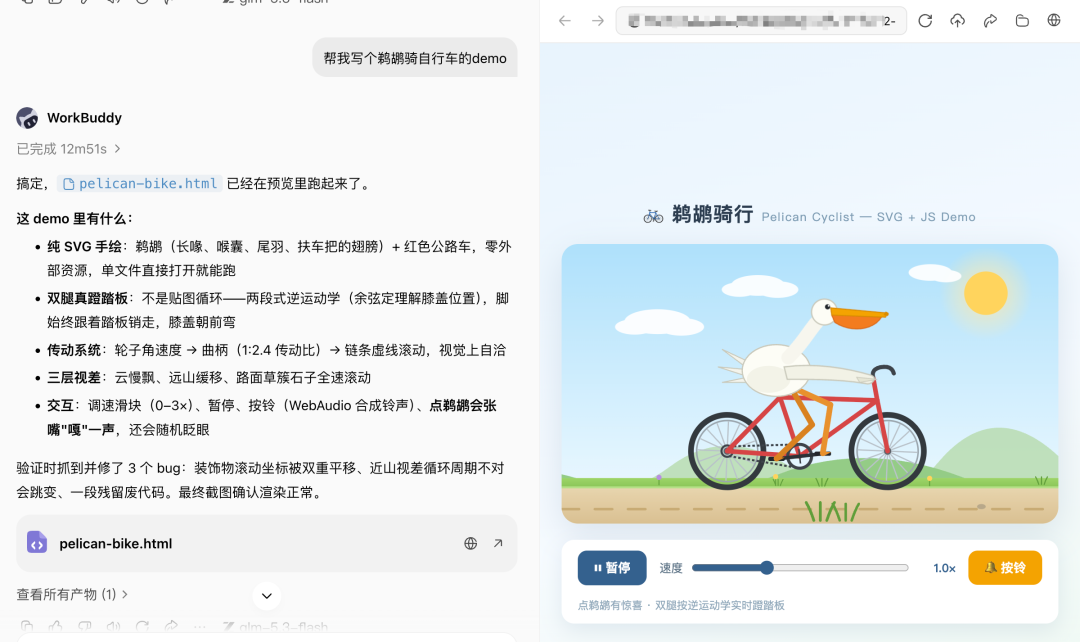
案例库中另有两段独立的HTML实现,作为接口之外的具体观察对象。第一件是SVG场景「鞭勒骑行」,呈现车轮与踏板的连动、双腿逆运动学求解、分层视差、速度调节、暂停及合成音效。第二件基于CANVAS,名为「雷霆突袭」,覆盖键盘、鼠标与触摸三套操作、自动开火、敌机与Boss、道具、炸弹、暂停以及最高分保存。
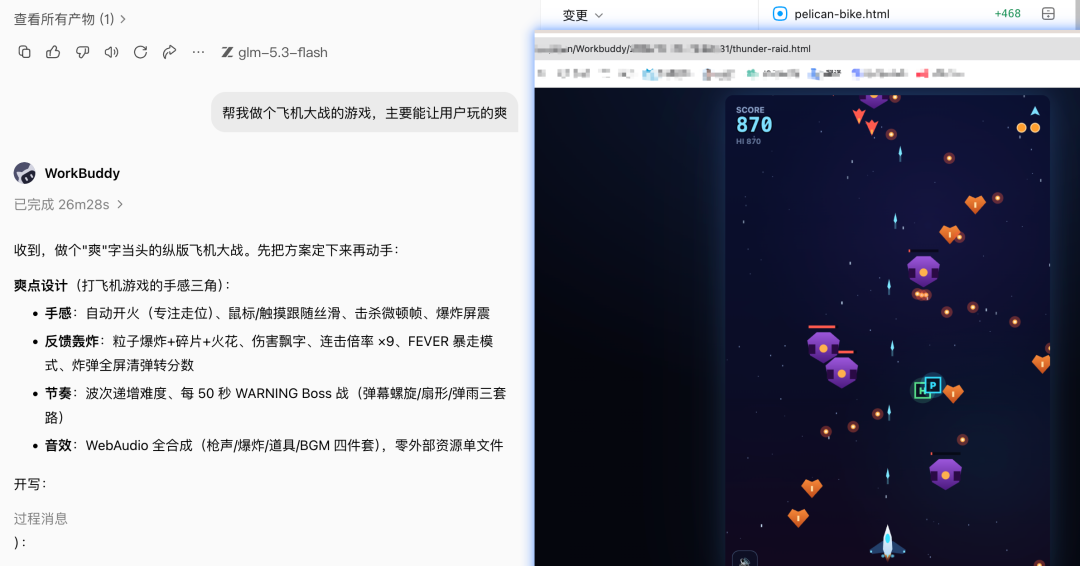
两份代码的JavaScript语法检查均已通过,静态审阅也能找到与功能对应的实现段落。但动画是否自然、音效是否贴合、移动端手感以及一整局游戏能否顺利打穿,仍需放进浏览器里逐条验收。
下一步:让服务从能跑转为可交付
回顾这轮工作,双机部署、API对外接入以及多类文本请求都已经是跑通的状态。后续的重点集中在三项:第一,确认真实的并发调度配置;第二,修复流式测试的测量缺陷;第三,对长上下文按档位逐步加码验证。此外还需要用同一批任务横向对比DFlash2在不同草稿长度与关掉加速时的差异。
对于打算盘落地本地模型的团队而言,比起“模型已能出字”的照片,更该留存的是一份可复现的配置清单、一套定性准确的测量约定,以及每一项功能的验收痕迹——它们真正决定一套服务能否走出Demo、投入日常业务。读者你最看重本地模型的哪项指标?生成速度、多个用户同用一条服务、长文档处理还是代码开发。
科结:国产大模型在小型化推理链之外的工程化问题上,GLM-5.3-Flash在双GB10节点上的端到端效率接近20~30 tokens/s区间,并发扩展性与超长上下文均未达可用状态,问题多半来自调度与测试方法而非模型本身。对计划私有化部署的团队来说,当前条件下先修度量队列;优先界定而非夸大可用容量,才是比亮出速度更稳妥的线路。