每次新建一个对话窗口,昨天的需求、上周的方案、上月踩过的坑,AI 统统想不起来。GitHub 上一款名为 claude-mem 的项目正是盯着这个痛点做的:截至 2026 年 11 月 2 日,仓库已积累 109000 多颗星,长居趋势榜,团队还为它单独搭了文档站,README 覆盖 30 种语言,其中简体中文是内置选项。项目以 Apache 2.0 协议完全开源。
它要解决的问题一句话能说完:让 AI 记住你。而这句话背后的设计,要比字面看起来复杂得多——不少用户天天忍受 AI "没有记性",久而久之反倒麻木了。
问题:每次会话都从零开始,用户还在替 AI 记着"它忘了什么"
眼下的 AI 编程助手与对话助手都按会话运行:新窗口即新上下文,窗口一关,沟通过的内容随之消失。
典型场景是这样的:前一天你和 AI 用两小时把一个项目的技术栈、目录划分和若干陷阱讲清楚,次日打开新窗口继续,它却毫无印象,于是你只能复述一遍(项目用的什么框架、模块怎么切、上次那个问题怎么解)。一次五分钟,十次就是一小时。更累人的隐蔽成本是——用户得自己记住"哪些背景已经交代过",这层负担每个重度用户都在默默承担。
一旦漏讲某段背景,AI 便会按自己的假设推进,产出一批语气笃定但实际有误的结果,用户还得额外花精力判断哪里出了问题。原文作者的总结是:这个时代最大的浪费不是模型不够强,而是每次对话都重新起跑。
机制:像会议记录员一样"旁听—压缩—归还",全程自动
claude-mem 的路线并不玄妙,可以理解为给 AI 配了一位不间断的速记员,流程分三步。
第一步旁听:在 AI 工具内部布设若干钩子,覆盖会话启动、用户提问、AI 调用工具、任务收尾等节点。AI 动了哪些文件、你做了什么决策,均被留存。
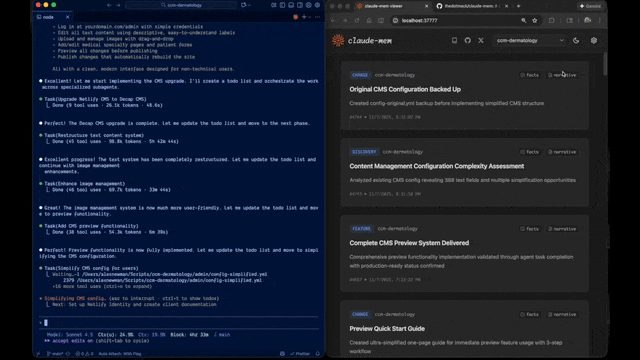
第二步压缩:原始流水既长又杂,原样保存下次无法使用,于是它调用模型把内容提炼成一张张小卡片,例如"11 月 2 日,放弃方案 A 转向方案 B,理由是性能未达标"。卡片几十字一条,信息却是可复用的。
第三步归还:下次开启会话时,先悄悄把相关卡片注入上下文。用户无需任何操作,AI 一开口就清楚上周推进到哪一步。整套流程无需人工干预,装好即可放置不管。
在同类"AI 记忆"项目中,claude-mem 有几点设计值得一提。其一是省 token:若检索时把全部记忆一次性拉出,额度消耗极快;它采用三层检索,先花几十个 token 取得目录,命中目标后再展开细节,官方称这套机制大约可节省 10 倍 token。这一思路与近期流传的 DeepSeek 架构分析一致——上下文窗口属于稀缺资源,需精打细算。其二是本地化:记录落在用户自己电脑的 SQLite 数据库中,检索依托本地向量库与关键词的混合方案,不依托云端;对隐私敏感者,还可通过专用标签把特定内容排除在存储之外。其三是对用户透明:内建本地面板,能直接查看 AI 记住了什么、每条记录产生的时间,不满意可删除。另有一处容易被忽略——它内置简体中文模式,记忆卡片可直接以中文生成,检索同样对中文友好。
兼容面也较广,Claude Code、Codex、Gemini、OpenCode 等主流编程助手均可安装,一套记忆可随用户更换工具而延续。Claude Code 用户在插件市场执行两行命令、重启即生效;其他工具用户只需一条安装指令,依赖、钩子与后台服务会被自动配置好,重启后上一会话的内容便出现在新会话中。运行环境要求 Node 20 及以上,缺失依赖会自动补齐。首次运行会提示登录账号,对应其托管记忆服务,提供 30 天免费试用;不感兴趣可跳过,此后记忆功能消耗用户自有模型的额度,本地记录不受影响。具体命令见原文评论区置顶。
注意:免费开源+付费托管,安装入口别走错
原文明确列出三点提醒。其一,商业模式为开源免费加托管增值:本地记忆不收费,托管记忆与增强能力在试用期结束后需订阅;不愿付费者可改用自有模型额度,功能并非残缺,但要有合理预期。其二,安装必须遵循官方文档给出的命令,若直接 npm 全局安装,装上的是开发库,钩子与后台服务不会被配置。其三,README 中存在一个少见角落——项目方公开接纳了某个第三方社区代币,属加密货币玩法;工具本身开源免费,与代币并无关系,遇到相关推广时需保持警惕,别把两者混为一谈。
更大的背景:比拼维度正从"答得快"转向"不必从头再来"
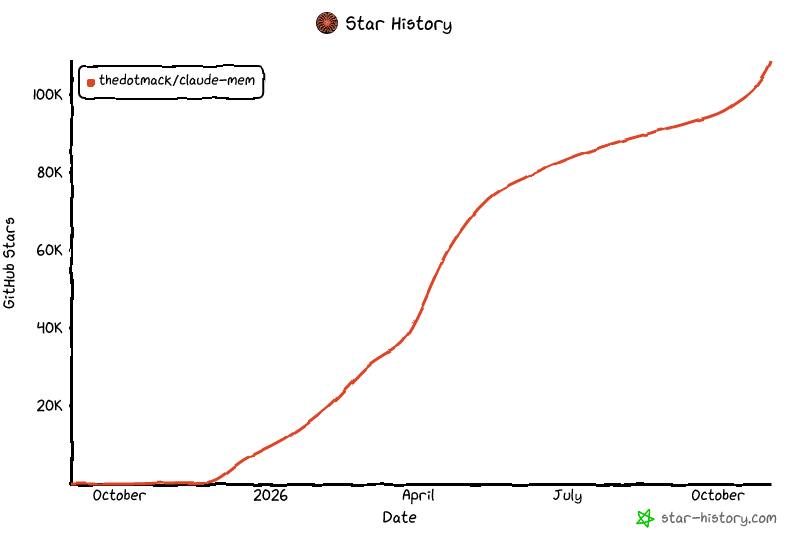
回看近两年 AI 工具的竞争轴线:先比回答是否准确,再比响应是否迅速,今年比的是能否真正把活干完。claude-mem 的走红提示下一个维度已然浮现——谁能免去重复交代的成本。原文还提到,大厂同样在攻这个方向,DeepSeek 日前发布的 Super-agent 架构中专门设计了全局记忆层,但距离普通用户仍有一段路。面向个人侧的解法,很可能就是 claude-mem 这类工具:一行命令,让 AI 不再每次见面都像初见。据 star-history.com 的曲线,该项目一年内积攒出 11 万星。
小结:claude-mem 用钩子旁听、卡片压缩、会话回填这三步,把"跨会话记忆"做成可自动运行的基础能力,并以三层检索把 token 开销压到官方所称的约十分之一。对频繁使用编程助手的开发者而言,它提供了本地优先、可审计的记忆方案;但在安装入口、托管付费与第三方代币三件事上需保持清醒。模型会迭代、工具会更换,唯有积累下来的记忆属于用户自己——这大约是那 11 万颗星最朴素的注解。
GitHub 仓库:thedotmack/claude-mem;官方文档站:docs.claude-mem.ai