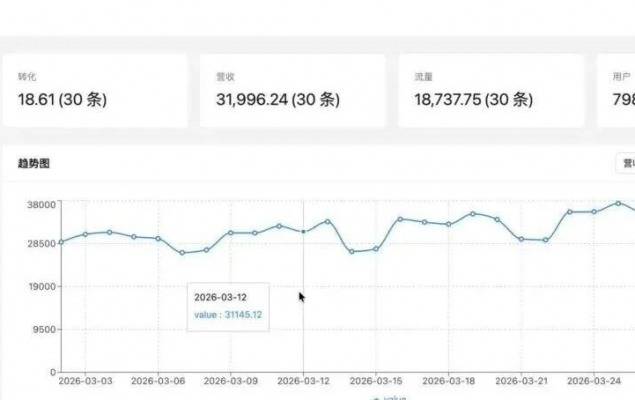
GLM-5.1上线即售罄,定位补齐编程长程任务短板
智谱于上周低调上线新模型GLM-5.1。作为国内头部大模型厂商,智谱的GLM系列长期在coding方向投入,而5.1这一代的目标十分明确——攻克此前没有模型能够胜任的任务。据原文信息,发布当日GLM Coding Plan便已卖断货,补货页面出现排队。
在很长一段时间里,用AI写代码的体验更接近带一名实习生:交代一步执行一步,任务一旦变复杂就容易丢失前文要求,或在修改中破坏其他部分,开发者必须全程盯守、频繁纠正,有时索性自己重写反而更快。作者坦言,这也是“AI取代程序员”喊了两年却始终难以兑现的原因所在。
实测:一份需求文档换来一次完整项目交付
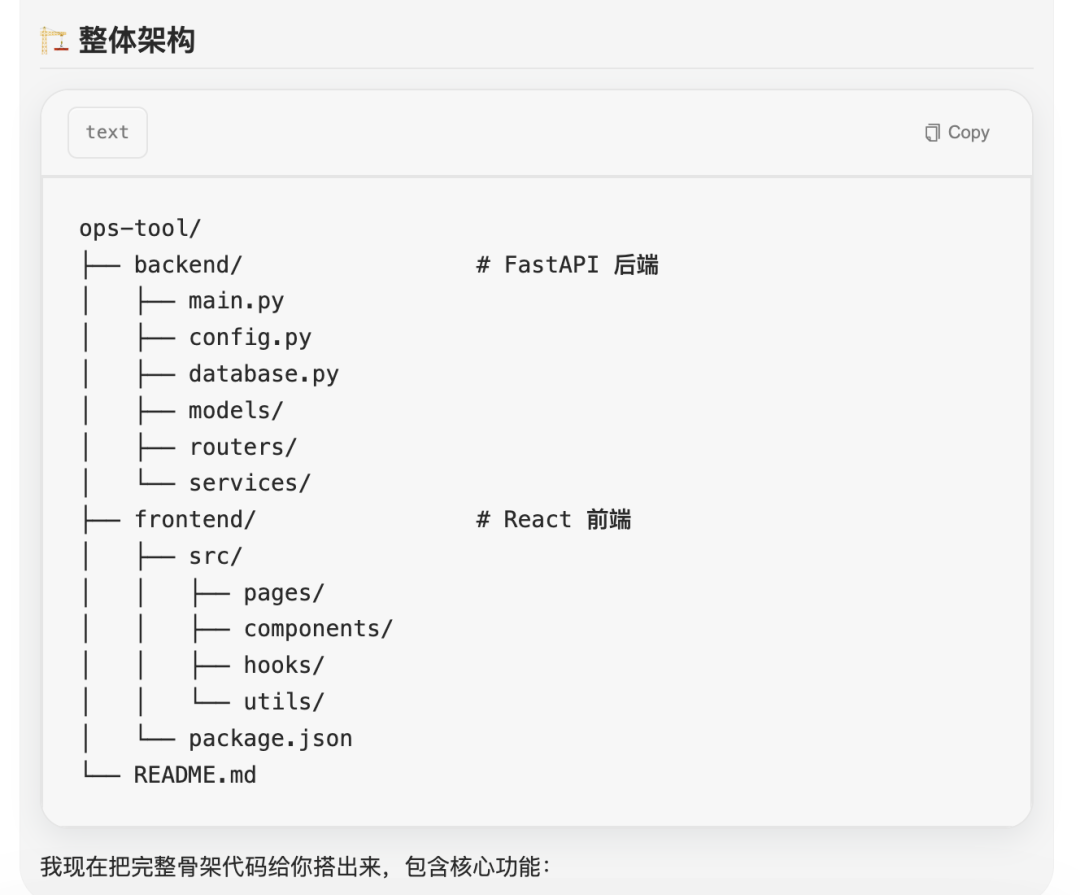
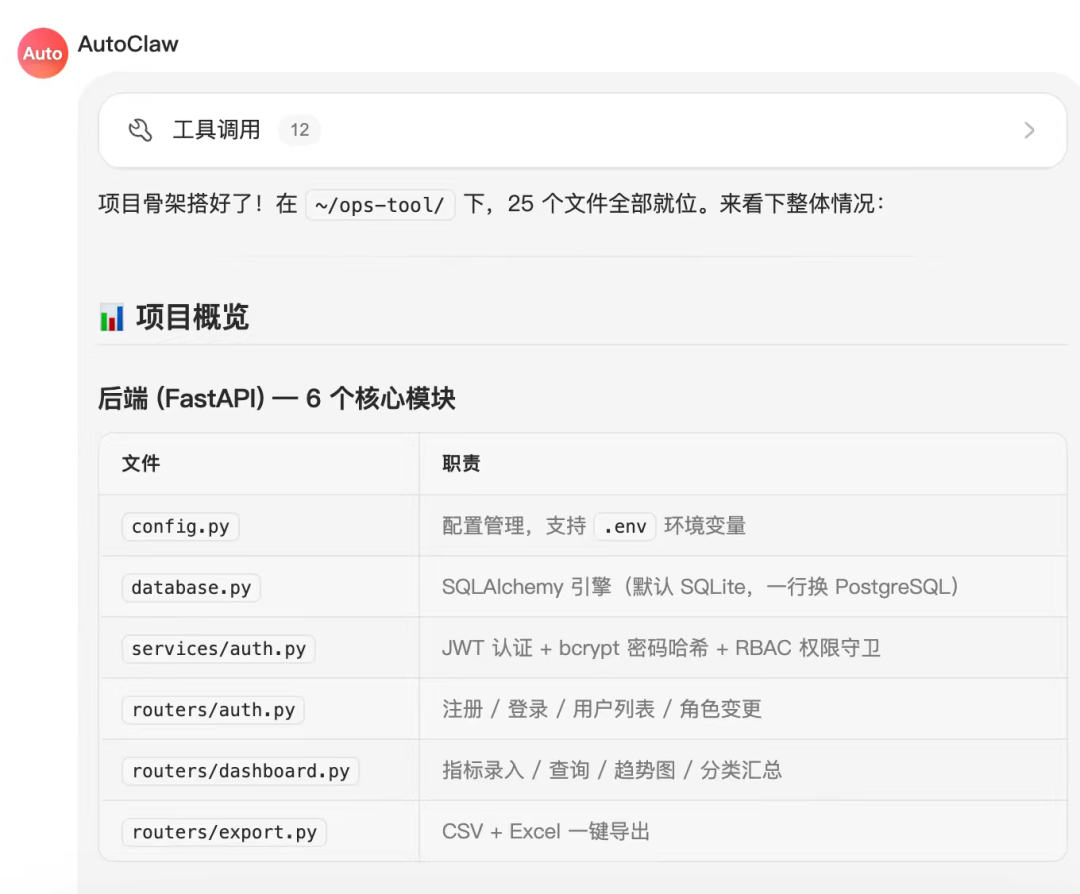
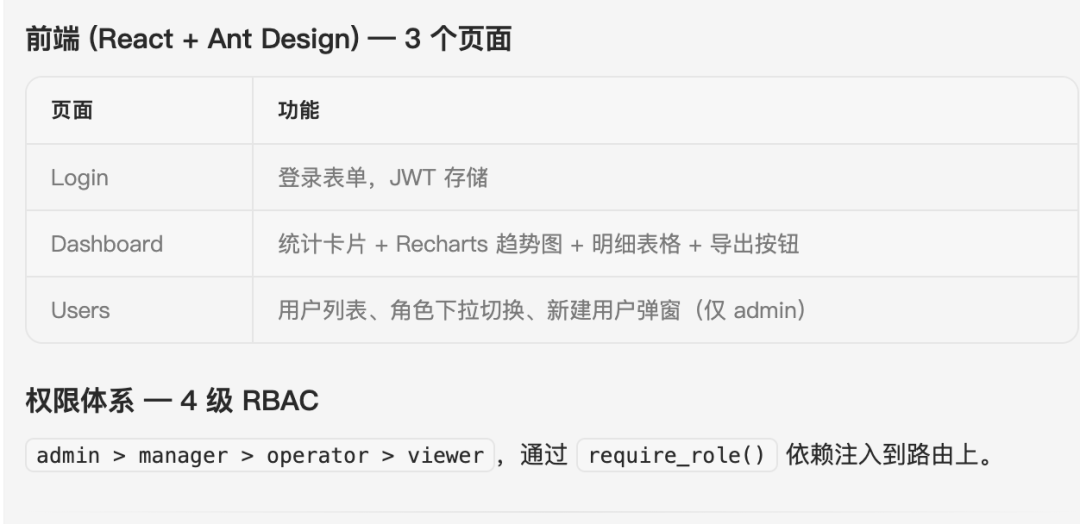
作者把一个内部运营工具的完整需求直接投喂给GLM-5.1,未做任何任务拆分。该工具需要用户权限体系、数据看板以及导出功能,后端采用FastAPI,前端使用React——按以往做法,他会切成七八个子任务逐个提交给模型。
GLM-5.1并未立刻动手写代码。它先用大约两分钟产出一份技术方案,列出项目结构、模块依赖关系与开发顺序,并向使用者确认是否有不同意见。随后模型自行推进,每个阶段完成后在内部记录当前进度再进入下一步。当开发进行到第四步时,JWT鉴权与异步任务调度之间存在一处接口设计冲突,模型自己识别并完成了修复,全程没有提示使用者。
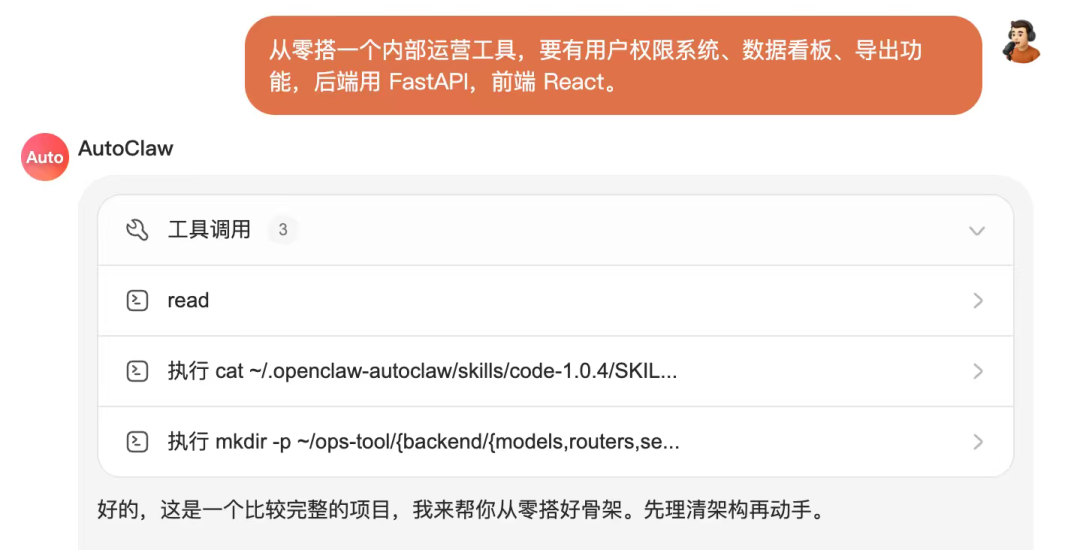
整个过程中作者没有介入,代码最终顺利跑了起来。原文给出的判断是:这种体验与过去使用模型的感受“完全不同的量级”。
社区实测接力:游戏克隆与行业手册都能一次交付
类似反馈不止来自作者本人。GLM-5.1发布后,社区出现了一波实测潮。一位从事游戏开发的用户连夜用该模型做出了可交互的网页版《我的世界》,镜头移动流畅不卡顿,未探索区域也能实时生成——这类工作过去需要一支小团队,他一个人用了一晚上完成。
另一位用户将一批灵巧手研究资料输入GLM-5.1,得到一本格式完整、分章符合阅读逻辑的行业手册,其本人在原文中的评价是“远超预期”。这些案例的共同点是:不只是问答或单一内容生成,而是交付了一个完整成果。
Long Horizon是什么:长时间跨步骤执行且自修复
这些表现背后是名为Long Horizon的能力,指AI能否在一个持续数小时、跨越十几个步骤、中间不断出岔子的完整项目中,维持目标一致、自主向前推进并在出错时自行修正。原文指出,此前的模型做不到这一点,上下文一长就会偏离,方向一变就会迷失。智谱GLM-5.1是国产模型中较早认真投入Long Horizon方向的一批。
跑分:45.3分逼近Claude Opus 4.6,BrowseComp跑赢GPT-5.2
数据层面,在Claude Code框架下的Coding Agent测试中,智谱GLM-5.1取得45.3分,相比上一代GLM-5的35.4分提升接近10分,与全球最强编程模型Claude Opus 4.6的47.9分仅有2.6分差距。原文认为,这个数字不只是一个排名:从GLM-5到5.1,智谱用了一个多月时间,迭代速度说明这并不是一次性的跳跃,而是一个仍在加速的方向。
另一项BrowseComp(多步网页操作记忆)测试中,GLM-5拿到75.9分,高于GPT-5.2的65.8分与Claude的67.8分。原文对这两项测试的共同点作了总结:考的都不是能否答对某道题,而是能否在连续行动中保持状态不出轨,这正是Long Horizon的核心所在。
整合者角色被触及,“脑替”与护城河之问
作者原本相信,拆任务、定方向、做判断的位置始终稳固——过去AI只能处理碎片,拼接碎片的人就是整合者、决策者与项目管理者。但用GLM-5.1完成项目后,他意识到模型已经开始自己拆任务、自己定方向、自己做决策。原文的表述是:过去AI替代的是手,现在它开始替代脑。
原文同时强调,这并不意味着程序员立刻失业,只是有一条界线刚被悄然越过。整合者之所以安全,是因为AI只会做片段;一旦它具备做整体的能力,这个前提就失效了。作者随后列举三层护城河:写代码的能力正在被追平;管项目的能力刚被突破;定义问题与做价值判断暂时仍是壁垒,但并非永久。原文诚实写道“我没有答案”,只是认为这个问题现在值得认真对待。
据原文内容,关于GLM-5.1的Long Horizon突破与整合者位置受到的冲击,目前尚无进一步结论。