真正把英伟达芯片运算能力推到物理极限的,并非千亿参数的巨型模型,而是一段仅有几百行、外观极其普通的底层代码。
开源周第三天:DeepGEMM只用了约300行计算逻辑
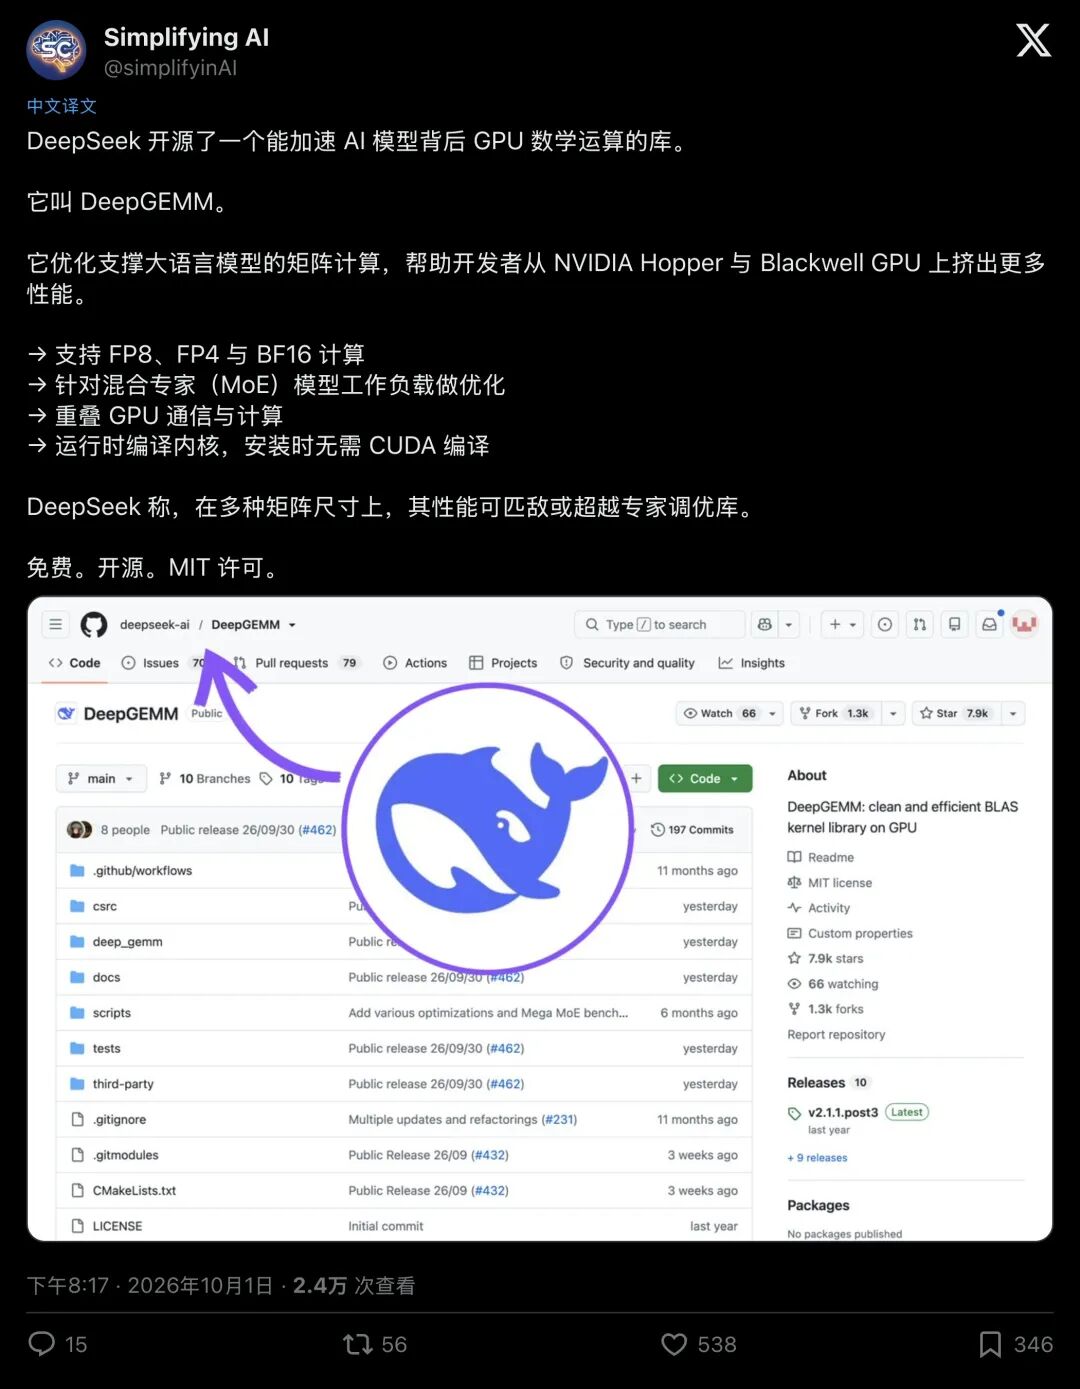
时间回到2025年2月26日,DeepSeek的“开源周”活动进入第三天。全球开发者原本以为这家公司会继续发布重量级模型参数,结果DeepSeek在GitHub上线了一款相对冷门的算子库,名为DeepGEMM。
官方介绍语气颇为平静地指出,这款库的核心计算部分大约只有300行代码。它不引入沉重的外部依赖,完全借助运行时的即时编译(JIT)来生成执行。在英伟达高端GPU上,它达成了超过1350 TFLOPS的浮点吞吐表现,直接压过了英伟达自己提供的专家级内核。
围绕这一发布,技术圈讨论热度迅速攀升。有人在关注纳斯达克行情时开玩笑说,连续三天都看着自己的英伟达股票被架在火上烤。
进入2026年,这套代码并未停止迭代,反而像一头持续工作的工程巨兽,从最初的FP8一路扩展到FP4与BF16,同时拿下英伟达Hopper和Blackwell两代硬件架构,不断向更底层的算力极限发起挑战。
矩阵乘法就是大模型的心脏,而硬件强不代表能喂饱它
要理解DeepGEMM的价值,需要先看看人工智能的“发动机舱”。无论是ChatGPT、Claude还是DeepSeek,它们在写诗、编写代码或做逻辑推理时,抛开高层的数学表达,底层其实一直在反复执行同一类运算:两个大型矩形数字矩阵彼此相乘,再把结果写进第三个矩阵。
在计算机科学中,这套操作被称为GEMM,即通用矩阵乘法。如果拿重型卡车来打比方,大模型推理就是那辆卡车,而GEMM相当于发动机里活塞的往复冲程。大模型超过九成的电费开支和芯片占用时间,都消耗在这些矩阵相乘上。英伟达能够在芯片领域占据主导,关键原因也在于它的GPU里填充了专门为此类运算设计的张量核心(Tensor Core)。
不过,硬件本身强劲,并不意味着就能充分发挥。过去业界主要采用英伟达官方的CUTLASS等底层库,这类库虽然功能齐全,但代码结构极其庞大复杂,一眼望去全是数十万行难以理解的C++模板。开发者如果想针对某个特定矩阵形状做优化,单是编译流程就可能让人等到失去耐心。
DeepSeek的工程师做了一项非常大胆的决定:去掉所有不必要的包装。他们选择用纯CUDA代码直接与硬件的晶体管打交道。核心逻辑被压缩到300行左右,并搭配自研的即时编译器(DeepJIT)。部署时无需经历漫长的全局编译过程,模型在执行中遇到什么样的矩阵形状,内核就现场编译,直接命中硬件缓存。
除此之外,他们还在精度上做了大胆下探。传统计算一般使用16位浮点数,也就是FP16或BF16,而DeepGEMM从一开始就面向8位(FP8)乃至4位(FP4)精度来构建。这就好比把原先用来搬运精细量杯的运输方式,替换成了运输高密度砖块:数据体积缩小到原来的一半甚至四分之一,显存带宽瓶颈被彻底解开,算力吞吐随之成倍释放。
把矩阵转置过来计算,推理速度为何能跃升约五成
如果说精简代码和低精度计算尚且属于正常的工程演进,那么DeepGEMM在最新一代Blackwell架构上的做法,则几乎是在挑战常识。
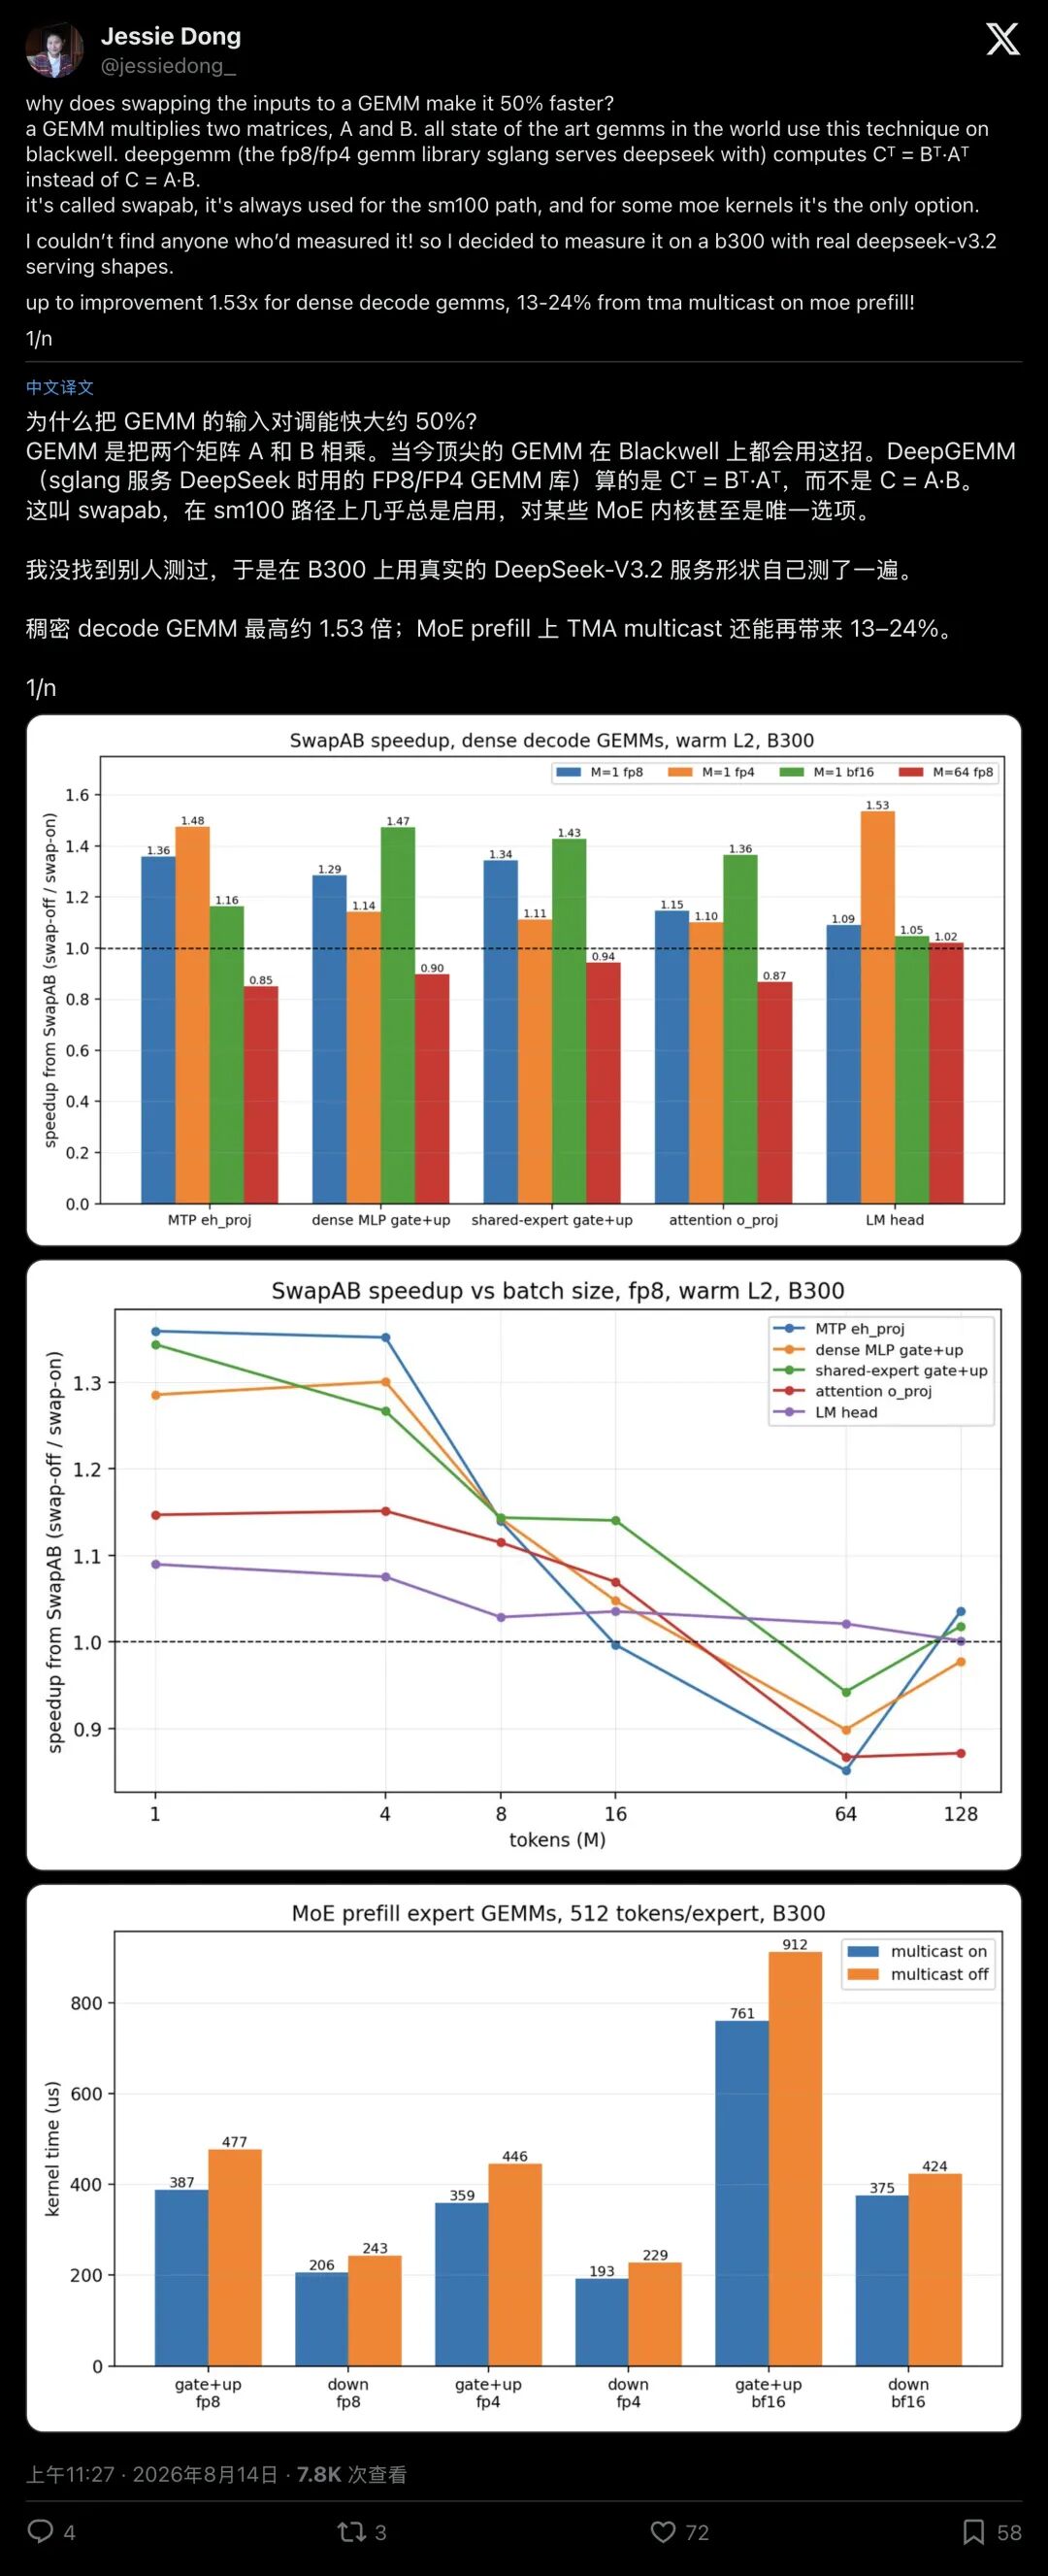
2026年8月,技术工程师Jessie Dong在社交平台上发布了一条长帖,提出一个让许多同行感到困惑的问题:为什么在矩阵乘法中把输入的两个矩阵互换位置,执行速度就能马上提高50%?
从中学数学的角度,A乘以B通常并不等于B乘以A。但在矩阵代数中,存在一个等价转置公式:C的转置等于B的转置乘以A的转置。计算结果经过转置后数值完全一致,可DeepGEMM偏偏不走那条直接的A乘B路线,而是选择在英伟达最新的Blackwell架构上强制使用这套被称为SwapAB的倒转方式。
原因藏在硬件本身的物理短板里。英伟达新的SM100架构张量核心就像一个严重偏科的巨人,其硬件指令在两个计算维度(M轴与N轴)上的吞吐能力并不对称。
当大模型实时为用户逐字输出内容,也就是进行Decode解码时,每次输入的Token数量非常少,矩阵某一侧会变得极为扁平。如果按常规方式把这条短边送入原本就比较僵硬的硬件通路,芯片里多达八分之七的计算资源就会白白闲置,原地空转。
DeepSeek的内核工程师精准抓住了这个硬件痛点:既然通路有偏好,那就先把矩阵调转方向再送进去。原本瘦小的Token维度被安排到硬件处理效率最高、最宽的通道上执行;等GPU以最大火力完成运算后,再在写入显存的环节顺便转置回来。
Jessie Dong基于真实DeepSeek-V3.2推理尺寸在B300芯片上实测,在稠密解码场景下,性能一举提升到原来的1.53倍;在长文本预填充阶段,如果再结合异步多播技术,还能额外获得13%到24%的加速。这背后并无玄学,靠的是对硬件结构的深入把握,从每一块晶体管的空隙中榨取性能。
百万长文本场景的雷达兵:把显存带宽开销压到最低
当大模型广泛进入128K乃至数百万Token的超长上下文阶段,注意力计算暴涨成为一个新的物理难题。全量注意力机制的计算量会随上下文长度呈几何级增长。如果每次生成回答都要对几十万字的历史记录重新做一次昂贵的点积和Softmax归一化,显存带宽会立刻被拖到极限。
为突破这一僵局,DeepSeek在模型中前置了一个名为Lightning Indexer(闪电检索器)的侦察结构。其思路是,在启用昂贵的全量注意力算力之前,先派出一个轻量的“雷达兵”,采用低维度的多查询注意力(MQA),快速扫过海量历史文本,挑出真正高度相关的上下文片段。
而DeepGEMM,相当于专门为这个雷达兵打造的超轻量引擎。为了把开销压到最低,它在相关算子中省去了所有多余步骤:第一,丢弃成本高昂的Softmax,在完成点积后直接在硬件上就地执行轻量线性修正单元(ReLU)并乘以权重;第二,压缩输出(Compressed Logits),在2026年9月底的PR #462重构中,算子不再生成带大量无效补零的稀疏大矩阵,而是直接输出高度压缩的紧凑数组,不浪费任何无意义的显存带宽;第三,也是关键一点,反量化、矩阵相乘、ReLU激活和多头归约全部在一个内核中一次性完成,绝不让中间结果回写到慢速显存。
通过把多个计算步骤融合在一起,该算子在维持极致精简的同时显著减少了显存往返开销,让长文本推理的底层运行更为敏捷顺畅。
算力来自对代码的极致压榨:门槛高,但价值也高
到2026年秋季,伴随一系列重要更新完成合并,中文互联网和海外社交平台上又出现戏剧性的一幕。部分自媒体开始制作夸张标题,诸如“装上DeepSeek这个新库,Token账单立刻便宜98%”“从50美元骤降到1.6美元”之类的说法不断冒出。
技术圈内的工程师随即澄清:DeepGEMM是专属于模型底层的重工业级机床,普通用户无法直接依靠它减少日常对话的开销。
它的使用条件相当苛刻:需要持有英伟达SM90(Hopper)或SM100(Blackwell)及以上的高端数据中心算力卡,配齐CUDA 12.9以及支持C++20的编译环境,同时还要自行搭建底层推理框架。一旦传入的矩阵形状有误,或者缩放因子的内存排布出现细微偏差,它的性能就会急剧回落。
但正是这种高门槛,凸显了DeepGEMM最具冲击力的工程价值。长期以来,硅谷大型企业习惯了用大量资金构建“算力护城河”——芯片不足就购买,显存不够就堆叠;在软件层,许多厂商把底层实现严密隐藏,对外只给一个黑盒式的API。DeepSeek却走向相反方向。
从2025年开源周的那300行代码,到2026年把通信与计算深度整合的Mega MoE——后者在高负载状态下可以直接为整机节省100瓦电力,并把GPU频率推高10%——DeepSeek实际上是在把大模型最底层的“图纸”完整摊开,展示给全世界。
它通过扎实的工程实践向行业说明一个结论:算力壁垒建立在极致的代码数学功底和对底层架构的洞察之上,只有钻入微米级的芯片逻辑,才能把每一分硬件性能压榨出来。大模型的物理极限仍在被不断推高,而这群底层代码极客的深水区探索,现在还只是开始。
小结:DeepGEMM用约300行核心代码在英伟达Hopper与Blackwell平台上实现超过1350 TFLOPS的浮点吞吐,并通过SwapAB转置在解码场景提升1.53倍、长文本预填充加速13%至24%。它说明算力差距并非只能靠堆芯片填补,对硬件架构与数学计算的极致把握,同样能把GPU性能挖掘到新的高度。