国内软件11月01日
两台H3C MegaCube跑GLM-5.3-Flash:短文本仅17~29 tokens/s,256K上下文未被验证
实测表明,在2×GB10/128GB的H3C MegaCube上以TP=2部署GLM-5.3-Flash NVFP4,短文本端到端输出仅17~29 tokens/s,四并发吞吐仍约…
「tokens/s」 共找到 5 条相关资讯
实测表明,在2×GB10/128GB的H3C MegaCube上以TP=2部署GLM-5.3-Flash NVFP4,短文本端到端输出仅17~29 tokens/s,四并发吞吐仍约…
智谱GLM-5.3-Highspeed在Zcode 3.15.1随机灰度上线,网友@leo114119晒出490 tokens/s的生成速度,接近500TPS。该模型已被Pi模型目…
量子位转述网友实测GLM-5.3-Highspeed约490 tokens/s,但测试条件待确认;华为诺亚方舟等团队Memento 3在183个关卡中操作次数比人类少约56%;掘金…
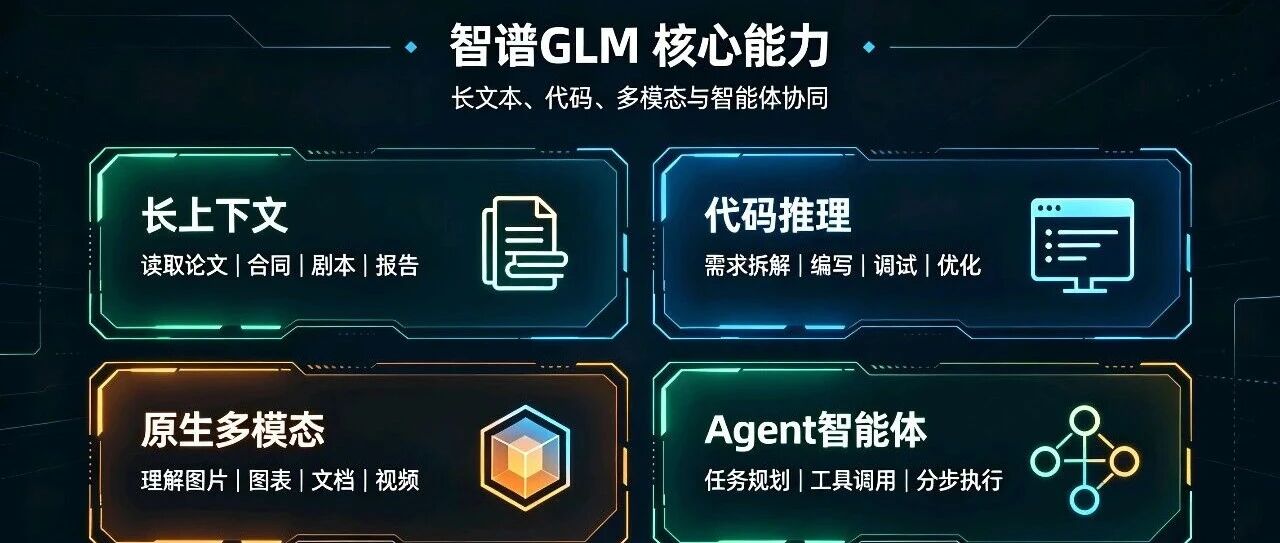
智谱GLM-5.3编程能力较前代提升50%,支持200K上下文窗口,原生多模态版本GLM-5.3-FlashX推理速度最高可达200 tokens/s,开源模型累计下载量已突破20…
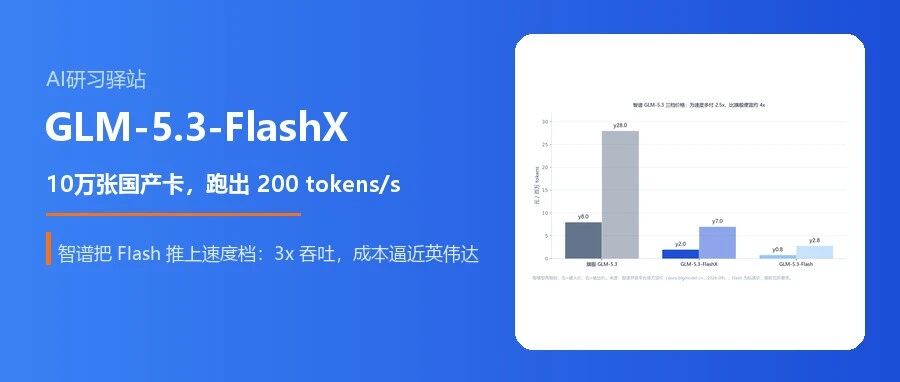
智谱在API与体验中心上线GLM-5.3-FlashX,这是8月26日开源的GLM-5.3-Flash的高速推理档,峰值约200 tokens/s。它依托约10万张国产AI加速器自…