AI 与大模型10月02日
同是全栈开发任务,Flash小模型6.26元对阵旗舰80.49元差12倍
雷峰网实测显示,同一从零开发的全栈任务,Qwen3.8-Flash花费6.26元、GLM-5.3-Flash花费7.72元,而旗舰GLM-5.3高达80.49元,差距10到13倍。…
「GLM-5.3」 共找到 38 条相关资讯
雷峰网实测显示,同一从零开发的全栈任务,Qwen3.8-Flash花费6.26元、GLM-5.3-Flash花费7.72元,而旗舰GLM-5.3高达80.49元,差距10到13倍。…
雷峰网实测同一个全栈开发任务,Qwen3.8-Flash花费6.26元、GLM-5.3-Flash花费7.72元,而旗舰GLM-5.3高达80.49元。2025年9月国产厂商密集更…
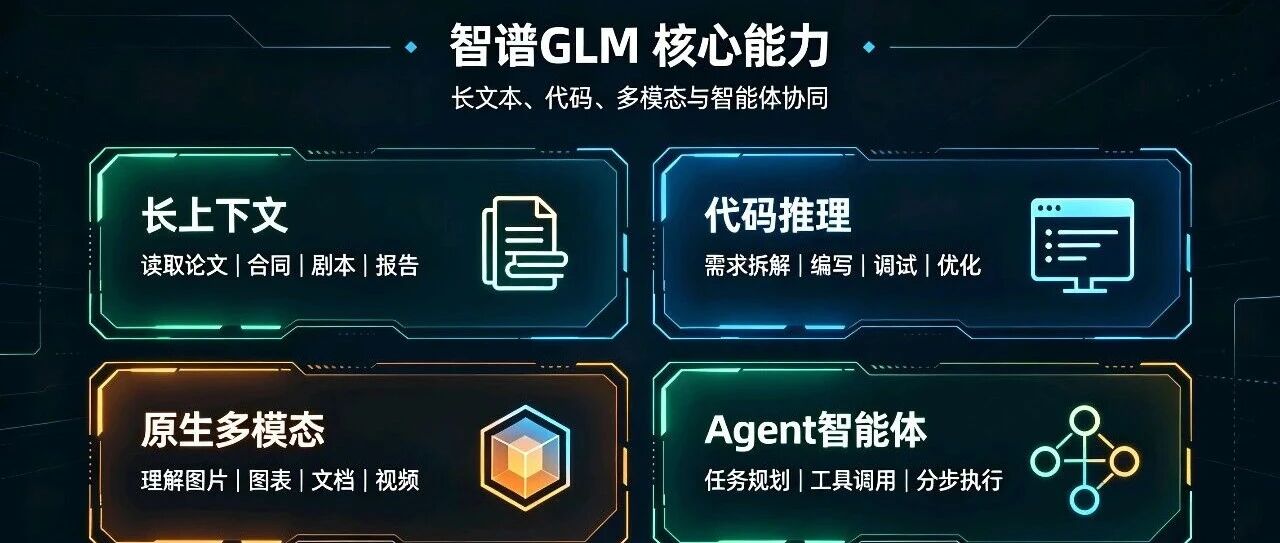
智谱GLM-5.3编程能力较前代提升50%,支持200K上下文窗口,原生多模态版本GLM-5.3-FlashX推理速度最高可达200 tokens/s,开源模型累计下载量已突破20…
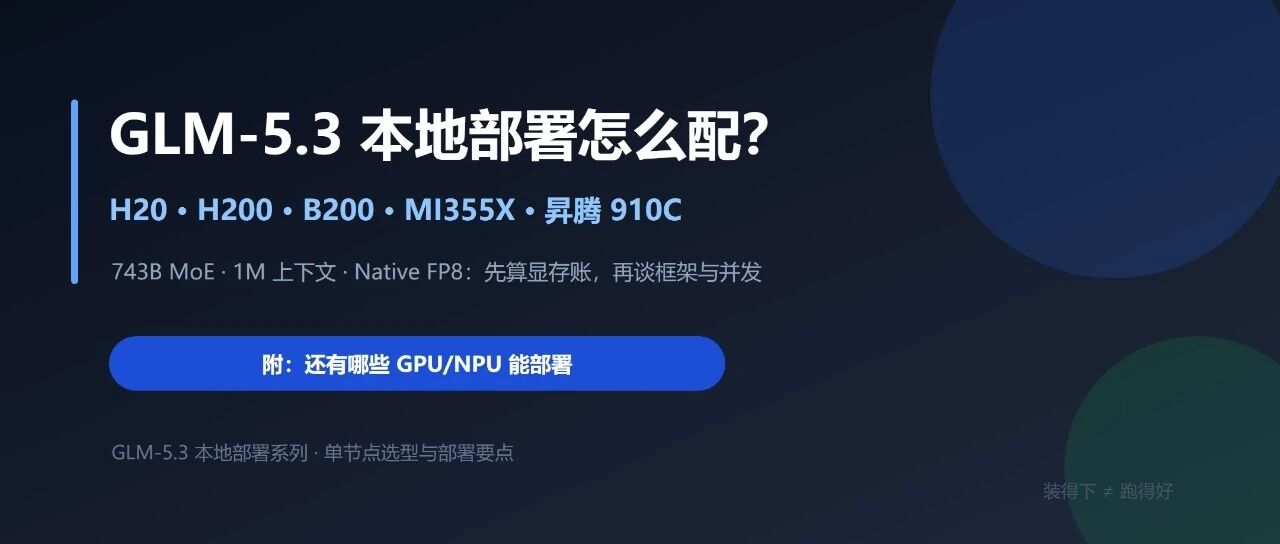
GLM-5.3权重开源后,本地部署的关键不在"几张卡",而在显存版本:96GB版8卡共768GB装不下756GB权重,141GB版才可行。本文算清H20、H200、B200、MI3…
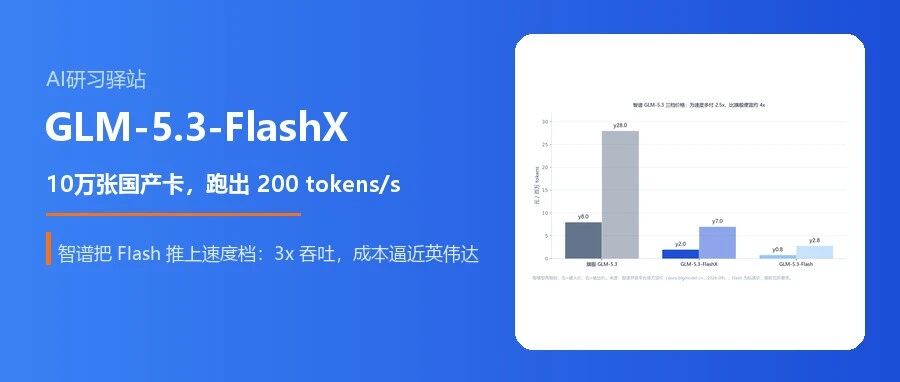
智谱在API与体验中心上线GLM-5.3-FlashX,这是8月26日开源的GLM-5.3-Flash的高速推理档,峰值约200 tokens/s。它依托约10万张国产AI加速器自…
智谱在9月24日推出ZCode中秋活动,用户注册并通过手机号与人脸识别实名认证后,可领取GLM-5.3-Flash的3亿tokens额度,实测截图显示额度已到账控制台,邀请好友还可…
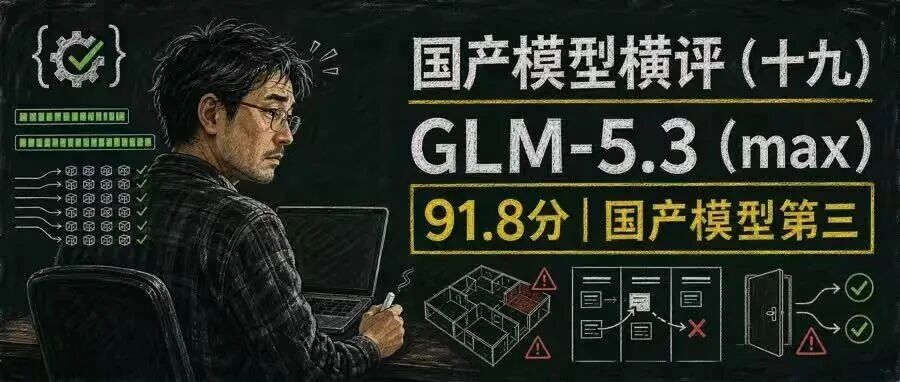
GLM-5.3(max)在v2.0评分口径下拿到1101/1200分、展示分91.8分,位列国产模型第3,较GLM-5.2提升2.3分。C++库存服务与团队知识库题接近满分,但3D…
智谱开放平台的GLM-4.7-Flash与GLM-4.6V-Flash为常驻免费策略,但实测中9次请求有6次被429限流,单次竟等了89.2秒,长输出速率仅约9.3 tok/s,与…